服务器群集与负载均衡协同工作,本质上是把“多台服务器拧成一股绳”前者提供冗余算力池,后者负责把请求精准分配到最空闲的节点,两者配合能同时提升系统的可用性与性能。
集群与负载均衡的分工逻辑
服务器群集和负载均衡不是一回事,它们是两个层次的分工协作,理解这层关系,是搞懂高可用架构的第一步。
服务器集群:提供“人多力量大”的资源池
服务器集群的核心思想是把多台服务器组织成一个整体,它解决的是资源规模问题,单台服务器不管配置多高,总有物理极限CPU算力有上限,内存容量有上限,网卡带宽也有上限,集群把这些单点能力叠加起来,形成更大的算力池。
但集群本身不负责“怎么分配任务”,如果没有分配策略,多台服务器就像一堆没人指挥的工人,活儿来了不知道该谁上,这就是负载均衡要解决的问题。
负载均衡:充当“智能调度员”
负载均衡的核心职责是决定每个请求该去哪个节点,它持续监控集群内各节点的健康状态和负载情况,按照预设策略(轮询、最少连接、IP哈希等)把请求分发到最合适的节点。
一个形象的比喻:集群是“蓄水池”,负载均衡是“水闸”,蓄水池决定总蓄水量,水闸决定每次放多少水、从哪个出水口放。
两者缺一不可的协作关系
- 只有集群没有负载均衡请求进来后无从选择,可能出现部分节点超载、部分节点闲置,集群容量发挥不出来
- 只有负载均衡没有集群调度员手里只有一台机器,再怎么调度也突破不了单机上限
- 两者结合负载均衡“看全局、做决策”,集群“按指令、扛压力”,系统才能又稳又快
高可用性如何被双重机制保障
高可用性(SLA 99.99%)靠的不是某台服务器不宕机,而是整个系统能在部分节点故障时继续对外服务,这需要集群和负载均衡各管一段。
集群层的故障容忍机制
在集群层,关键机制是健康检查与自动摘除,每台服务器定期向负载均衡器上报心跳信号,负载均衡器也会主动探测节点的存活状态,一旦某台节点响应超时或返回错误码,负载均衡器立即停止向它分发新请求这在业内叫“摘除节点”。
被摘除的节点并非彻底放弃,以常见的Nginx Plus为例,它支持主动健康检查,配置了max_fails和fail_timeout参数后,连续几次失败就会把节点标记为不可用,节点修复后,负载均衡器通过再次探测确认恢复,才把请求重新引流过去。
负载均衡层的冗余部署
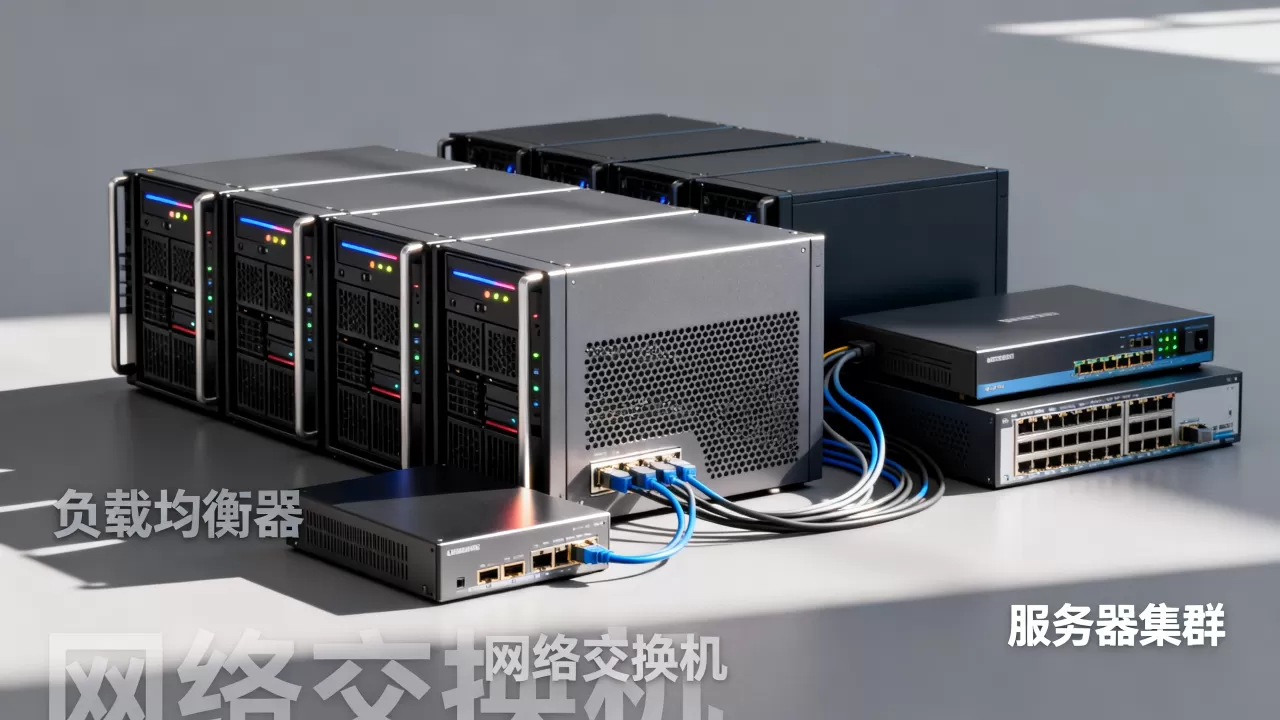
负载均衡器本身也可能宕机这就成了新的单点故障,解决思路是对负载均衡器再做一层集群。
常见做法是采用Keepalived实现VRRP协议,部署一主一备两台负载均衡器,主设备故障时备设备在秒级时间内接管虚拟IP,此时整个链路是:用户请求到虚拟IP → 主负载均衡器 → 后端集群节点,任何一个环节断了,都有备用方案顶上。
会话保持与故障转移的平衡
高可用还要处理一个棘手问题:会话保持,用户登录后,请求如果被分发到不同节点,可能导致登录状态丢失。
行业常见方案有两种:
- 会话粘滞:负载均衡器按用户标识(如Cookie中的Session ID)把同一用户的请求固定分发到同一节点,保证会话一致性
- 会话共享:把会话数据放到外部存储(如Redis),所有节点从同一地方读写会话,节点宕机后其他节点无缝接管
两种方案各有适用场景,多数中型系统优先选择会话共享,因为节点故障时不需要重新登录。
性能提升背后的资源调度智慧
集群提供容量,负载均衡决定容量利用率。同样一批服务器,调度策略好不好,性能差异可能是成倍的。
策略选型直接影响响应速度
- 轮询:请求依次分发到每台节点,适合各节点配置相同、请求处理时长相近的场景
- 最少连接:实时统计每台节点的活跃连接数,把新请求分给连接数最少的节点,适合请求处理时长差异大的场景
- 加权轮询:给配置高的节点分配更大权重,让“能者多劳”,适合集群内存在异构服务器的场景
- IP哈希:按客户端IP计算哈希值,同一IP始终访问同一节点,适合需要稳定连接的场景
一个典型场景:集群里有4台4核8G服务器和2台8核16G服务器,如果用了简单轮询,性能较好的两台服务器和大机器承担一样的请求量,资源就没有最大化利用,改用加权轮询后,8核机器权重设为2,4核机器权重设为1,整体吞吐量能明显提升。
连接复用与协议优化的实际效果
现代负载均衡器(如Nginx、HAProxy、Envoy)普遍支持连接复用,所谓连接复用,是指负载均衡器与后端服务器之间维持长连接,而非每个请求都新建TCP连接,建立TCP连接本身要经历三次握手,高并发场景下这是很大的开销,复用连接后,后端服务器能省出一部分资源专门处理业务逻辑。
弹性伸缩中的动态协同
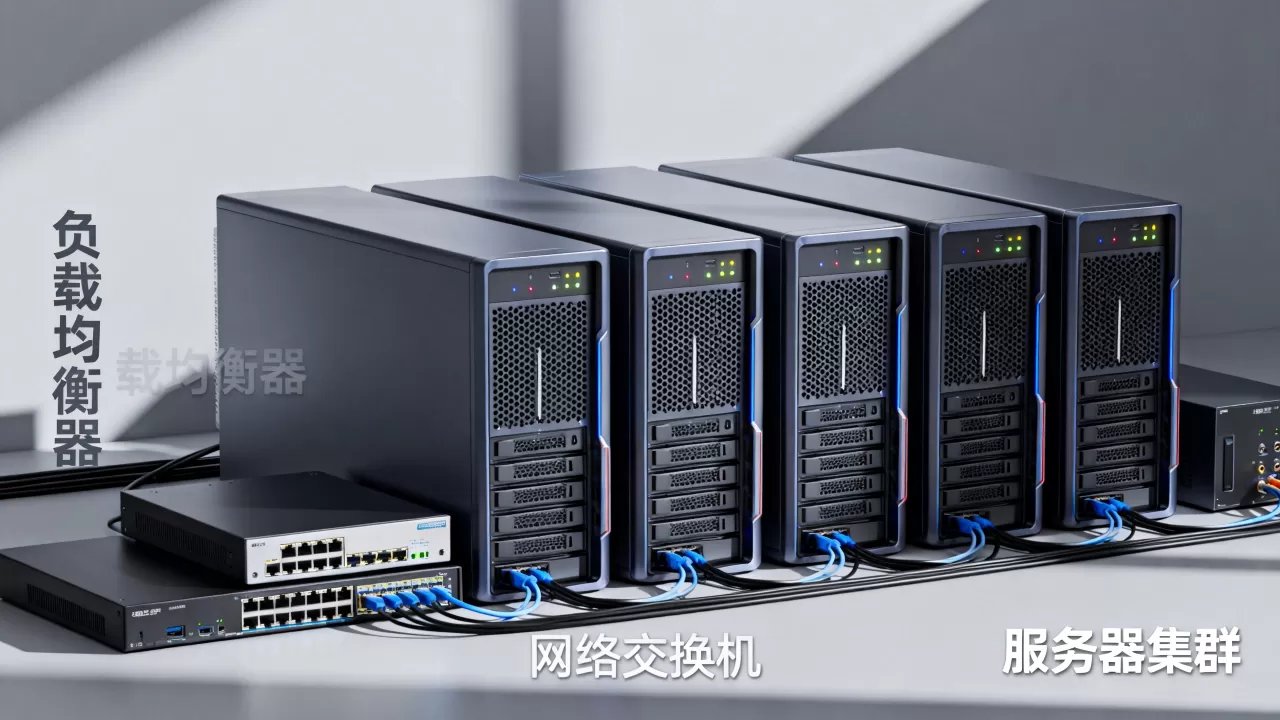
在云计算场景下,集群的节点数不是固定的,负载均衡器对接自动伸缩组(如简米云SLB对接ESS、AWS ALB对接Auto Scaling Groups),当流量高峰到来时,系统自动扩容新节点并加入集群,负载均衡器自动感知新节点并开始分发流量,流量回落后,系统缩容并摘除多余节点,负载均衡器同步更新可用节点列表。
部署层面的关键步骤:
- 在云控制台创建负载均衡实例
- 配置监听规则(协议、端口、转发策略)
- 把服务器实例加入负载均衡的后端服务器组
- 设置健康检查路径和间隔时间
- 绑定自动伸缩组,指定伸缩阈值
一个典型电商场景的完整协作链路
结合一个具体场景来理解这两者的协同。
假设一家电商平台在618大促期间,日请求量从平日的2000万次飙升到1.2亿次,它的架构是:客户端 → DNS解析 → 云负载均衡器 → Nginx集群(4台) → 应用服务器集群(20台) → 数据库集群。
请求到达云负载均衡器后,按照预设的最少连接策略分发到Nginx节点,Nginx节点之间彼此独立,但都接入同一个配置中心,保证转发规则一致,Nginx把请求进一步分发到后端的应用服务器。
如果某台应用服务器的GC时间突然变长、响应变慢,健康检查机制会捕捉到异常响应时间超过设定的3秒阈值,负载均衡器自动把它摘除,这台机器上的未完成请求由其他节点继续处理,用户不会感知到任何异常。
大促结束后流量回落,系统自动缩容,多余的服务器被释放,整个过程,集群和负载均衡器全程协同,无需人工干预。
负载均衡和集群的区别是什么
这两个概念容易被混为一谈,实际上解决的问题完全不同。
| 对比维度 | 服务器集群 | 负载均衡 |
|---|---|---|
| 核心目标 | 提供冗余算力、扩展容量 | 分配请求、保证调度效率 |
| 典型技术 | 高可用集群、分布式存储集群 | Nginx、HAProxy、云SLB |
| 故障处理 | 通过冗余保证服务不中断 | 通过探活和转发策略规避故障节点 |
| 弹性伸缩 | 提供伸缩的执行能力 | 感知节点变化并调整分发 |
业内专家指出,多数系统稳定性和性能问题的根因,不是集群容量不够,而是负载均衡策略没调对,先诊断调度问题,再做扩容,是更合理的排障顺序。
如何配置服务器集群负载均衡
把这个过程拆成可操作的步骤,适合团队在已有架构上落地。
- 评估业务瓶颈确认瓶颈在CPU、内存还是带宽,决定集群层级是否需要扩展
- 选定负载均衡器中小规模用Nginx或HAProxy,大规模混合云场景可选用Envoy或云厂商的负载均衡服务
- 配置健康检查设置检查路径、间隔时间、超时阈值,建议间隔5秒、超时3秒、连续失败3次判定宕机
- 配置负载均衡算法初期可用轮询,运行一周后观察各节点负载情况,再调整为加权轮询或最少连接
- 启用会话保持结合业务需要决定使用粘滞会话还是共享会话存储
- 部署负载均衡器高可用
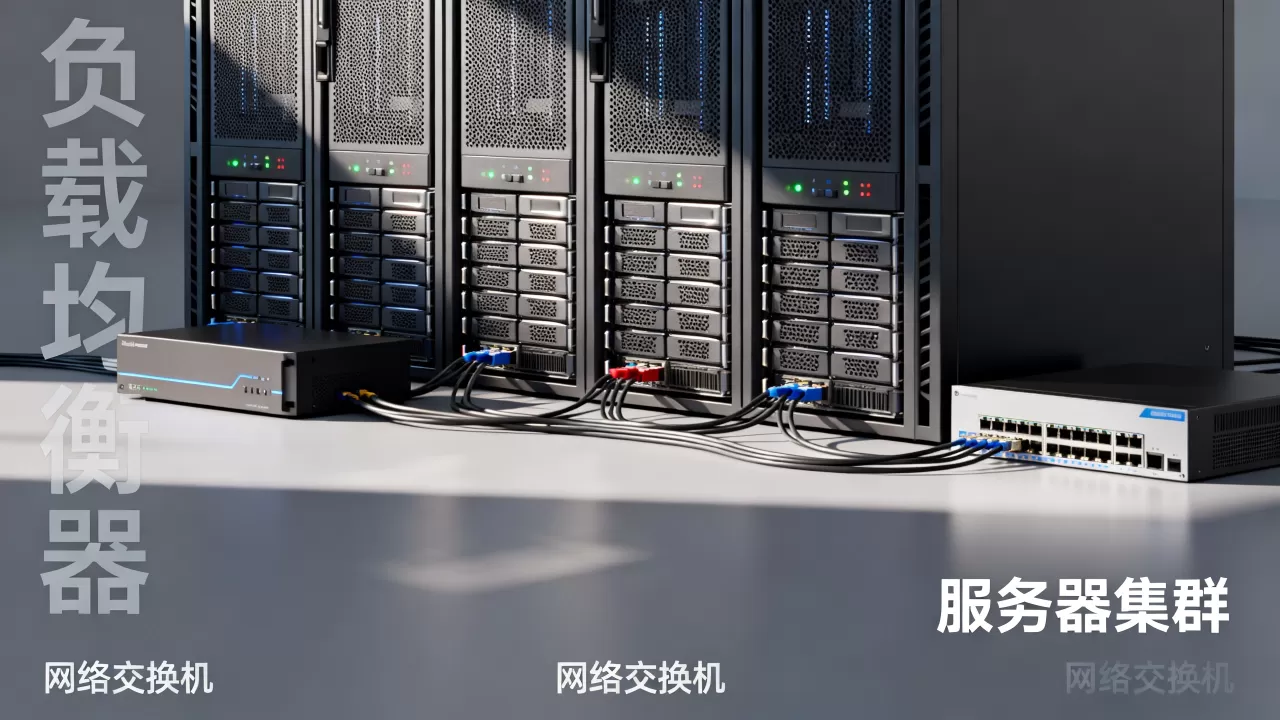
Keepalived主备,或云负载均衡实例本身的多可用区部署
- 压测并调参使用压测工具模拟预期峰值的1.5倍流量,观察节点CPU利用率和响应时间,调整权重和并发连接数
这套路径适用性覆盖面广,从中小企业几百并发到中大型平台数十万并发都能参考,只是选型和技术细节会有差异。
高可用架构设计中的常见误区
在集群和负载均衡的设计中,有三个高频误区值得避开。
只关注负载均衡器,忽略后端容量
负载均衡器调得再好,集群内每台服务器的处理能力有限,整体性能瓶颈依然存在,合理做法是基于压测数据确定单机QPS上限,再推算出所需节点数量。
把负载均衡做成新的单点
有些团队把Nginx放在一台服务器上,这台服务器挂了整个系统就瘫痪,行业共识认为,负载均衡层必须至少双机热备,或者直接使用云厂商托管的负载均衡服务。
健康检查配置过于宽松
健康检查间隔过长,导致故障节点继续接收流量;间隔过短,可能因为一次性抖动误摘节点,合理配置是:间隔5秒、超时2秒、连续失败2次判定宕机、连续成功2次恢复。
最终判断标准:稳和快能否同时成立
回到核心问题:服务器群集与负载均衡如何协同提升系统高可用性与性能?答案可以收敛为三句话:集群决定系统的上限容量,负载均衡决定容量能否被有效利用,两者结合才能让系统既稳得快、又跑得快。 单有成群的服务器而不会调度,资源就闲置;只有聪明的调度而没有足够的资源,再好的策略也无处发力。
衡量协同效果有两个指标:一个是可用性SLA(不低于99.9%是及格线),另一个是峰值吞吐时P99响应时间的变化幅度,两个指标同时达标,才算真正做到了高可用与高性能的兼顾。
关于服务器集群与负载均衡的常见问题解答
如何选择负载均衡算法
优先考虑请求处理的均匀性,如果各节点配置相同、业务处理时间类似,用轮询即可;如果存在长请求和短请求混合的情况,最少连接更合适,大型系统建议从最少连接开始,运行后对比节点CPU使用率再做调整。
集群中节点数量越多,系统性能越线性提升吗
不是,集群性能提升存在边际递减效应,节点增多后,内部通信开销、会话同步成本、数据一致性维护成本都在上升,多数情况下9到12个节点的集群已经接近收益拐点,继续增加节点需要拆分业务模块或引入更复杂的分布式框架。
服务器集群配置中如何保证部署环境一致
使用配置管理工具(如Ansible、Puppet)或容器化方案(Docker + Kubernetes)来保证环境和应用版本的一致性,应用发布时采用滚动发布策略,每次更新一部分节点,观察监控指标正常后再更新其余节点。