通用计算服务器与加速卡的搭配,核心逻辑是“应用场景决定卡型,卡型决定服务器配置”,不存在万能组合,但存在一个稳妥的选型顺序:先确认算力密集型任务的具体类型(训练、推理、渲染或数据分析),再据此选择加速卡架构,最后倒推服务器的CPU、内存、PCIe通道和供电冗余。
通用计算服务器和GPU服务器区别在哪
很多团队在搭建AI基础设施时,会惯性认为“买GPU服务器就是买了AI能力”,通用计算服务器和GPU服务器在硬件形态上可能完全相同,都基于x86平台,区别在于扩展能力的侧重点和系统调优方向。
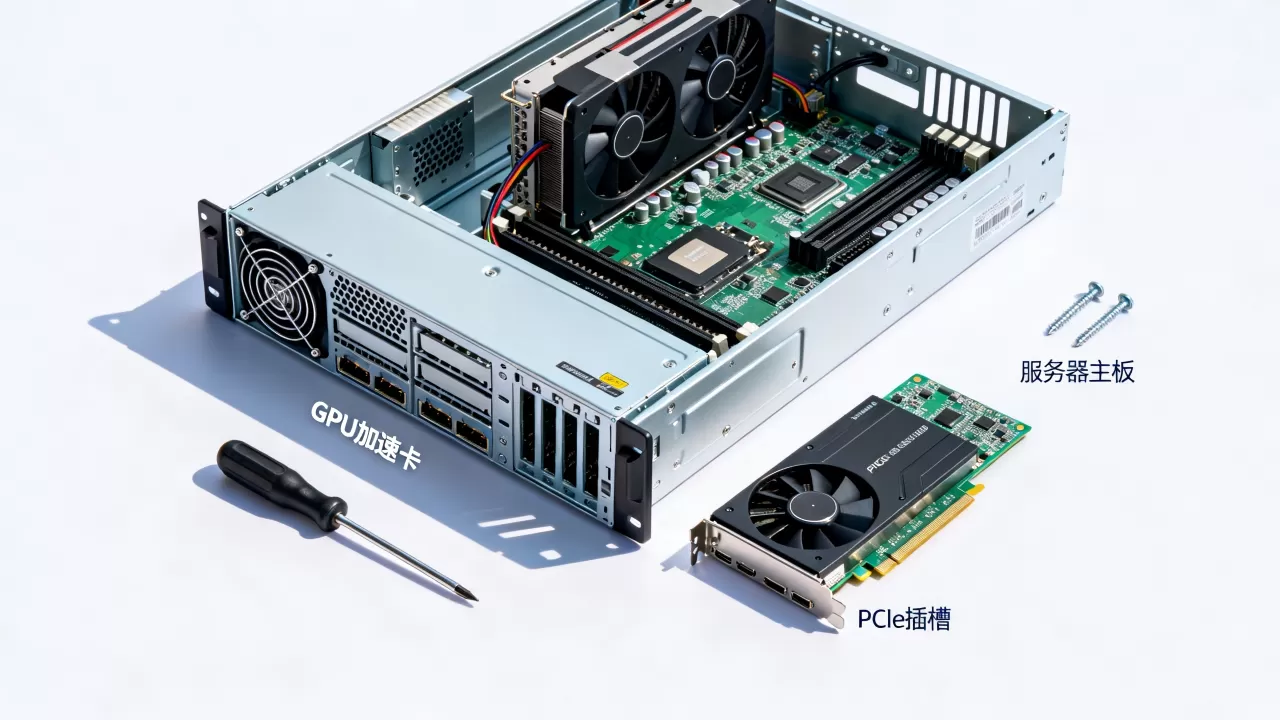
通用计算服务器强调的是多核心并行处理、内存容量和存储吞吐,它的PCIe插槽主要承载网卡、阵列卡等基础设备,而GPU服务器(或加速型服务器)需要在主板设计、供电模组和散热风道层面为高功耗加速卡预留足够余量,尤其是PCIe Switch芯片的搭载数量,直接影响卡片间的通信带宽。
行业共识认为,判断一台通用计算服务器能否胜任加速卡部署,只需要看三个硬件指标:
- PCIe x16物理插槽数量:如果主机仅提供2个x16插槽,那么单机最多承载2张全高全长双宽加速卡,且需确认插槽是否为CPU直连通道而非PCH桥接通道,后者带宽会显著缩水。
- 电源冗余功率:一张300W的推理卡加上两颗高负载CPU,整机功耗容易突破900W,若电源模块是800W2的非冗余配置,降频风险很高。
- 风道设计:涡轮风扇散热的加速卡适合横向风道机箱,被动散热卡则必须依赖服务器内部的高压差风墙,普通塔式机箱往往不具备这种条件。
深度学习服务器配置推荐:两类方案的取舍
按照当前主流的工作负载特征,用户通常在两种方案间犹豫:多卡并行训练机和单卡高密度推理机。
多卡并行训练机偏向“均衡配置”,CPU主频不需要极高,但核心数要足够支撑数据预处理和分布式通信库,推荐搭配双路Intel Xeon Silver系列
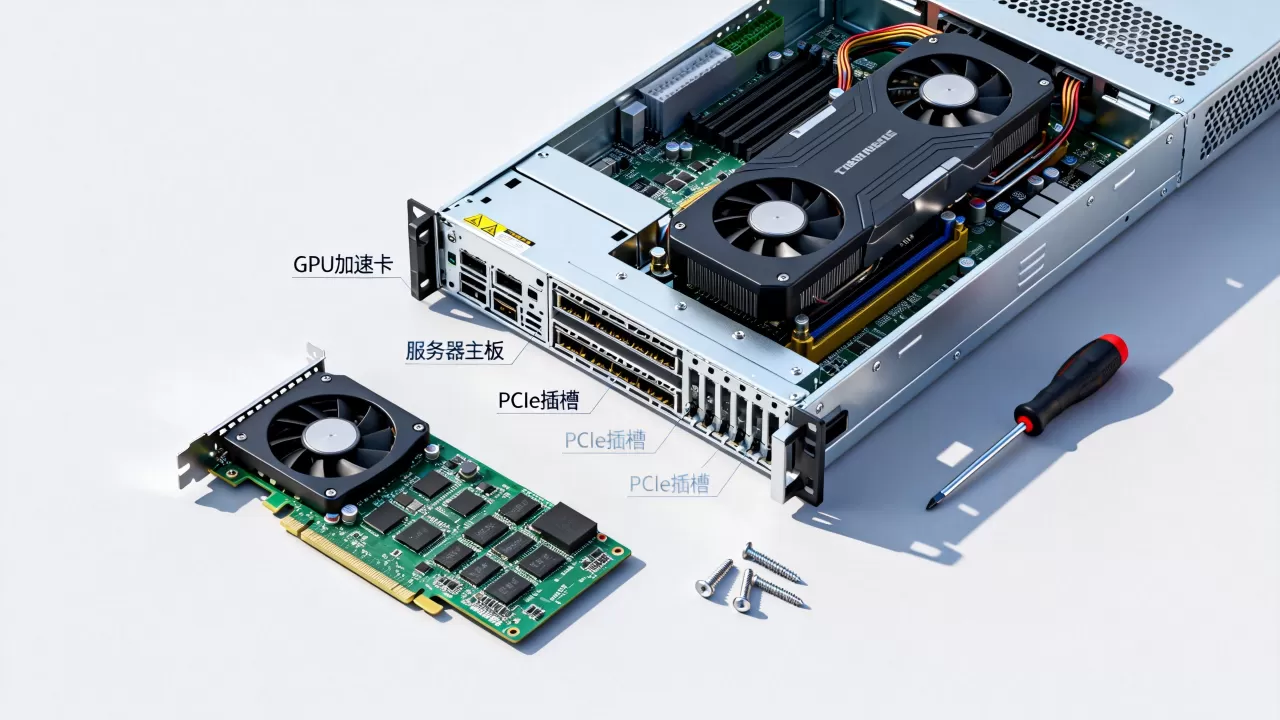
或AMD EPYC 7003系列,内存容量为核心数的4-8倍(例如64核配256GB内存),存储至少配置一块NVMe U.2 SSD作为数据集缓存盘,加速卡优先考虑具备NVLink或NVSwitch互联能力的型号,保证梯度同步效率。
单卡高密度推理机则完全不同,这类服务器的算力瓶颈在内存带宽和PCIe通道负载,常规做法是选择单路CPU平台,例如Intel Xeon E-2400系列或AMD EPYC 4004系列,搭配4张PCIe接口的推理加速卡,无需NVLink支持,通过PCIe直通和NUMA绑定即可把单卡推理延迟控制在个位数毫秒级。
加速卡选型的三个核心维度
加速卡不是只有GPU这一种选择,业内专家指出,很多数据中心的加速卡部署案例中,约有一半以上的工作负载并不需要通用GPU的大规模并行计算能力,用专用ASIC芯片或FPGA更经济,选卡前必须梳理清楚三个维度。
第一个维度是精度需求,深度学习训练必须依赖FP32甚至FP16/FP64高精度计算,通用GPU是唯一合理选择,而推理任务通常采用INT8量化即可保证模型精度损失在1%以内,此时选择AI加速卡(如边缘推理棒或数据中心推理卡)性价比远高于GPU。
第二个维度是显存带宽,显卡服务器的常见误区是只盯着显存容量,忽视了带宽指标,一张显存容量为48GB但带宽仅有600GB/s的加速卡,在处理大Batch Size的Transformer模型时,计算单元空闲率会超过40%,工程上建议优先选择带宽超过1TB/s的HBM系列显存产品。
第三个维度是生态兼容性,CUDA生态在学术和工业界的统治力众所周知,但如果你需要部署的模型是基于PyTorch框架,且要求支持动态形状输入,那么国产加速卡在算子适配方面可能存在额外工作量,具体兼容列表需查阅框架官方文档。
显卡服务器多少钱:预算分级选型思路
预算直接决定可选择的加速卡代际,这里提供一个不精确但实用的分档参考。
入门价位段(单卡卡价格在数千元级),通常选择上一代或上两代的游戏卡魔改版或半高半长专业卡,适合算法原型验证和轻量级推理,这个价位段的服务器无需专门采购整机,将原有办公电脑的电源升级至750W以上即可运行。
主流价位段(单卡价格在数万元区间),可选择数据中心推理卡或入门级训练卡,多见于企业业务推理和中等规模模型微调,此阶段建议大家直接采购品牌整机(如戴尔PowerEdge R7625或浪潮NF5688M6),因为原厂对供电纹波和散热风压都做过专项测试,自行组装容易出现兼容性告警。
高端价位段(单卡价格10万元以上),涉及HBM高带宽显存的旗舰级GPU,一般应用于大模型预训练或科学计算,这个段位的服务器建议单独配置液冷散热系统,并将机房空调温度设定在18-22℃,高温环境下NVLink控制器容易触发降频保护。
选型落地五步法
在真正下单采购前,不妨把选型过程拆解成五个可验证的步骤。
第一步,输出工作负载画像,用nvidia-smi和perf工具采集当前CPU和显卡服务器运行时的利用率数据,如果GPU利用率长期低于50%且CPU利用率拉满,说明瓶颈在数据预处理代码而非加速卡数量。
第二步,确定加速卡物理尺寸,全高全长双宽卡需要占用三个PCIe槽位宽度,并干涉相邻的网卡和存储扩展位,实测发现,很多4U机箱在最内侧PCIe插槽安装加速卡时,会因为电源仓挡板导致无法合上机箱盖。
第三步,计算总线带宽缺口,通过lspci -vvv命令查看当前设备的LnkCap和LnkSta字段,如果加速卡仅运行在PCIe 3.0 x8模式下,且带宽利用率超过70%,就需要升级至PCIe 4.0或5.0平台。
第四步,执行跑分验证,在目标服务器上运行ResNet-50的空转脚本和BERT模型的真实推理请求,比较加速卡理论算力与实际吞吐的比值,理论上该比值应低于3:1,若超过则说明CPU端的数据准备能力严重拖慢整体流程。
第五步,预留20%的升级空间,服务器机箱的整机功率设计、散热风扇转速RPM和电源模块均为模块化设计,采购时把预算的10-15%预留给未来加速卡的升级需求,避免二次采购时发现电源和散热成为瓶颈。
避坑指南:三类常见搭配失误
第一类失误是在低端桌面级主板上安装数据中心加速卡,这类主板虽然物理接口兼容,但PCIe信号质量和供电相位设计不足,容易出现随机性训练中断或推理结果异常,行业普遍反馈,非服务器平台跑GPU训练任务的稳定性远不如整机方案。
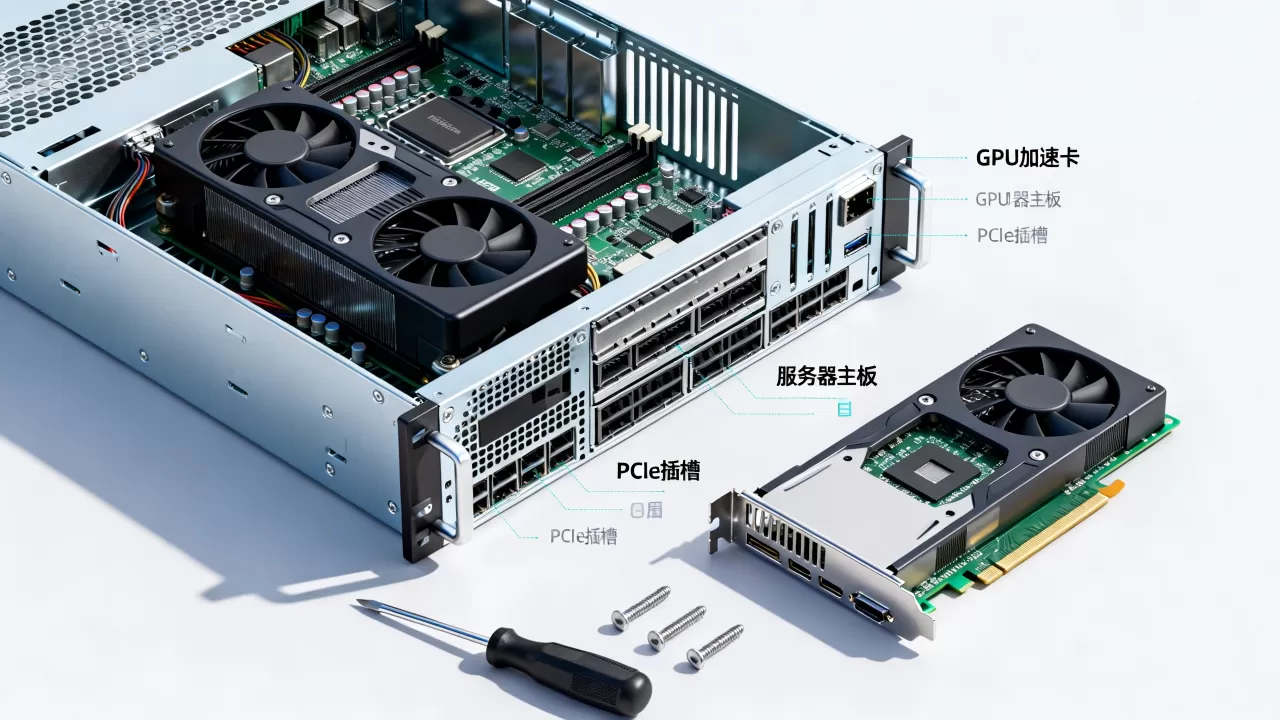
第二类失误是忽略加速卡的主动散热需求,部分加速卡设计为被动散热,需要服务器的系统风扇提供至少每分钟6000转以上的强制风量,而机架式服务器的前硬盘背板会极大扰动风道,正确做法是把加速卡安装在靠近CPU散热器的槽位,并拆掉相邻的硬盘托架上的挡风片。
第三类失误是不区分虚拟化和容器化场景,在VMware虚拟化环境下,加速卡直通(PCIe Passthrough)和SR-IOV模式对内存资源和CPU亲和性的要求完全不同,虚拟化场景需要配置更大的CPU预留池,否则虚拟机调度延迟会把加速卡的批量推理优势消耗殆尽。
Q&A:通用计算服务器加速卡选型高频疑问
20卡服务器电源和散热怎么配
20卡服务器通常指配置20张双宽加速卡的整机柜方案,该配置下整机峰值功耗远超标准机柜的供电能力,需要采用48V直流供电+机柜级液冷方案,常规风冷设计只能支撑单机4-8卡,更高密度必须引入冷板式液冷,或者将服务器拆分为多个4卡节点并用高速网络互联。
加速卡显存容量越大越好吗
并非越大越好,显存规模取决于模型参数量和Batch Size的乘积,一个70亿参数的对话模型运行FP16推理时,显存占用约在14-16GB之间,使用16GB显存的加速卡即可完整体量加载,超过需求的大显存只会在以下场景产生实际收益:超大Batch Size训练、长序列生成、以及需要同时驻留多个模型的部署场景。
国产算力服务器和通用机架式服务器的选择边界是什么
如果业务中存在成熟的国产化需求,比如等保合规或信创验收,且模型训练框架已经适配国产深度学习平台,那么选择国产加速卡服务器在采购流程和后续运维层面更顺畅,但若追求最快的模型迭代速度和与全球主流框架的零间隙兼容,通用x86服务器配国产加速卡是过渡期的务实之选,不过需要预留额外的算子适配和性能调优工时。