评估计算服务器时,内存带宽比核心数更早成为性能瓶颈:核心再多,数据供应跟不上,处理器只能空转等待。 很多采购者选计算服务器第一眼就盯核心数,64核、128核看着很猛,但跑流体仿真、气象模拟、深度学习训练时CPU利用率就是拉不满,问题通常不在核心数量,而在内存带宽,内存带宽是核心的“粮道”,粮道太窄,兵再多也只能排队领粮。
计算服务器内存带宽和核心数哪个重要?把核心当工人,带宽当传送带
计算服务器的工作逻辑很简单:核心负责算,内存负责把数据喂给核心,核心数量越多,需要的瞬时数据量就越大,如果内存带宽不够,核心就算再快,也只能在每一个时钟周期里干等数据从内存搬进来,这种状态下,加核心反而会增加等待队列长度。
业内专家指出,多数高性能计算集群的性能瓶颈已经从计算单元转移到存储与内存子系统,一台双路服务器可以轻松塞进几十个物理核心,但内存通道数受限于平台设计,通常只有4到8个通道,核心翻一倍容易,内存带宽翻一倍却要换平台、换主板、甚至换整机架构。
- 核心数决定“有多少个工人”
- 内存带宽决定“传送带每分钟能送多少料”
- 计算密集型任务可能对带宽不敏感
- 访存密集型任务对带宽的需求远大于核心数量
判断该优先看哪个,先确认负载类型,科学计算、CFD仿真、分子动力学、深度学习数据加载,都属于访存密集型,数据库内存分析、大数据处理也容易碰到内存墙,只有在纯数学计算、加解密、图像渲染等负载下,核心数的权重才会明显高于内存带宽。
服务器核心数多但内存带宽低会怎样?先看三个最常见的“假忙”场景
很多人以为CPU利用率高就是好事,其实在计算服务器上,CPU利用率高但有效计算比例低的情况非常普遍,核心数多而内存带宽低,最典型的表现就是“假忙”。
核心都在跑,但计算进度慢
跑CFD仿真时,你看top命令会发现所有核心都在100%,但迭代一步的时间比预期长很多,打开perf stat -e memory_loads,memory_stores观察,会发现内存访问事件堆积成山,核心并没有偷懒,只是在等数据。
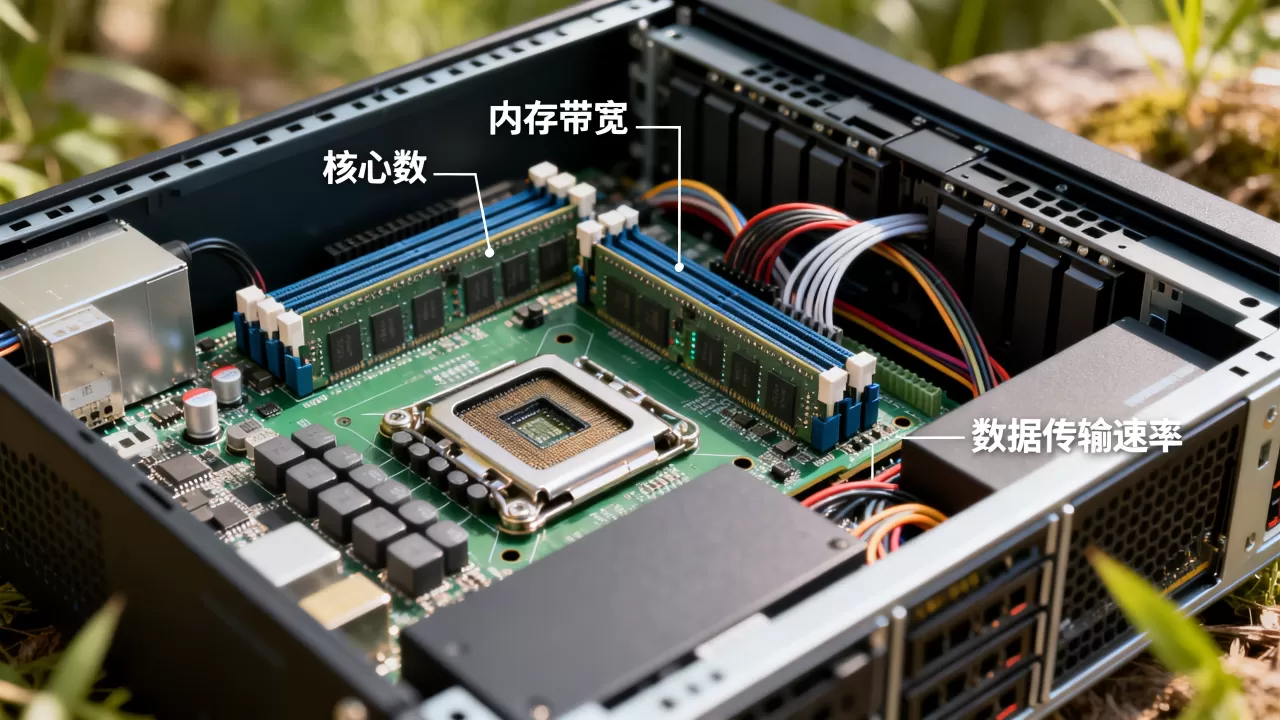
增加核心数后性能不升反降
这种情况在高性能计算集群里并不少见,把任务从32核换成64核,结果总计算时间几乎不变,甚至因为通信开销变大而更慢,原因就是每核心分配到的有效内存带宽被稀释了,原本32个核心共享8通道带宽,增加到64核,每个核心能分到的带宽直接减半。
深度学习服务器内存带宽要求:数据搬运比矩阵乘法更频繁
深度学习训练服务器是一个特殊场景,很多采购者只看GPU显存和算力,却忽略CPU端的内存带宽对数据预处理、数据加载、梯度同步的影响,当训练数据需要从内存搬到GPU显存时,内存带宽决定搬一次要多久,如果数据加载速度跟不上GPU计算速度,GPU也会空转。
深度学习服务器内存带宽要求不能低于存储带宽与网络带宽的较大值,实际配置时可以用以下方法判断:
- 先确认单次训练批次的数据量
- 估算每秒钟需要从内存搬多少数据到GPU
- 用内存带宽除以该数据量,得到理论搬运时间
- 如果搬运时间接近或超过一步训练时间,内存带宽就是短板
计算服务器价格与内存带宽关系:省核心的钱换带宽,多数情况下更划算
采购预算固定时,很多人倾向于把预算砸向更多核心数,但从实际运行效率看,少买两个核心,把省下的钱加到更高频率内存或更多内存通道上,性能提升往往更明显,这就是计算服务器价格与内存带宽关系里最反直觉的一点。
| 配置方案 | 核心数 | 内存通道数 | 内存频率 | 每核心可用带宽 | 常见结果 |
|---|---|---|---|---|---|
| 高核心低带宽 | 64核 | 4通道 | DDR4-2666 | 较低 | 访存密集任务利用率低 |
| 中核心高带宽 | 48核 | 8通道 | DDR4-3200 | 较高 | 多数仿真任务总时间更短 |
| 极核心高带宽 | 32核 | 8通道 | DDR5-4800 | 最高 | 单核任务吞吐不弱 |
表格只是趋势对比,不表示具体数值,核心逻辑是:每核心可用带宽比总核心数更能预测真实性能,一台24核但每核心带宽充足的计算服务器,跑某些访存密集应用时,可能比一台64核但带宽严重不足的机器更快出结果。
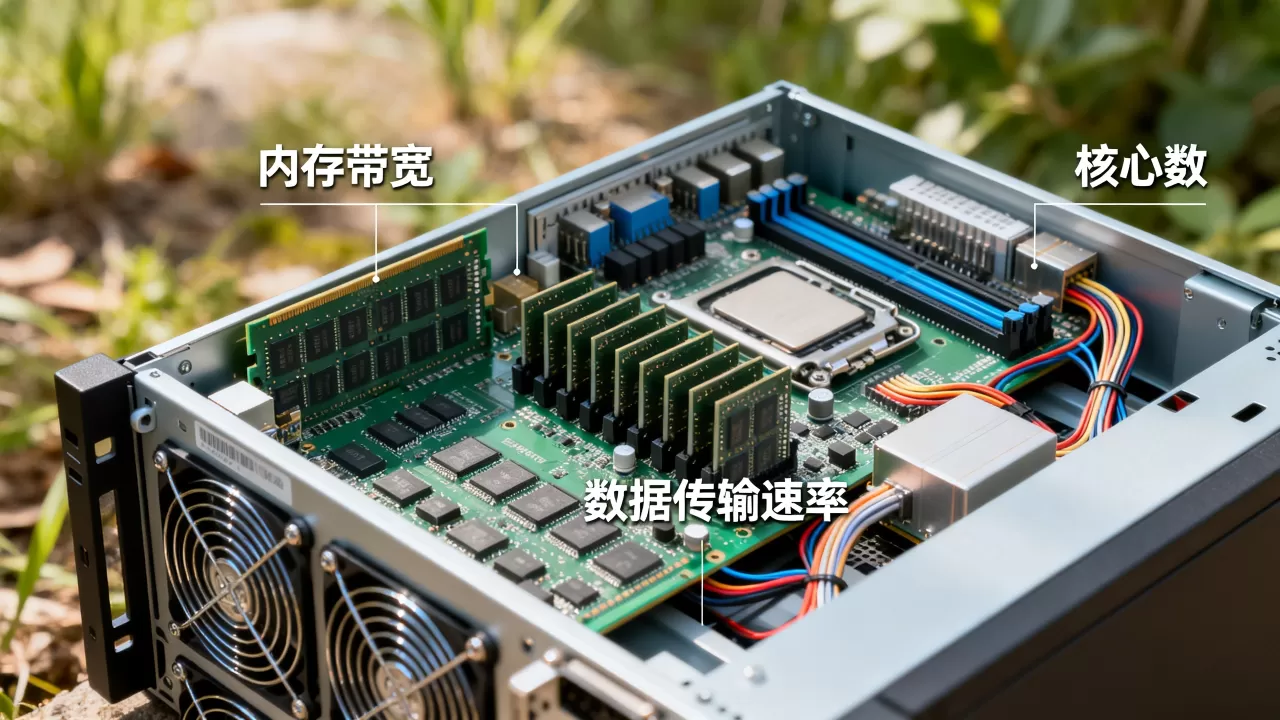
采购配置单上,建议按以下顺序核对:
- 内存通道数(双路平台一般是8通道或12通道)
- 内存频率和类型(DDR4、DDR5,频率越高越好)
- 每核心平均带宽(总理论带宽除以物理核心数)
- 核心数(放在最后看)
北京计算服务器内存带宽配置参考:别让机房销售只给你报核心数
北京地区数据中心密集,托管和采购计算服务器的企业很多,不少本地服务商在报价单上习惯把核心数标得特别大,内存带宽信息却藏在规格书末尾。北京计算服务器内存带宽配置的常见误区就在这里:买回去跑仿真发现慢,查配置才发现内存只有4通道,频率还是基础款。
如果你在北京采购计算服务器,建议直接在询价单上写明:请提供内存通道数、内存频率、每核心可用带宽,不要只写“我要64核、256G内存”,256G内存如果插在4通道上,和插在8通道上,带宽差一倍,核心数一样,跑出来的性能差距可能相差很大。
- 北京机房托管的计算服务器,双路Xeon或EPYC平台居多
- 优先选支持8通道内存的平台,避免4通道老平台
- 内存频率尽量选3200MT/s以上,DDR5平台优先考虑
- 确认内存条是否插满所有通道,空通道等于浪费带宽
怎么快速判断计算服务器内存带宽是否拖后腿?三条命令搞定
评估一台计算服务器时,不用盲猜,可以直接用命令和工具实测,以下步骤可以在Linux系统上直接执行。
第一步:看硬件规格
lscpu | grep -E 'Socket|Core|Thread|Model name'
dmidecode -t memory | grep -E 'Speed|Size|Type|Locator'
numactl --hardware
第一条命令看物理核心和NUMA节点数,第二条命令看内存条频率、容量和插槽位置,第三条命令看内存节点分布,判断是否存在NUMA不均衡。
第二步:算理论带宽
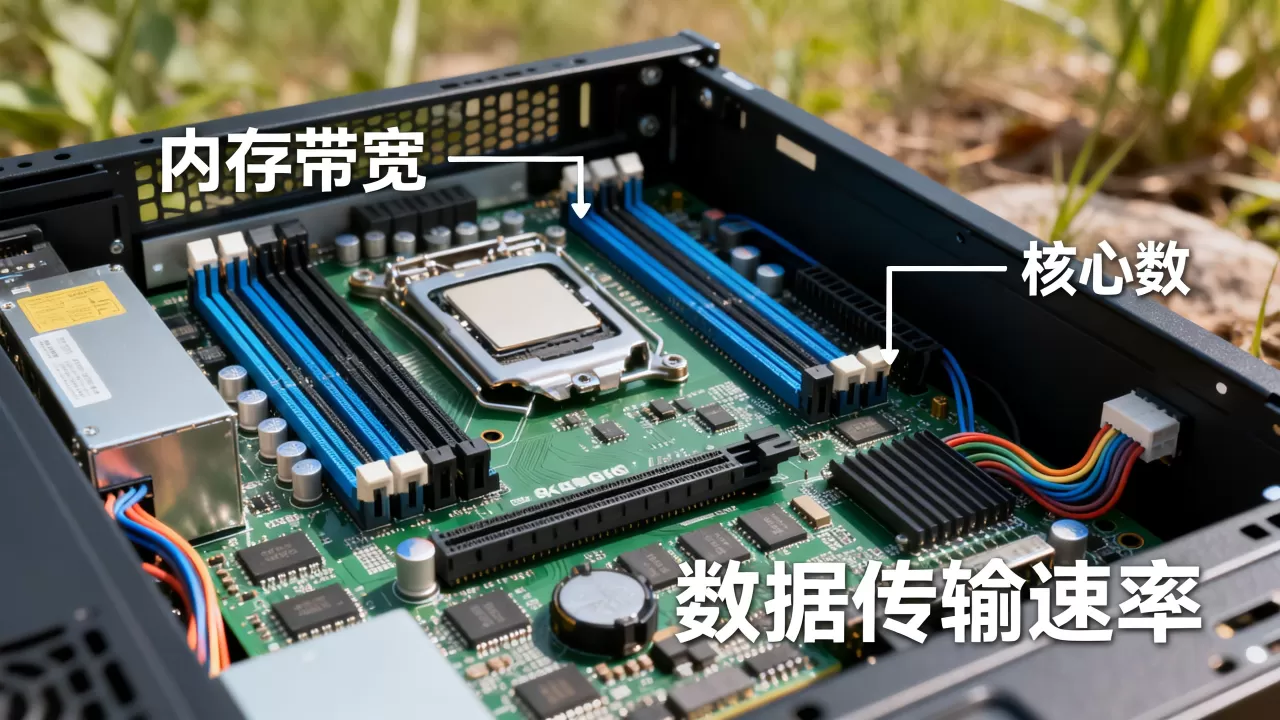
以DDR4-3200为例,单通道理论带宽约25.6 GB/s,如果一台双路服务器有8个内存通道,理论总带宽约204.8 GB/s,把这个数字除以物理核心数,就是每核心可用带宽,这个值越低,访存密集任务越容易卡。
第三步:跑STREAM基准测试
git clone https://github.com/jeffhammond/STREAM.git
cd STREAM
gcc -O3 -fopenmp stream.c -o stream
./stream
STREAM会给出Copy、Scale、Add、Triad四种内存操作的实际带宽,用实测值对比理论值的比例,就能判断内存子系统是否健康,如果Triad实测带宽低于理论值的六成,说明内存配置或BIOS设置有明显问题。
第四步:检查NUMA分配是否合理
多路服务器上,内存分属不同CPU,如果程序只在一个NUMA节点上分配内存,另一个节点的核心访问远端内存时,带宽会大幅下降,运行程序前可以强制内存交错分配:
numactl --interleave=all ./your_simulation
这个操作能避免远端内存访问带来的带宽损失,对跨节点访存密集程序尤其有效。
评估计算服务器,先把核心数放第二,把每核心带宽放第一
核心数只是算力上限,内存带宽决定实际能吃到多少算力,选计算服务器时,先把内存通道数和频率问清楚,再用STREAM实测一轮,最后回头谈核心数,这样才能避开“纸面核心很多、实际性能拉胯”的坑。
Q&A
计算服务器内存带宽和核心数怎么平衡?
先确定负载是访存密集型还是计算密集型,访存密集型任务优先保证每核心可用带宽,核心数可以适当减少,用STREAM实测带宽,再用实际应用跑小规模测试,观察增加核心后总时间是否线性下降,如果不降反升,说明带宽已经顶到天花板。
服务器内存带宽测试用什么工具?
通用工具是STREAM,适合测持续内存带宽,Intel平台还可以用MLC(Memory Latency Checker)测延迟和带宽,测试前关闭CPU频率调节,使用多线程运行,记录Triad项结果,这些工具不依赖特定付费软件,Linux环境下编译即可。
预算不够时买计算服务器先保证内存带宽还是核心数?
先保证内存带宽,核心少一点,任务排队多花几分钟还能接受;带宽不够,处理器在运行期间大量空转,浪费的是实打实的电费和机时成本,计算服务器采购中,每核心可用带宽是比总核心数更硬性的指标。