数据湖先存原始数据、读取时再定义结构;数据仓库先定义表结构、再把加工好的数据写进去,使用方式因此分叉数据湖面向探索、机器学习与日志归档,数据仓库面向固定报表、指标监控与BI分析。
很多人把数据湖当成数据仓库的扩容版,这个理解会把架构带偏,下面拆开看。
数据湖和数据仓库的区别是什么?先拆存储结构
数据湖的存储结构:先存后定义
数据湖底层通常是对象存储或HDFS,文件以原始格式直接进湖,Parquet、ORC、JSON、CSV、图片、日志文本都能放。
关键机制是Schema-on-read,写入时不要求统一列名和类型,读取时再套结构。
例如IoT设备一天产生大量JSON日志,不必先设计几十个字段的表,直接把文件放入raw目录,查询时建外部表或跑Spark作业,再解析字段。
常见操作路径:
- 上传原始文件:
aws s3 cp device_logs/ s3://data-lake/raw/device_logs/ - 建外部表:
CREATE EXTERNAL TABLE device_logs_raw (payload string)
STORED AS TEXTFILE
LOCATION 's3://data-lake/raw/device_logs/';
- 读取时用JSON函数拆字段。
结构后置带来灵活性,也带来“数据沼泽”风险,没有治理,raw区会变成垃圾场。
数据仓库的存储结构:先定义后写入
数据仓库相反,写入前必须有建表语句,字段类型、主键、分区键全部定好,这是Schema-on-write。
数据进入仓库前经过清洗、去重、关联维度表,模型通常是星型或雪花型。
常见操作:
- 建表:
CREATE TABLE dw.sales_fact (
  order_id BIGINT,
  customer_id BIGINT,
  product_id BIGINT,
  amount DECIMAL(18,2),
  order_date DATE
) PARTITION BY (order_date);
- ETL写入:使用insert overwrite或merge。
数据仓库存的是“可信版本”,适合直接对接BI,但新增字段、改结构成本高,需要重跑链路。
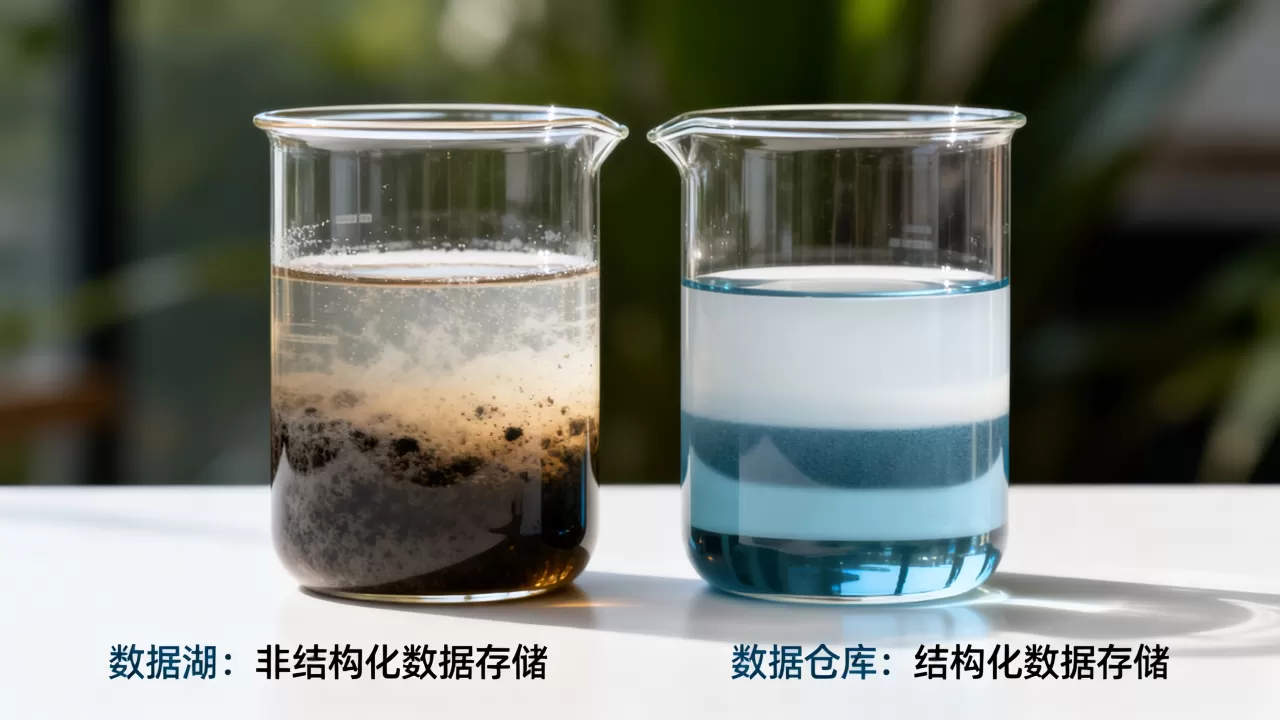
存储结构对比:
| 维度 | 数据湖 | 数据仓库 |
|---|---|---|
| 存储格式 | 原始多格式 | 清洗后的结构化表 |
| Schema定义 | 读取时定义 | 写入时定义 |
| 典型存储 | 对象存储/HDFS | 关系型/MPP列存 |
| 灵活性 | 高 | 低但稳定 |
| 治理难度 | 相对高 | 相对成熟 |
使用方式不同,数据湖适用场景有哪些自然分出来
数据仓库的日常:固定报表与指标查询
数据仓库的使用者多数是数据分析师、BI工程师,每天跑固定SQL,输出日活、GMV、转化率。
操作路径:
- 连接BI工具到数据仓库。
- 用聚合SQL产出日报:
SELECT order_date, SUM(amount)
FROM dw.sales_fact
WHERE order_date >= '2026-01-01'
GROUP BY order_date;
- 指标固化到宽表或数据集。
特点是反复查询同一套模型,性能优先,列存和分布式执行对聚合SQL友好。
数据湖的日常:探索、机器学习与归档
数据湖的使用者更多是数据工程师、算法工程师,他们关心“能不能快速拿到原始数据做实验”,而不是固定报表。
典型场景:
- 训练推荐模型,需要点击流日志的原始顺序。
- 图片、音频等非结构化数据做特征工程。
- 历史数据合规归档,不能删。
操作路径:
- 用Spark读Parquet:
df = spark.read.parquet("s3://data-lake/raw/clickstream/")
df.select("user_id", "item_id", "event_time").show()
- 在Notebook里做特征,不污染仓库模型。
- 数据湖内部分区:raw / cleaned / feature,逐层加工。
业内专家指出,数据湖的价值不在替代仓库,而在承接仓库不愿存或存不起的多源原始数据。
企业选数据湖还是数据仓库?先看角色、数据形态和成本边界
角色决定使用方式
- 业务分析师、BI工程师:固定报表、指标口径,选数据仓库更省心。
- 数据工程师、算法工程师:多源异构数据、探索实验,选数据湖更合适。
多数情况下,企业两样都要,数据湖作为原始数据底座,数据仓库作为加工后的指标层。
数据湖成本高吗?存储便宜但治理有隐性支出
数据湖的对象存储每GB单价通常低于数据仓库存储单价,但查询按扫描量计费,全表扫描大量数据时成本会快速上升。
数据湖的隐形成本包括:
- 元数据管理。
- 权限控制。
- 生命周期策略。
成本控制实操:
- 开启生命周期规则:raw区30天后转低频存储,180天后归档。
- 文件格式选Parquet+Snappy压缩,减少扫描量。
- 限制全表扫描,用分区裁剪。
数据湖成本高吗”没有固定答案,治理好,数据湖总体成本优势明显;放任不管,它会比仓库更贵。
杭州数据湖解决方案常见的搭配方式
杭州本地互联网与智能制造企业多,数据湖方案通常不是单一产品,而是组合。
常见架构:
- 对象存储作数据湖底座。
- Spark或Flink作计算层。
- 数据湖构建服务管理元数据。
- 落盘后通过外表映射到数据仓库引擎查询。
杭州一家电商公司把用户行为日志先入对象存储,使用EMR Spark清洗后,再通过外表用MaxCompute查询,这样原始日志不丢,分析师也能继续用SQL。
“杭州数据湖解决方案”的核心思路通常是:湖存原始、仓供指标、中间用计算引擎连接。
落地实操:两条最小闭环,按需启动
数据仓库最小操作
- 建表,定义事实表和维度表。
- 写ETL脚本抽取业务库数据。
- 清洗后写入表。
- BI连接,配置报表。
验证:
SHOW PARTITIONS dw.sales_fact;
SELECT COUNT() FROM dw.sales_fact WHERE order_date = '2026-01-01';
数据湖最小操作
- 上传原始文件到raw目录。
- 用计算引擎建外部表。
- 跑一次聚合或特征提取。
- 结果写回processed目录。
验证:
spark.sql("SELECT COUNT() FROM device_logs_raw").show()
这两条链路都很短,但底层假设完全不同,一个信任预定义结构,一个信任读取时解释。
数据湖与数据仓库不是替代关系,存储结构决定了它们一个灵活、一个稳定;使用方式决定了它们一个服务探索、一个服务报表,选型时先看团队角色、数据形态和成本边界,比纠结名词更重要。
Q&A:数据湖和数据仓库的核心差异常见问题
数据湖和数据仓库的核心差异会影响日常使用方式吗?
会,数据湖的Schema-on-read让数据接入快,适合频繁变更的半结构化数据;数据仓库的Schema-on-write让指标口径统一,适合固定报表和BI分析。
已经用了数据仓库,还需要数据湖吗?
多数情况下需要,数据仓库存大量原始日志成本高,查询压力大,数据湖补足原始数据留存、机器学习训练和合规归档场景,两者通常同时存在,各管一段。
为什么数据湖不能直接替代数据仓库?
数据湖没有强制结构,查询性能和数据质量保障弱于仓库,用数据湖做固定报表,容易出现口径不一致和查询延迟,数据仓库的约束型模型能保证指标一致,事实是,成熟企业通常让数据湖存原始多格式数据,数据仓库提供清洗后的指标层,二者按使用方式分工。