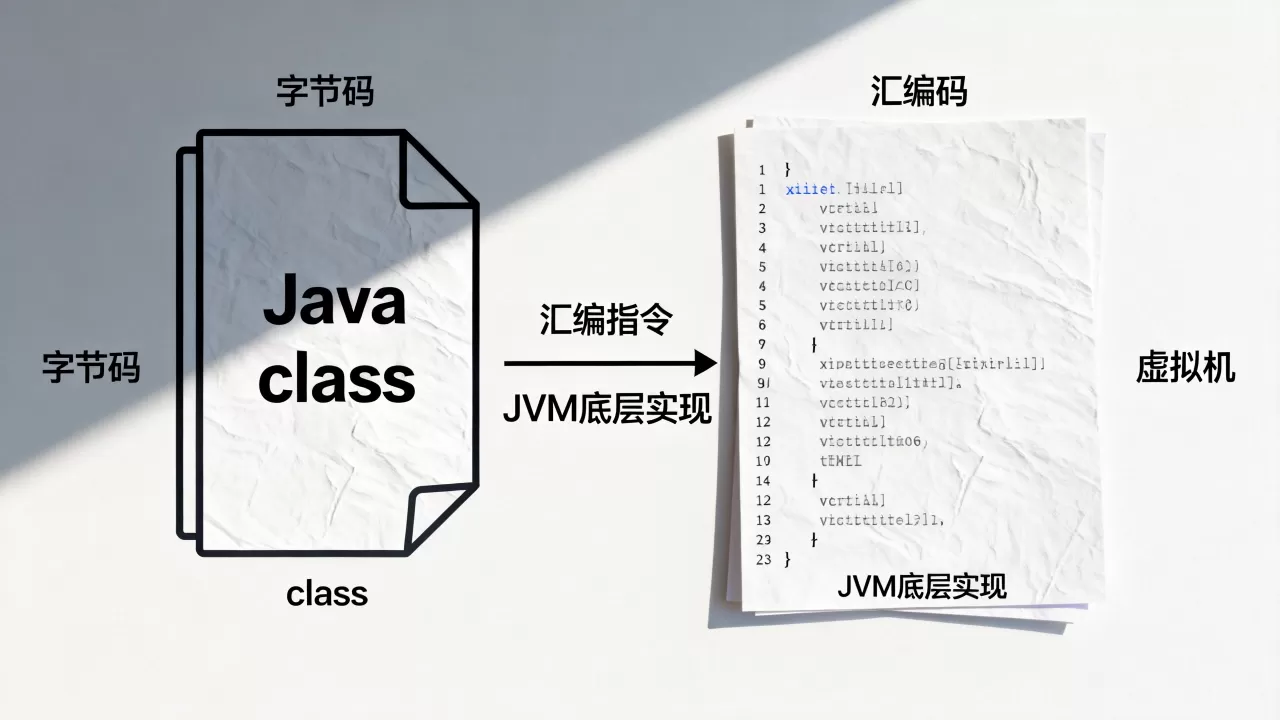
Java虚拟机把字节码变成汇编指令,核心路径是:解释器先顶着,热点方法被JIT编译器抓去,生成中间表示、做优化、选指令、分寄存器,最后由后端吐出机器码,反汇编出来就是汇编指令。 所以汇编指令不是JVM直接“翻译”的文本,而是机器码的阅读形态。
Java虚拟机字节码转汇编指令全过程解析
类加载与字节码解析:翻译前的备料
类加载器把.class文件加载到内存,经过验证、准备、解析、初始化后,字节码指令存放在方法区,你写下的aload_0、invokevirtual、iadd,此时还是JVM能读懂的“中间语言”。
执行引擎有两种选择:解释执行和编译执行,解释器逐条读取字节码,查表跳到预定义的机器码片段,启动快,但峰值性能有限,JIT编译器则负责把热点代码编译成高度优化的本地机器码。
解释执行与热点探测:谁会被编译
JVM不会一上来就编译所有方法,它靠热点探测决定优先级:
- 方法调用计数器:记录方法被调用的次数。
- 回边计数器:记录循环体回跳的次数。
- 阈值由
-XX:CompileThreshold控制,分层编译下各层阈值不同。
当计数器超过阈值,编译任务提交给JIT线程,分层编译默认开启,参数是-XX:+TieredCompilation,0层解释执行,1到3层由C1编译,4层由C2编译,C1编译快、优化保守,适合启动阶段;C2编译慢、优化激进,适合长时间运行的服务端应用。
行业共识认为,现代JVM的峰值性能很大程度上依赖JIT编译质量,没有JIT,Java很难在计算密集型场景和C++、Rust正面竞争。
Java虚拟机字节码转汇编指令全过程之编译阶段拆解
从字节码到高级中间表示
C2编译器拿到字节码后,先构建高级中间表示,HotSpot里叫Ideal Graph,每个节点代表一个操作,比如iadd变成AddI节点,getfield变成LoadField节点,此时中间表示与机器无关,只描述数据依赖和控制流。
优化:内联、逃逸分析、循环展开
优化阶段是JIT的“主战场”:
- 方法内联:把被调用方法体直接塞进调用者,消除调用开销,内联阈值由
-XX:MaxInlineSize和-XX:FreqInlineSize控制。 - 逃逸分析:判断对象是否逃出方法或线程,不逃逸的对象可以标量替换、锁消除,甚至直接在栈上分配。
- 循环展开:减少循环控制指令,增加指令级并行。
- 常量传播、死代码消除、公共子表达式消除:常规但有效。
业内专家指出,分层编译是平衡启动速度和峰值性能的关键设计,没有分层编译,要么启动慢,要么峰值低。
指令选择与寄存器分配
优化后的高级中间表示会下沉为低级中间表示,LIR与目标CPU架构绑定,指令选择把AddI节点映射为x86的addl或ARM的add,然后进入寄存器分配:虚拟寄存器映射到有限的物理寄存器,不够就溢出到栈槽,图着色是常见算法,目标是最小化内存访问。
汇编器与代码缓存
后端汇编器把最终指令序列编码成二进制机器码,写入代码缓存,代码缓存大小有限,由-XX:ReservedCodeCacheSize控制,缓存满后JIT停止编译,新热点方法只能继续解释执行,性能会明显下降,如果优化假设失效,比如类层次结构变化,JVM会触发去优化,从编译代码退回解释执行。
如何查看JVM生成的汇编代码?PrintAssembly与hsdis实操
准备hsdis插件
据OpenJDK文档,hsdis是独立插件,不随JDK默认提供,你需要下载或自行编译,然后放到对应目录:
- Linux:
libhsdis-amd64.so放到$JAVA_HOME/lib/server/ - macOS:
libhsdis-amd64.dylib放到$JAVA_HOME/lib/server/ - Windows:
hsdis-amd64.dll放到%JAVA_HOME%binserver
启动参数与命令
写一个简单测试类:
public class Test {
    public static int add(int a, int b) { return a + b; }
    public static void main(String[] args) {
        for (int i = 0; i < 100000; i++) { add(i, i + 1); }
    }
}
运行以下命令:
java -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly -XX:CompileCommand=compileonly,Test::add Test
常用辅助参数:
-XX:+PrintCompilation:查看编译事件和级别。-XX:+PrintInlining:查看内联决策。-XX:+TraceDeoptimization:查看去优化原因。-XX:+LogCompilation:生成编译日志,可用JITWatch可视化。
解读汇编输出
输出通常包含方法名、编译级别、汇编指令、机器码字节,重点看:循环体内是否有冗余内存访问,边界检查是否被消除,锁是否被消除,内联是否发生,不要被满屏汇编吓到,先定位方法入口和循环入口。
不同JVM实现字节码转汇编指令对比:HotSpot、OpenJ9与GraalVM
| JVM实现 | JIT策略 | 汇编生成特点 | 适用场景 |
|---|---|---|---|
| HotSpot C1/C2 | 分层编译 | 成熟,优化激进,诊断工具丰富 | 通用服务端 |
| OpenJ9 | JIT + AOT | 启动快,内存占用低,共享类缓存 | 云原生、容器 |
| GraalVM | Graal JIT / Native Image | 用Java写JIT,支持AOT原生镜像 | 微服务、Serverless |
HotSpot最广泛,-XX:+PrintAssembly生态最完整,OpenJ9在容器环境省内存,GraalVM Native Image在构建时就把字节码编译成汇编,运行时没有JIT预热。
本地环境JIT编译字节码转汇编指令实操步骤
第一步:触发热点方法
循环调用目标方法,让调用计数器超过阈值,可以配合-XX:CompileThreshold=1000快速触发。
第二步:获取编译日志
运行-XX:+PrintCompilation,观察输出中是否出现Test::add
以及编译级别,级别4表示C2编译。
第三步:定位汇编代码
加上-XX:+PrintAssembly和-XX:CompileCommand=compileonly,Test::add,只输出目标方法,避免日志爆炸。
第四步:分析并调参
如果发现方法未内联,检查-XX:MaxInlineSize,如果代码缓存频繁满,增大-XX:ReservedCodeCacheSize,如果去优化频繁,查看-XX:+TraceDeoptimization定位原因。
影响字节码转汇编指令质量的关键因素
- 分层编译策略:C1和C2的阈值设置。
- 代码缓存大小:缓存满会停止编译。
- CPU架构与指令集:x86、ARM、RISC-V生成的汇编不同。
- 去优化频率:激进优化失败会退回解释执行。
- 内联阈值:决定多少方法体能被塞进调用者。
- 逃逸分析开关:
-XX:+DoEscapeAnalysis影响标量替换和锁消除。
Java虚拟机字节码转汇编指令常见问题解答
JVM一定会把字节码编译成汇编指令吗?
不一定,解释器可以一直执行字节码,但热点代码通常会被JIT编译,长期运行的服务端应用,多数热点方法会生成机器码,短命进程可能大部分时间都在解释执行。
为什么同一个Java方法在不同机器上生成的汇编指令不同?
因为JIT后端针对目标CPU架构生成指令,x86生成x86汇编,ARM生成ARM汇编,操作系统、JVM版本、编译参数也会影响最终结果。
字节码转汇编指令需要付费工具吗?
不需要,OpenJDK提供-XX:+PrintAssembly等诊断参数,hsdis是开源插件,HotSpot、OpenJ9、GraalVM的基础功能均免费,商业支持服务另计,但查看汇编指令本身不收费。
Java虚拟机把字节码转汇编指令的过程,本质是解释器、JIT编译器、中间表示优化、指令选择与寄存器分配协同工作的流水线,理解这条链路,你就能用PrintAssembly等工具定位性能瓶颈,而不是停留在“JVM会优化”的模糊印象里。