服务器自动关机,多数情况下不是“中邪了”,而是硬件保护机制、供电异常、系统崩溃或安全攻击四类原因在作祟,排查的核心思路很简单:先看日志,再查温度,最后测电源,按顺序走一遍基本能找到真凶。
服务器自动关机原因排查的第一步:先看硬件温度
服务器和普通电脑最大的区别在于,它往往7×24小时不间断运行,长期高负载运转时,CPU和内存产生的热量相当惊人,机房空调故障、风扇老化、散热片积灰,都会让设备温度迅速飙升。
温度过高会触发硬性保护机制
行业共识认为,CPU有设计阈值温度(Tjmax),一旦核心温度越线,主板硬件保护机制会直接切断供电,强制关机,这个过程不经过操作系统,不会留下软件层面的报警记录,误以为“服务器无故关机排查”无从下手是很多运维朋友的第一反应。
具体场景来说:
- CPU温度超过90℃(不同型号阈值有差异),服务器直接断电保护
- 硬盘温度超过60℃,部分企业级硬盘会主动掉线甚至关机
- 主板南桥/VRM供电模块温度过高,同样会触发保护逻辑
排查方法很直接:进服务器BMC/IPMI管理界面查看传感器读数,主流厂商(戴尔iDRAC、惠普iLO、华为iBMC)都有温度监控面板,过去24小时温度曲线能一眼看出散热是否出了大问题。
物理环境也是重点检查对象
许多机房机柜存在“局部热点”问题,上下设备密集堆叠、机柜前后门封闭、空调出风口被遮挡,都会让服务器进风温度远超机房设定值。业内专家指出,不少自动关机案例并非服务器本身故障,而是机柜散热设计不合理导致温度反复越线。
排查温度问题时,顺手检查以下几个方面:
- 服务器前面板进风口是否被网线或标签纸堵住
- 风扇转速是否异常(转速一直满转并伴随噪音,说明散热效率下降)
- 机房空调出风温度是否达标,多数大型机房的送风温度在18-27℃之间
- Linux下执行
apt install lm-sensors && sensors,Windows下用HWiNFO等工具直接读温度
电源与供电系统:服务器无故关机排的隐藏大佬
温度查过了没问题,下一步就要怀疑供电。服务器对电源波动极其敏感,电压跌落几十毫秒都可能触发关机重启,这是物理机场景里最容易被忽略的一块。
电源自身老化与功率不足
电源模块使用三年以上,电容老化导致输出纹波变大,在高负载场景下容易触发电源保护机制,如果服务器硬件做过扩容(加装GPU、多块硬盘、高功耗CPU),原配电源功率可能已接近满载甚至超载,这种情况通常表现为:平时运行正常,一旦跑满负载或跑批任务,服务器就自动关机。
检查电源状态的实操思路:
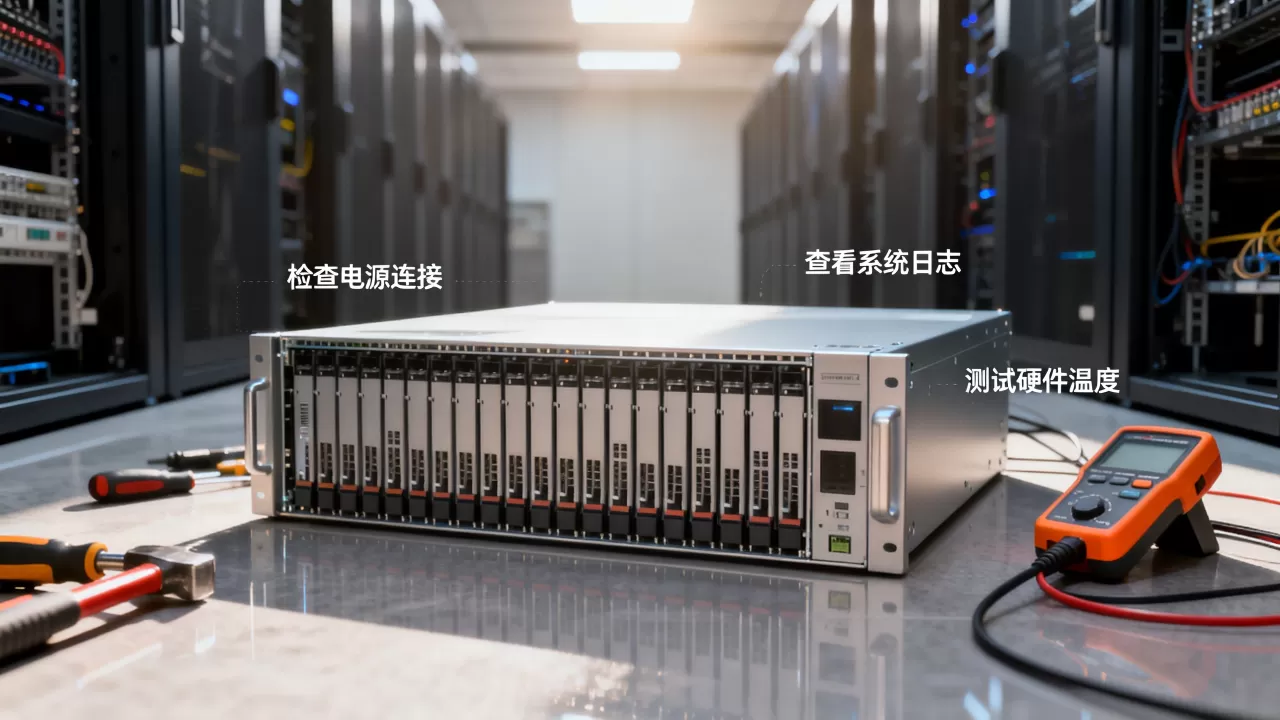
- 在BMC界面查看电源当前功率和历史峰值功率
- 对比电源额定功率,确认是否在70%负载以下运行
- 双电源服务器尝试互换电源模块,观察是否触发同一故障
- 检查电源指示灯是否由绿色变为琥珀色或闪烁
UPS和供电线路的“隐性断点”
机房供电链路是:市电→UPS→机柜PDU→服务器电源,任何一个环节出问题都会导致服务器掉电关机,常见场景包括:
- UPS电池老化,市电波动瞬间切换逆变失败
- PDU插口松动,服务器电源线接触不良
- 同一PDU上设备过多,过载跳闸引起整个机柜断电
- 机房大功率设备启动时压降过大,连累相邻服务器重启
用逐级排除法可以快速缩小故障范围:如果同一机柜多台设备同时关机,大概率是上游供电问题;只有单台关机,则优先怀疑这台服务器的电源模块。
系统与应用层面的隐形原因排查方法
硬件排完了,接下来要看软件,很多“服务器自动关机怎么回事”的求助帖,最后查下来都是系统配置或应用层问题。
Windows系统的关机日志怎么看
打开事件查看器(eventvwr.msc),依次展开Windows日志-系统,按时间筛选关机前后的记录,重点看三个事件ID:
- 事件ID 1074:用户或程序主动发起关机,会记录发起者和原因代码
- 事件ID 6008:系统异常终止,上次关机属于意外断电或死机
- 事件ID 41:系统未正常关机就重新启动,属于内核级断电记录
如果看到1074事件且原因是“其他(计划外)”后跟着来源为Kernel-Power,基本能确定是有人执行了关机命令,再用PowerShell命令Get-WinEvent -FilterHashtable @{LogName='System'; ID=1074} | Select -First 5 | Format-List可列出最近5条主动关机记录。
Linux服务器的日志排查命令
有正常日志记录但意外关机,需要关注内核崩溃或OOM(内存溢出)场景,常用命令包括:
journalctl -xe -n 100:查看最近100条系统日志last -x shutdown reboot:查看重启和关机历史dmesg | tail -50:检查内核输出末尾是否有关机/崩溃线索
Linux上新增的关键词是Process X killed by signal 9(进程被强制终止)和Out of memory: Killed process(内存耗尽触发OOM Killer)。如果OOM Killer杀掉的是关键系统进程,系统可能进入不稳定状态并触发自动关机。
计划任务和定时脚本的“定时炸弹”
检查系统计划任务,不少自动关机是被人为配置的定时任务触发。
- Windows使用
taskschd.msc查看计划任务库 - Linux使用
crontab -l和/etc/cron.d/目录检查定时脚本 - 重点排查
/sbin/shutdown
、
poweroff、init 0等关机命令的关键词内容
某台机器经常在凌晨四点自动关机,最后排查下来是上一任运维配置了一个每晚清理临时文件的脚本,脚本末尾误加入了init 0,这类问题查询epoc基础就有多种触发源,不能只查日志本身。
安全攻击如何伪装成“服务器自动关机”
近年来,勒索病毒和挖矿木马攻击服务器的频率明显上升,攻击者得手后不一定会马上加密文件,有时会先植入后门脚本,在特定时间点执行关机、重启等破坏性操作,干扰安全人员排查。
远程关机与远程重启的伪装场景
Windows服务器默认开启远程关机权限,攻击者拿到管理员权限后,通过shutdown -r -t 0的方式即可实现远程重启,这类操作在事件查看器中会留下源IP和登录方式,但若攻击者已篡改日志服务,痕迹也可能被清除。
Linux服务器若开启了SSH且使用弱口令,攻击者登录后直接执行reboot或shutdown -h now,在排查中重点留意:
last命令查看近期登录记录中有无异常IPauth.log/安全日志查看大量SSH暴力破解失败记录- 检查是否存在异常的
/tmp目录文件或新加的开机自启项 - 使用
lsof -i查看是否有异常对外连接
云服务器被恶意操作的应急措施
云服务器宕机怎么办这个问题,很多场景和黑客入侵有关,安全组配置不当导致管理端口暴露在公网是主要原因,部分云厂商的管理控制台支持“操作记录审计”,可以在控制台查询是否有陌生账号执行过“强制关机”操作。
建议对核心业务服务器做以下安全加固:
- 关闭不必要的远程管理端口,用堡垒机统一运维入口
- 开启云平台的安全告警与登录异常提醒
- 定期排查SSH密钥和账号权限,禁用半年以上未使用的僵死账号
- 安装主机入侵检测系统(如云安全中心Agent),提前感知恶意登录行为
物理机和云服务器场景下的不同排查策略
不同形态的服务器,“自动关机”的排查侧重点有明显差异,物理机偏向硬件和机房环境,云服务器则偏向宿主机状态和运维配置。
物理机场景:重点看BMC和硬件健康
物理服务器的BMC管理芯片独立于操作系统运行,即使系统死机也能查看硬件状态,排查路径推荐:
- 登录BMC管理界面查看告警记录和传感器历史曲线
- 检查硬驱SMART自检结果,确认有无磁盘异常掉线和坏道
- 使用
ipmitool sel list查看系统事件日志 - 若内存报错频繁,用MemTest86等工具做离线内存测试
云服务器场景:先排除宿主机和迁移逻辑
云服务器关机原因与物理机有本质区别,运行中的云主机突然关机,通常是以下几种情况:
- 宿主机宕机或维护

,虚拟机被强制迁移或关闭
- 账号欠费,云平台直接停机(部分平台会先发通知再停机)
- 安全策略触发,云盾检测到挖矿行为自动隔离实例
- 资源配置不足,内存或CPU超卖导致实例失去响应后被平台重启
处理原则很简单:登录云平台控制台查看“实例运行状态”和“操作审计”,再查工单记录和短信通知,若确认是宿主机问题导致,多数云服务商会自动迁移至新宿主机恢复运行,无需自行干预。
服务器自动关机到底怎么彻底预防
整套排查走完之后,最终极的解决方案总归回归到“监控+告警+预案”三个步骤,想让服务器不再反复出问题,就得建立完整的运维闭环。
核心动作清单如下:
- 部署温度监控并对接告警,超过85℃就开始通知值班人员
- 为服务器配置冗余电源和UPS,重要业务保证双路供电至少30分钟以上
- 在安全组层面限制管理端口来源IP,公共网络一律拒绝直接访问
- 统一收集系统日志到集中日志平台,避免服务器关机后日志丢失
- 定期检查服务器自检状态和硬件健康指标,形成月度巡检报告
还有一个最容易被忽视的动作:把服务器的“自动重启”响应策略设置为异常断电后保持关机状态,很多设备默认会自动上电,频繁的异常重启反而可能加剧文件系统损坏,多数服务器的BIOS/BMC中均有类似“Restore on AC Power Loss”选项,将其设为“Last State”或“Stay Off”才更稳妥。
常见通用问题解答
服务器自动关机后无法开机怎么办?
按“最小化硬件”原则处理:拔掉所有非必要设备(数据盘、扩展卡、GPU),仅保留CPU、单根内存和系统盘尝试开机,若能进入系统,逐步加回硬件定位故障源,若仍无法开机,检查电源指示灯、主板告警灯和BMC日志,硬件级故障建议直接联系设备厂商售后,部分品牌提供下一天上门服务。
服务器频繁自动重启和自动关机有什么区别?
重启是指操作系统先关闭再启动,通常由系统补丁更新、内核崩溃、电源短暂闪断引起;关机是指设备进入完全断电状态,多为硬件保护或电源彻底中断引发,排查时优先区分现象:若能在日志中看到完整的关机过程记录,那更像主动触发或软件问题;若日志戛然而止毫无征兆,基本可锁定硬件或供电问题。
Linux服务器没有日志突然关机是怎么回事?
如果/var/log/messages和journalctl中完全没有关机前的记录,大概率是硬件层掉电保护生效或物理断电,操作系统没来得及写日志,此时应查看IPMI系统事件日志,里面会记录电源复位、过温保护和机箱入侵等底层触发信号,若IPMI也无一条记录,直接检查服务器所在机柜的供电线路和PDU状态。