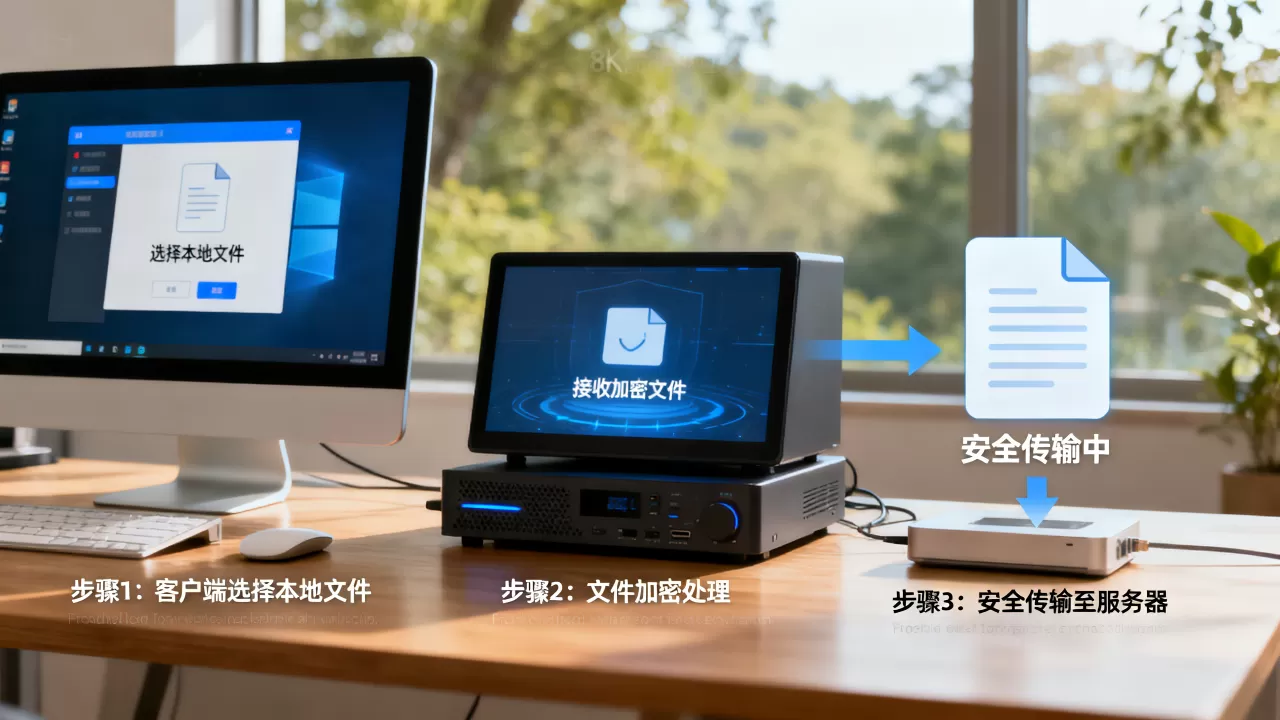
服务器获取客户端本地文件的唯一安全路径,是让用户通过浏览器主动选择文件并上传,借助HTTP请求将数据传至服务端,任何绕过用户操作的“直接读取”方案都行不通。
服务器如何安全获取客户端本地文件,前提是理解浏览器的规矩
很多刚接触前后端开发的同学都会问一个问题:网页能不能像桌面软件那样,悄悄读取我电脑里的文件?答案是否定的,这不是技术做不到,而是浏览器安全模型根本不允许。
浏览器运行在沙箱环境中,脚本无法直接访问客户端文件系统,所谓“安全获取”,核心原则只有一条:用户主动授权 + 浏览器提供入口,用户点击选择文件、拖拽文件到页面,或者粘贴剪贴板里的截图,这些行为才算“授权”,服务器拿到文件的路径不是重点,拿到文件才是重点。
也正因如此,你需要先分清两个概念:读取本地文件用于展示和上传文件到服务器,比如一个网页让用户选择图片后缩略图预览,这是用 FileReader 在浏览器本地读取;而把图片传回服务器存起来,才是你真正关心的“安全获取”,两种场景的技术路径完全不同,不要混为一谈。
标准文件上传流程,服务器获取客户端本地文件的具体路径
这是目前最通用、兼容性最好的方案,整个过程可以分为三个环节,每一步都有具体的操作路径。
前端如何收集用户选择的本地文件
第一步是让用户选文件,HTML 里最基础的写法是:
<input type="file" name="file" accept=".jpg,.png">
这里有几个细节直接影响后续流程:
- accept 属性只是过滤弹窗里的可见选项,用户仍然可以切换格式,后端必须二次校验。
- multiple 属性允许用户一次选择多个文件,后端对应接收的是一个文件数组。
- 如果不加 accept,用户可以在弹窗里选任意类型的文件,风险更高。
用户选完文件后,浏览器会生成一个 File 对象,这个对象包含文件名、大小、类型、最后修改时间等信息,你可以通过 input.files[0] 拿到它,这里有一个常见的误区:File 对象里不包含文件的本地绝对路径,浏览器出于安全考虑,已经抹掉了 C:Usersxxx 或 /home/xxx 这类信息,你看到的是一个随机字符串加文件名。
那些试图通过 input.value 获取本地完整路径然后直接传给服务器的做法,在大多数现代浏览器里已经拿不到路径了,只能拿到文件名,这恰恰是安全机制在起作用。
把文件数据从客户端送到服务端的具体操作
拿到 File 对象后,需要把它封装成可传输的数据,行业公认的推荐做法是用 FormData + XMLHttpRequest 或 fetch,也就是 multipart/form-data 编码方式,操作步骤如下:
- 创建 FormData 实例。
- 通过
formData.append('file', file)把文件对象追加进去。 - 用 fetch 或 axios 发送 POST 请求到后端接口。
const formData = new FormData();
formData.append('file', fileInput.files[0]);
fetch('/api/upload', {
  method: 'POST',
  body: formData
});
注意,发送 FormData 时不要手动设置 Content-Type 为 multipart/form-data,浏览器会自动生成一个带有 boundary 分隔符的 Content-Type,你如果手动设置,反而会丢失 boundary 导致后端解析失败。
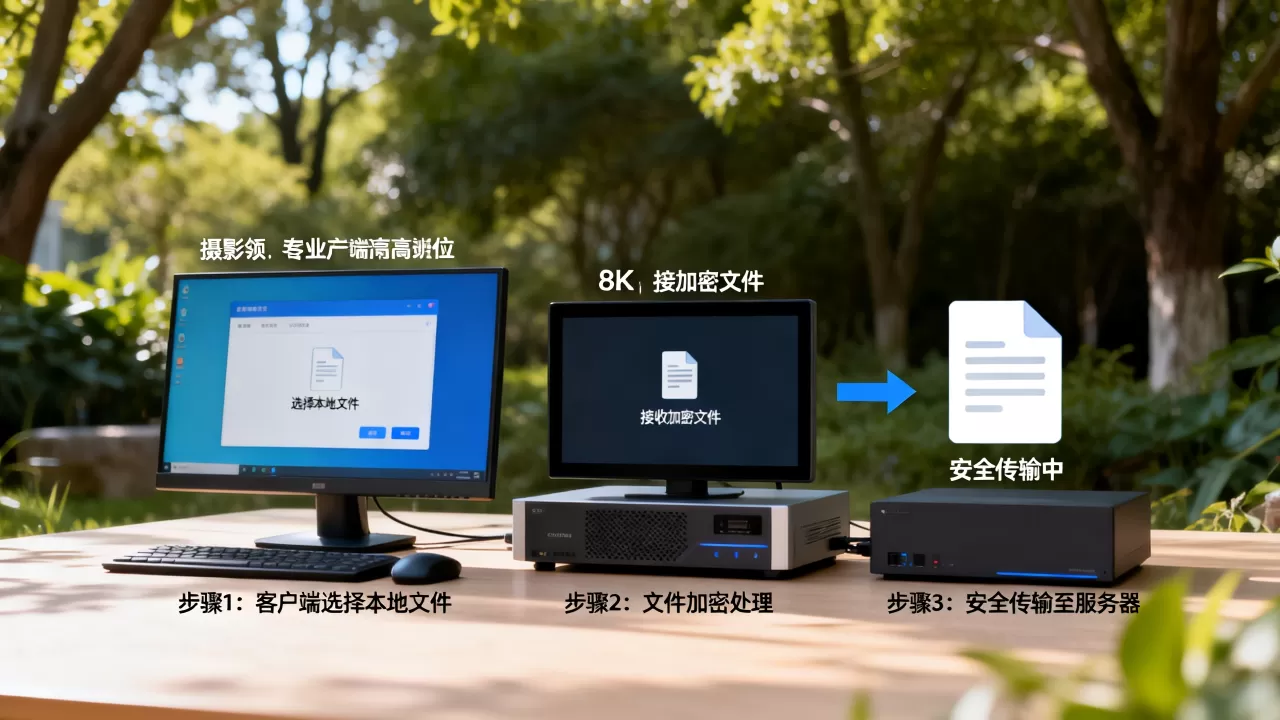
你可以在浏览器开发者工具的 Network 面板里看到这次请求的详情,请求头里的 Content-Type 长得像这样:
multipart/form-data; boundary=----WebKitFormBoundary7MA4YWxkTrZu0gWboundary 分隔符后面跟着的是每个字段的内容和分隔标记,这就是服务器解析文件的原始依据。
后端收到请求后,不同语言怎么接收和处理
后端接口负责解析 multipart 数据,以 Java Spring Boot 和 Python Flask 举例,它们的处理方式各不相同:
- Java Spring Boot:使用
MultipartFile参数接收,调用transferTo()方法把文件保存到指定目录,或者用getBytes()拿到字节流自行处理。 - Python Flask:通过
request.files.get('file')获取文件对象,调用.save()方法保存。 - Node.js Express:原生不支持 multipart 解析,需要借助 multer 这类中间件,配置 dest 目录后,文件会自动落盘。
以下是一个 Python Flask 的最小示例:
from flask import Flask, request
import os
app = Flask(__name__)
@app.route('/api/upload', methods=['POST'])
def upload_file():
    f = request.files.get('file')
    if f is None:
        return {'msg': 'no file'}, 400
    save_path = os.path.join('/data/uploads', f.filename)
    f.save(save_path)
    return {'msg': 'ok', 'path': save_path}
文件保存到服务器磁盘后,你就完成了“安全获取”的全部过程,后续无论你要做图片压缩、病毒扫描还是转存对象存储,操作对象都是落地的这份文件或它的字节流。
大文件上传方案对比,服务器怎么接住几百MB的文件
前面讲的 multipart 方案,适合上传体积适中的文件,比如几张照片、一个PDF文档,但如果你面对的是视频素材、系统镜像、项目压缩包,那它就可能水土不服。
这类文件的体积往往超过几百MB甚至几个GB,直接一次性上传,会面临几个现实问题:请求超时、内存占用过大(用 PHP 默认配置传大文件很容易爆内存)、网络中断后需要重头再来。
面对这些痛点,分片上传成了目前最常见的大文件方案,它把一个大文件切成多个小片段,逐个上传,服务器收到全部片段后再拼接回完整文件,以下是核心步骤:
大文件上传分片的完整流程和关键参数
- 前端计算文件哈希:用 SparkMD5 或 Web Crypto API 计算文件的唯一标识,用于后续秒传判断和断点续传定位。
- 切片:把文件按固定大小切成块,常用的分片大小是 2MB 或 5MB,看网络条件而定,内部网络可以稍微大一些。
- 并发上传:逐个发送每个分片,每个分片请求里附带文件标识、分片序号和总片数。
- 服务端临时保存:后端收到每个分片后,没必要急着合并,先把分片存在一个以文件标识命名的临时目录里。
- 合并文件:所有分片上传完成后,前端发一个“合并请求”,后端按照分片序号顺序拼接所有临时分片,生成最终文件。
- 校验:合并后计算整个文件的 MD5,与前端提交的哈希比对,不一致就说明拼接出错或文件不完整,返回失败并清除临时目录。
你也可以把一个系统从最初的全量上传演进到带断点续传的分片上传,断点续传的本质就是:每次上传前先查询“服务端已存在哪些分片”,只上传缺失的分片,这比无脑重试要高效不少。
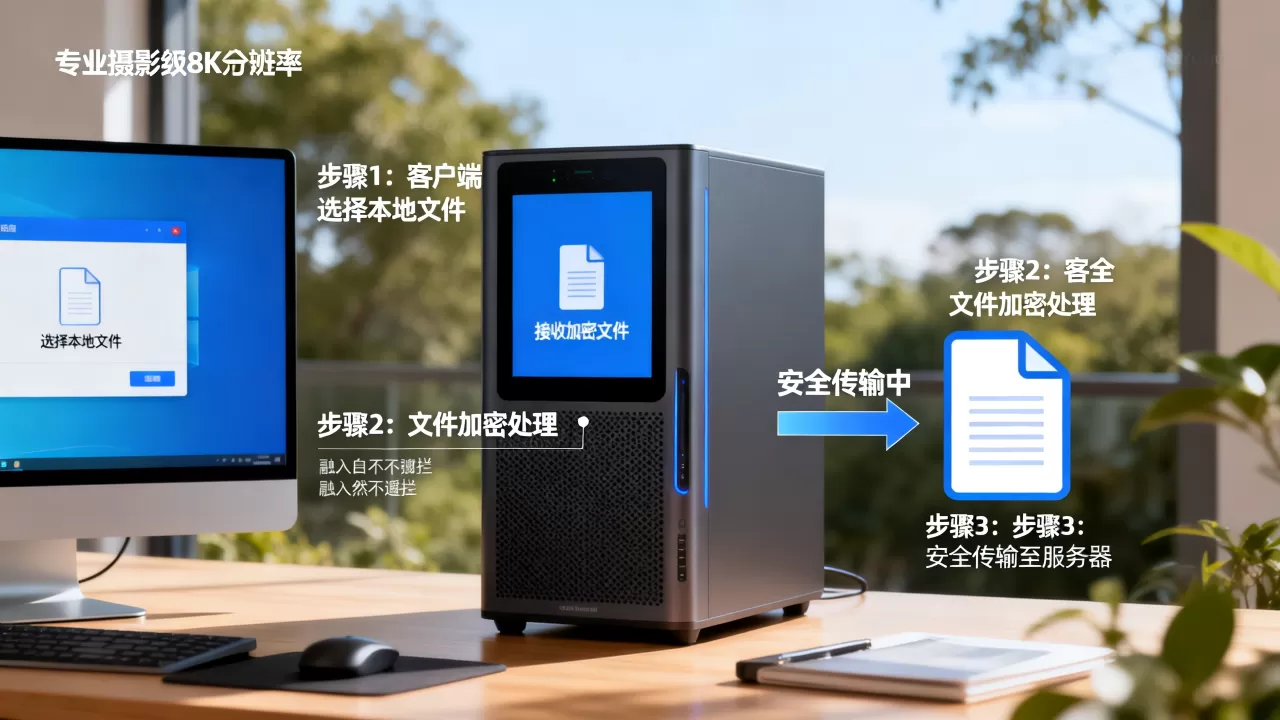
各方案对比,方便你直接做技术选型
| 方案 | 适用场景 | 优点 | 劣势 |
|---|---|---|---|
| 原生 multipart 上传 | 20-50MB以下小文件 | 实现简单,无额外依赖 | 大文件容易超时失败 |
| Base64 编码传输 | 兼容老系统接口 | 纯文本传输便于调试 | 体积膨胀约33%,效率低 |
| 分片上传 | 几百MB以上大文件 | 支持断点续传,失败成本低 | 需要前端和后端配合较多 |
| 秒传(校验哈希) | 重复文件多,比如课件、素材库 | 不必真正传文件 | 无法对首次上传起效 |
| 对象存储直传(OSS直传) | 有云存储服务的团队 | 减轻服务器带宽压力 | 需要额外配置签名和回调 |
行业共识认为,上传方案没有绝对的“最优”,关键还是要看你具体的业务场景,个人网盘项目优先考虑分片;企业内网传超大工程包,分片加局域网限速比较合适;中小站点没多少流量,简单的 multipart 完全够用。
场景差异:企业局域网部署环境下,文件上传的坑该怎么填
服务器如何安全获取客户端本地文件,这个问题在不同部署环境下,答案的侧重点也不同,实际项目里,很多团队会把服务部署在企业局域网或内网服务器上,用户通过内网地址访问,这种场景和公网环境有一些很现实的差异。
HTTPS与跨域问题在内部系统里同样存在
内部系统最容易踩的第一个坑就是跨域,前端页面跑在 20.1.5:8080,后端接口跑在 20.1.6:9000,两者端口不同,浏览器默认就会拦截跨域请求,解决办法很简单,后端接口的响应头里配置:
Access-Control-Allow-Origin: http://10.20.1.5:8080
Access-Control-Allow-Methods: POST, OPTIONS
Access-Control-Allow-Headers: Content-Type
如果你的前后端都跑在同一个站点下,用 Nginx 做反向代理把 /api 转发到后端服务,就完全没有跨域问题,也省掉很多关于预检请求的烦琐调试,这是不少人推荐的做法。
第二个坑是局域网如果用了 IP 地址访问,很多浏览器会认为 http://192.168.x.x 不是安全上下文,部分浏览器 API 会被限制,尤其是大文件分片用到的 File System Access API,它要求在安全上下文中才能用,也就是必须是 HTTPS 或 localhost,如果你们内网前面架了 Nginx 并且配了自签证书,那这个问题就迎刃而解。
伪造请求和路径穿越
内网环境相对封闭,很多人会放松警惕,但内网并不等于安全,伪造的 POST 请求依然可以打到你的上传接口上,绕过前端限制直接传个 .jsp 文件进来,服务器拿到后如果放在 Web 目录下再被解释执行,就是一个标准的 webshell 入侵路径。
服务端在保存文件时,永远不要直接使用用户提供的原始文件名,最佳做法是服务端自己生成一个随机文件名,使用 UUID 或时间戳拼接随机数,扩展名则用白名单机制比对,保存目录也尽量不要暴露在静态资源路径下,Java 项目里别把文件直接存到 webapp/upload 下,应单独使用一个不可执行脚本的目录。
真实场景中,相当一部分安全事件就是由“文件名拼接+到保存路径”这种粗心操作引发的,把用户名或文件名当参数直接拼组成路径,攻击者再用 去穿越目录,严重的话会覆盖服务器上的配置文件,建议在代码里明确禁止文件名包含 和
字符,并且做好路径规范化处理。
本地小团队部署,前后端分离下的上传路径注意
如果你在自己带的团队中负责从零搭建一套带文件上传的功能,往往要注意前端资源和后端上传接口的域名关系,假如前端部署在 Nginx,后端单独跑在 ECS 服务器,那么上传接口很可能要走公网请求,这时候 Nginx 对报文体积的默认限制又会冒出来,多数 Nginx 默认允许客户端请求体大小是 1MB,超过就返回 413 错误,解决办法是在 Nginx 配置里增加:
client_max_body_size 100m;这些看似细枝末节,却是实际部署中最常遇到、也最容易排查半天的“鬼打墙”问题,优先把手上的基础路径理顺,再考虑更复杂的鉴权与加密。
服务器获取客户端本地文件的安全底线
回归最初的问题:服务器获取客户端本地文件,保障安全的基础有四个层面,缺一个都不行。
- 传输通道加密,强制 HTTPS,明文 HTTP 传输的文件内容可以被中间人窃取或篡改,尤其多文件包含身份证照片、合同文件时,不要有任何侥幸心理。
- 服务端校验文件类型,不要信前端传过来的 MIME type,要读取文件头部的魔数(Magic Number)来判断真实格式,JPEG 文件头通常是
FF D8 FF,PNG 是89 50 4E 47,如果用户把恶意脚本改成.jpg后缀,读魔数能把它揪出来。 - 上传目录禁止执行,在 Nginx 或 Apache 配置里,让上传目录只负责存放文件,不能解析任何脚本,这条规则能挡掉大部分以文件上传为入口的攻击。
- 限制上传大小和频率,后端必须设置文件体积上限和接口频率限制,防止有人利用上传接口灌满磁盘、消耗带宽。
很多安全事件不是攻击者用了多高级的手段,而是开发时压根没考虑这些基础项,比如用系统命令拼接的方式调用文件处理工具时,文件名里掺一个 ; rm -rf 之类的参数,命令注入就发生了,越接近用户输入的地方,越要谨慎。
Q&A:服务器如何安全获取客户端本地文件的常见追问
浏览器端有没有办法绕过用户操作直接读取文件?
没有,浏览器的沙箱模型和同源策略从底层禁止了网页脚本访问客户端文件系统,唯一例外是用户提前授予了持久化权限的 File System Access API,但依然要经过用户手势触发授权弹窗,而且浏览器支持的开放能力有限,并不适合做通用的本地文件获取。
后端保存上传文件时,还需要关注文件内容本身吗?
需要,多数情况下文件内容未必可信,例如上传 SVG 文件时,里面可以嵌入 JavaScript 脚本,如果这个文件可以被浏览器直接访问,就可能形成存储型 XSS 攻击,对图片做重新压缩、对上传的文档做病毒扫描,是规模稍大些的平台必须做的事。
分片上传和断点续传是所有后端语言都能实现吗?
分片上传的实质是拆分和合并字节流,Java、Go、Python、Node.js 等主流后端语言都可以实现,区别在于生态里的依赖和操作方式不同,Java 有现成的分片上传框架,Python 可以手动用文件读写来实现,真正决定上限的是存储层设计,本地磁盘、FastDFS、MinIO 等不同存储对分片合并的支持能力各不一样。