GPU服务器交付时按这份清单逐项检查,先看硬件外观和上电状态,再测驱动与满载性能,最后核对序列号和保修信息,缺一不可。
GPU服务器交付验收:为什么必须当场拆箱测透
很多团队收到GPU服务器后,插上电源跑个nvidia-smi就签收了,这个动作远远不够,GPU服务器单价高、功耗大、故障率集中在运输环节,多数情况下外观完好但内部GPU已经松动或静电击穿,行业共识认为,交付验收是唯一一次能免费更换部件的窗口期,过了这个节点,再发现问题就只能走售后流程,时间成本和沟通成本完全不同。
验收的核心逻辑是“全链路复现生产环境”,不要只在操作系统里看识别数量,要把GPU跑起来,模拟训练或推理时的负载,观察温度、功耗、降频行为,这样能筛掉绝大多数“能点亮但一压就崩”的暗病。
GPU服务器交付检查硬件清单:从机箱到PCIe插槽
外观与结构检查
先看机箱外壳有无明显磕碰、变形,运输箱的防震泡棉是否完整,机箱内部用强光电筒照一遍,重点看:
- 显卡是否牢固卡在PCIe插槽上,是否有下垂变形,多卡机器必须看显卡支架是否贴合。
- 供电线缆是否插到位,尤其是8pin或12VHPWR接口,听到“咔哒”声才算锁定。
- 散热鳍片有无积灰或压扁,风扇叶片是否完整。
- 主板CPU供电区域和内存插槽有无烧灼痕迹。
硬件规格核对
对照采购合同逐项核对配置单,这一步不能省,常见问题是内存容量缩水、硬盘换品牌、GPU显存版本不一致。
用命令查看实际硬件信息:
lscpu | grep "Model name"
free -h
lsblk -d -o NAME,SIZE,MODEL
NVIDIA GPU则用nvidia-smi查看每张卡的型号、显存大小、GPU-UUID,注意核对是否为二手翻新卡,业内专家指出,翻新卡最容易在PCB板边缘留下焊油痕迹,且全卡SN码与金手指区域标签模糊。
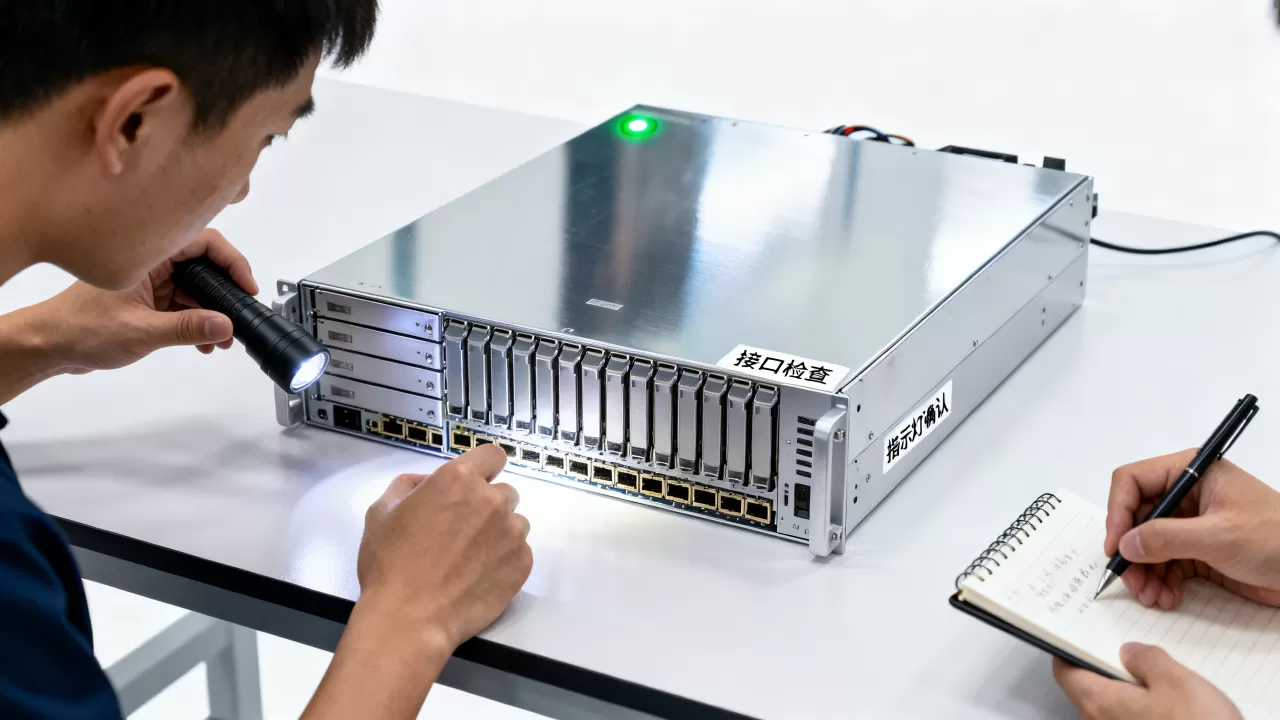
供电与散热初检
GPU服务器满载时功率惊人,检查电源模块数量与额定功率是否匹配,高端训练服务器通常需要4颗2000W以上电源,且支持冗余热插拔,如果实际配置是2颗电源,满载必然掉负载。
散热方面,运行ipmitool sdr list查看进风口温度、CPU温度、GPU周围环境温度,正常待机时GPU温度应低于50摄氏度,满载时不应超过85摄氏度(不同型号阈值有差异)。
GPU服务器驱动与系统检查:装对版本比装最新版重要
驱动和CUDA版本匹配
不要上来就装最新驱动,先确认你的深度学习框架需要的CUDA版本,PyTorch等框架对CUDA有严格兼容要求,推荐流程:
- 使用NVIDIA官方
configure-cuda脚本检测兼容性。 - 安装与框架匹配的驱动版本,例如CUDA 12.4对应Driver 550系列。
- 重启后运行
nvidia-smi确认驱动已加载,再运行nvcc -V确认工具链版本。
MIG与显存可见性验证
多卡机器容易出现显存大小不一致,例如四卡RTX 4090,其中一张被MIG切割过,可用显存只剩8G,此时nvidia-smi能看到设备,但实际算力被限制,验收时要查看每张卡的Memory-Usage和MIG Mode状态。
若启用MIG或vGPU环境,需要额外验证:
- 使用
nvidia-smi -L查看每张卡的实例状态。 - 确认GPU UUID与云平台或虚拟化层分配的资源一致。
- 测试从虚拟机或容器内访问GPU是否能正确分配到硬件资源。
GPU服务器性能测试怎么做:压测工具和判定标准
基础算力验证
跑一次官方提供的矩阵乘法基准测试,具体操作:进入NVIDIA的cuda-samples目录,编译
MatrixMul示例,比较实测算力与理论规格的偏差,行业普遍接受的结果是算力达到理论值的85%以上即可视为正常,如果低于80%,大概率是显存位宽问题或GPU降频。
也可直接用gpu-burn工具,命令:
git clone https://github.com/wilicc/gpu-burn
cd gpu-burn
make
./gpu_burn 60
该工具会让GPU满载运行60秒,观察温度曲线和功耗曲线,正常功耗应接近标称TDP,温度曲线平缓上升后稳定,如果测试中途报错或驱动崩溃,立刻验货拒收。
多卡通信带宽测试
训练场景对卡间通信敏感,使用nccl-tests工具验证NVLink或PCIe带宽:
./build/all_reduce_perf -b 8M -e 256M -f 8 -g 4
重点关注algbw和busbw两列数值,如果多卡带宽明显低于单卡带宽的拼接量,说明PCIe switch配置或NVLink连接有问题。
稳定性和故障注入
在压测过程中人为触发几条命令,观察系统反应:
- 手动切换GPU风扇为全速,确认无异常噪音。
- 运行
nvidia-smi -pm 1锁定性能模式,再压测一次。 - 在满载状态下插拔网线,确认不影响GPU任务。
这能模拟真实训练中偶发的外设抖动。
GPU服务器交付验收的常见误区和售后权益确认
只跑官方诊断工具就收机器
NVIDIA DCGM工具能检查硬件错误,但很多软件层面的兼容问题它发现不了,例如PyTorch的CUDA版本不匹配导致的算子编译失败,在DCGM测试中完全正常,必须用实际应用场景测试,哪怕只跑一个小的ResNet训练。
忽略ID和序列号登记
签收之前,把每张GPU的序列号抄下来,对照包装盒标签和机身贴纸,这一点在后续保修时极其重要,部分厂商售后要求提供GPU序列号才能报修,如果没有留存,只能拆机查看,耽误一天。
售后服务确认
- 确认保修期限从验收日还是发货日起算。
- 确认是否提供新的替换部件,而不是维修后再寄回。
- 确认远程支持响应时间,特别是7x24小时是否收费。
如果这些写在合同中就没问题,没写就在验收现场发邮件让销售确认。
GPU服务器租用还是购买:验收逻辑有什么不同
租用的GPU服务器通常由服务商预装机,到货时已装好驱动,这时候验收重点从硬件改为性能配额,例如云GPU服务器宣称“RTX 4090”,实际显存可能是满血,但PCIe通道可能被限制为x8,用lspci -v查看LnkCap和LnkSta确认链路速率。
采购自有服务器则按前述清单全流程走,租房服务器则把时间花在带宽测试和存储IOPS测试上,如果你所在城市有本地IDC机房,建议直接到机房现场插键盘操作,不少从外地发货的机器,经过长途运输后容易松动。
关于GPU服务器交付验收的Q&A
交付时发现GPU数量少一张,但外观完好,应该继续检查还是马上拒收?
应该立即停止测试,拍照留存,并联系销售确认缺卡原因,常见情况是显卡被临时拆走或发货错误,这时机器不要通电,保持原状等待厂商处理,继续测试可能被认为你已接受当前状态。
压测时蓝屏或死机,但重启后正常,这是否算验收不合格?
算,重启后能恢复正常不代表运输中没有损坏,通常由显存虚焊或供电模块电容老化引起,要求更换整机或相关GPU,不要接受“再观察”的建议。
验收清单里要不要包含价格核对?
要,但价格核对不属于硬件检测范畴,GPU服务器价格波动大,市场价与合同价可能相差数千元,但验收只认合同,重点确认配置单价是否与报价单一致,防止出厂时换用低规格型号。