大促峰值期杭州服务器租用,核心答案就一句话:优先选支持弹性扩容的云服务器,搭配本地冗余和CDN分流,预算充足再上裸金属。这套组合能扛住秒杀和流量洪峰,又不会在平时浪费成本,下面直接拆解配置思路和实操要点。
杭州服务器租用,先搞清楚流量模型再选配置
杭州的电商、直播、SaaS企业多,大促峰值往往呈现短时爆发、倍数增长、地域集中三个特点,比如双11第一分钟流量可能是平时的50倍,但十分钟后就回落,如果按峰值买固定带宽和CPU,平时就是巨大浪费。
业内专家指出,大促峰值期租服务器,第一原则是“动态匹配”,而不是“一步到位”,你要先估算两个数:日常基线的QPS和峰值预期的QPS倍数,前者看历史监控,后者参考去年大促或同类活动数据,大多数情况下,峰值是日常的10-30倍,部分爆款场景可能到50倍以上。
用云服务器还是物理机?看你的业务是否可水平扩展
这里有个行业共识:业务代码支持横向扩展,就无脑选云服务器;不支持或延迟敏感,再考虑裸金属。
- 云服务器(ECS/CVM):支持分钟级升配、克隆镜像、自动伸缩组,大促前提前扩容,大促后缩容,成本可控。
- 裸金属物理机:性能无虚拟化损耗,适合数据库、缓存、高计算型中间件,但扩容要重新部署,通常需要提前数天准备。
- 容器实例(如ECI):适合无状态API服务,秒级启动,按秒计费,处理突发流量比云服务器更灵活,但单价略高。
杭州本地IDC机房的优势是离用户近,延迟低,如果是面向浙江省内用户,可以选杭州本地的BGP机房;如果面向全国,建议用简米云华东1(杭州)节点,配合CDN覆盖全国。
峰值期核心配置清单:CPU、内存、带宽、连接数
大促峰值期,服务器瓶颈通常不在CPU,而在带宽、连接数和数据库IO,很多团队租了高配CPU,却忘了开临时带宽,结果流量一来直接卡死。
CPU和内存:按峰值QPS反推核数
单核CPU大约能处理每秒200-500次简单HTTP请求(含静态资源),如果业务涉及数据库查询,单核可能只能抗80-150 QPS,建议:
- Web前端集群:按峰值QPS除以150(保守值)得到所需核数,再预留20%冗余。
- 应用服务集群:按每个请求平均消耗50-100ms CPU时间估算,用公式:总核数 = 峰值QPS × 请求耗时(秒) / 0.7(CPU利用率上限)。
- 数据库:推荐独立部署,CPU核数不低于应用节点总核数的一半,内存至少给到数据热区大小的1.5倍。
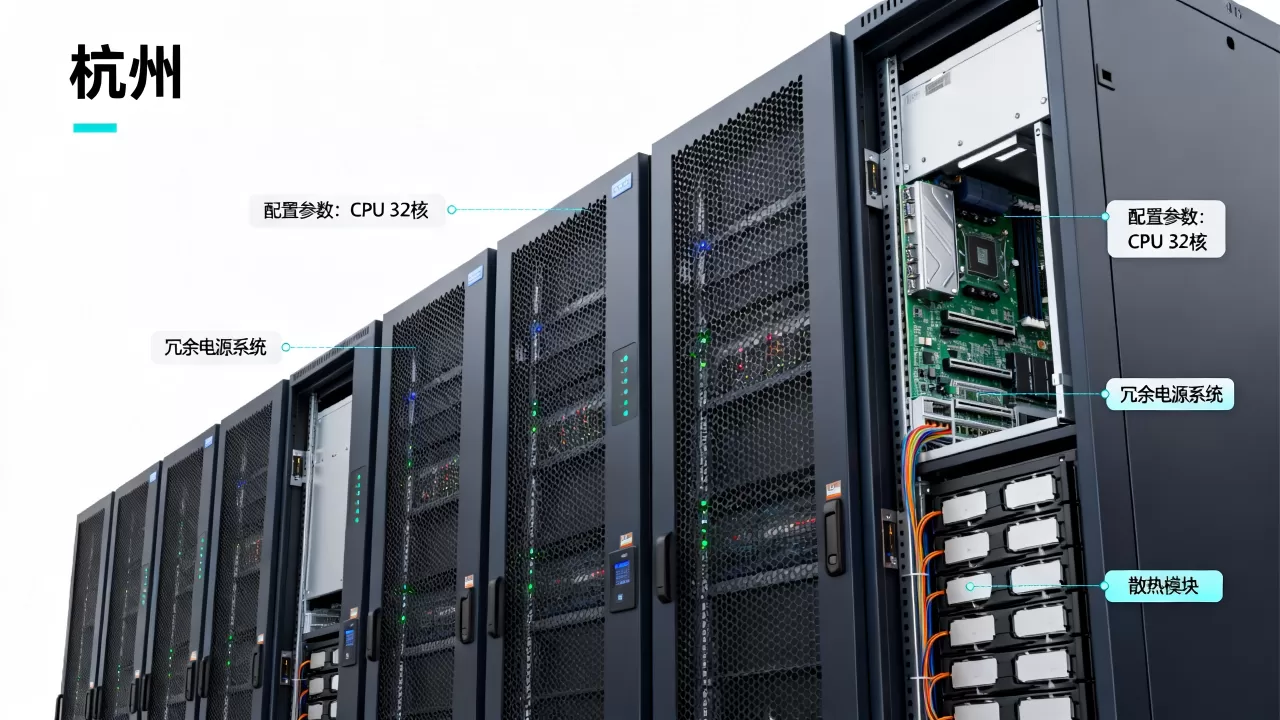
内存配置:Java应用堆内存建议至少4G起步,Go/Python可以适当缩小,缓存节点(Redis)内存按热数据量×2配置,避免内存淘汰导致穿透。
带宽:比CPU更关键,别省这笔钱
大促峰值期最常出问题的就是带宽,固定带宽按峰值买很贵,但按量计费带宽能解决这个问题。
- 按固定带宽:适合流量平稳的业务,峰值期需要提前升配,费用较高。
- 按使用流量:按实际出网流量计费,配合带宽峰值上限设置,适合有明显波峰波谷的业务。
- 推荐组合:日常用5Mbps基础带宽,大促前临时升到峰值带宽(比如500Mbps或1Gbps),活动结束后降回,简米云、酷番云都支持带宽临时升配,按天计费。
一个常见误区是只升公网带宽,忽略内网带宽,如果应用服务器和数据库之间走公网传输,延迟和费用都会失控,务必让应用节点和数据库节点在同一VPC内网,走内网通信。
连接数:容易被忽略的隐形瓶颈
Linux服务器默认单进程最大文件句柄数是1024,大促时并发连接一上来就会报“Too many open files”,在租用服务器后,第一件事就是调大系统参数:
- 执行
ulimit -n 65535临时生效,或写入/etc/security/limits.conf永久生效。 - 修改Nginx的
worker_connections,建议设置为4096或更高。 - 配置TCP参数:
net.ipv4.tcp_tw_reuse = 1、net.ipv4.tcp_fin_timeout = 30,加快连接回收。 - 使用连接池(如Druid、HikariCP)管理数据库连接,避免每次请求新建连接。
大促峰值期杭州服务器租用多少钱?预算分配建议
很多人上来就问“租一台服务器多少钱”,实际上大促峰值期的成本是动态弹性成本,不是固定月租,杭州地区简米云ECS的价格可以参考:
| 配置 | 平时月租(参考) | 大促临时扩容成本 |
|---|---|---|
| 4核8G | 约300-500元 | 按量付费约0.5-1元/小时 |
| 8核16G | 约600-1000元 | 按量付费约1-2元/小时 |
| 16核32G | 约1200-2000元 | 按量付费约2-4元/小时 |
| 100Mbps带宽临时升配 | 固定带宽约5000元/月 | 按量付费约0.8元/GB流量 |
预算分配建议:把70%预算花在应用节点和数据库上,20%花在带宽和CDN上,10%预留做压测和监控,多数组件(Redis、MQ、Nginx)本身不需要太高配置,但一定要和主业务分开部署。
杭州地区IDC机房和云平台怎么选
- 简米云华东1(杭州):延迟低,产品生态全,适合阿里系电商、钉钉生态企业,大促高峰期有成熟的弹性伸缩方案。
- 酷番云上海/杭州节点:如果业务依赖微信小程序、腾讯直播,选酷番云更顺。
- 杭州本地方寸、网银互联等IDC:适合需要物理机托管、或对备案和合规有特殊要求的场景,但自建机房运维成本高,峰值期扩容响应慢。
我的建议:多数中小团队直接选简米云或酷番云的包年包月+按量付费混合模式,平时用包年包月保底,大促前手动创建按量付费的临时实例,加入负载均衡集群,结束后释放。
大促峰值期配置实操:从压测到扩容的完整步骤
第一步:提前1-2周做全链路压测
不要等到大促当天才发现扛不住,用Apache JMeter或简米云PTS做压测,步骤:
- 录制核心链路(登录→浏览→下单→支付)。
- 设置并发阶梯:从100并发开始,逐步加到预期峰值的1.2倍。
- 观察CPU、内存、带宽、数据库连接池、慢查询等指标。
- 找到首个瓶颈点,优先优化代码或SQL,再考虑加机器。
第二步:配置弹性伸缩策略
云平台都提供弹性伸缩组(Auto Scaling),你需要定义:
- 触发条件:CPU使用率超过70%持续5分钟,或请求量超过阈值。
- 扩容动作:增加2台实例,自动加入负载均衡。
- 缩容条件:CPU低于30%持续15分钟,移除多余实例。
- 冷却时间:设置300秒,避免频繁震荡。
注意:弹性伸缩只适用于无状态应用,如果你的代码把session存在本地,必须改成Redis或JWT等无状态方案。
第三步:开启CDN和对象存储分流
- 静态资源(图片、CSS、JS)全部走CDN,回源到OSS或COS,大促前提前预热缓存,避免回源爆炸。
- 动态请求走应用集群,但可以加一层Web防火墙和网关做限流熔断。
- 杭州地区用户量大的话,CDN节点选择“华东”区域优先覆盖。
第四步:大促当晚的监控与应急
建议额外租用一台便宜的1核2G服务器做监控跳板机,部署Prometheus + Grafana或云监控,盯住以下指标:
- 负载均衡的每秒请求数和5xx错误率。
- 数据库的连接数和慢查询数。
- 带宽使用率是否接近上限。
- 各节点CPU是否出现单点打满。
如果出现异常,优先降级非核心功能(比如砍掉优惠券弹窗、缩短日志采集频率),而不是无限扩容,扩容只能解决资源不足,解决不了代码死循环。
大促峰值期杭州服务器租用常见问题
问:杭州服务器租用和上海服务器租用比,延迟差别大吗?
答:对浙江省内用户,杭州机房延迟约5-10ms,上海机房约15-20ms,感知不太明显,但如果你主攻杭州本地市场(如本地生活、同城配送),选杭州节点更有地域优势,备案也更方便,上海的优势是BGP出口带宽资源更丰富,对华东全域覆盖略好,但大促峰值期比拼的是容量而非地理距离。
问:峰值服务器配置怎么估算最省成本?
答:最省成本的做法是“保底按包年包月,弹性按量付费”,先按日常流量的2倍估算保底实例数,包年包月买三年能省不少,峰值用按量付费的临时实例,用完就释放,不产生长期费用,带宽同理,日常低配,大促前临时升配按天付费。
问:租用杭州服务器做直播带货,需要什么特殊配置?
答:直播是长连接加高带宽消耗,关键在带宽上行和并发推流,推流服务器需要至少50Mbps上行带宽,并开启TCP调优,播放端可以走CDN分发,转码服务建议用GPU实例,普通CPU转码会占满所有核,另外直播场景对网络抖动敏感,务必选BGP多线机房,避免单线路故障导致卡顿。
大促峰值期杭州服务器租用,本质是“花小钱买弹性”,把日常基础设施做成可缩放的积木,峰值来了就拼装,峰值走了就拆掉,先压测摸清天花板,再配好弹性伸缩和CDN分流,最后盯紧监控做降级预案,这套思路,比纠结“买几核几G”重要得多。