成都GPU租用里,裸金属和虚拟化算力的核心区别,在于“整机独占”和“物理资源分时共享”,裸金属把一整台GPU服务器整租给你,GPU、显存、网卡、NVLink全部独享;虚拟化则是把同一台物理机的算力切分成多份,按需分配给你。
成都本地算力资源这几年发展很快,智算中心、商业云厂商、IDC服务商都提供GPU算力出租,但很多人在咨询时,第一句问的就是“成都GPU租用多少钱”,却忽略了两种交付形态的本质差异,搞清楚裸金属和虚拟化,才能真正选对资源,避免钱花了、训练任务却反复跑挂。
想做AI大模型训练,成都GPU裸金属和虚拟化区别有多大?
AI训练任务,尤其是大模型预训练和微调,对算力稳定性、数据隔离、多卡通信的要求极高,裸金属和虚拟化在这三个维度上的表现差异很明显。
裸金属:像租了一整套独栋机房
裸金属交付给你的,是一台完整的物理服务器,你可以直接看到GPU型号,独占全部显存和算力,系统盘、数据盘、网卡带宽都属于这台机器,它的行为和你自己采购一台GPU服务器放机房里,几乎没有区别。
- 性能稳定:没有虚拟化调度层,GPU算力不打折,长时间跑训练任务,性能曲线平稳。
- 数据边界清晰:磁盘、内存、显存的整个物理链路都归你独占,敏感数据不与其他租户共存。
- 多卡通信顺畅:单机8卡场景下,卡间走NVLink,多机互联走独立的高带宽网络,没有虚拟交换机转发的额外延迟。
行业共识认为,凡是涉及大模型预训练、医学影像分析、金融风控模型调优这类长周期、高敏感受的任务,裸金属是更稳妥的选择。
虚拟化:平台把一张GPU拆成多份“逻辑算力”
虚拟化在交付形态上分三类,差异也挺大:
- GPU直通:一张物理GPU整体映射给一台虚拟机,性能接近裸金属,但仍然共享宿主机的CPU和网络资源。
- vGPU切分:一张A100或H系列显卡按显存和算力份额切成多块,分给多个租户,价格便宜,但算力损耗明显。
- 容器共享调度:基于MIG或时间片方式共享物理卡,轻量灵活,但邻居任务高负载时,你的任务会被拖慢。
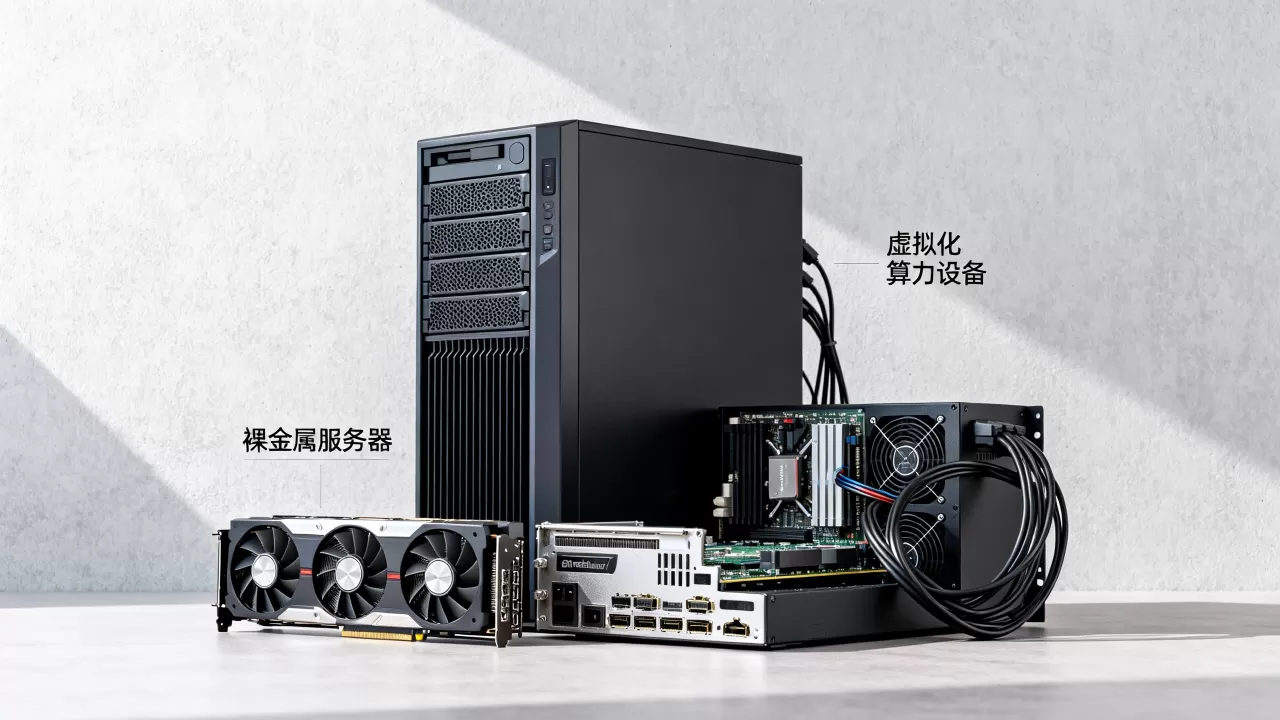
虚拟化的最大优势是弹性,控制台里几分钟就能创建一台带GPU的实例,按小时计费,用完就释放,适合做代码调试、小批量推理、短期竞赛、临时的数据预处理,以及需要频繁销毁重建的环境。
隔了虚拟化层,算力损耗和数据隔离都要看细节
如果你打算用虚拟化跑正式训练,有两点要提前有心理准备:
- 算力损耗不是固定值,取决于平台是否超卖。业内专家指出,高峰期虚拟化节点的任务吞吐量可能比裸金属低10%到30%,这个波动范围在训练场景里很难接受。
- 删除虚拟化实例时,数据残留在宿主机的可能性高于裸金属,涉及商业机密或用户隐私数据,尽量别用共享型虚拟化。
成都GPU租用价格并非唯一考量,交付速度和运维边界差异更值得对比
看价格是很自然的想法,但只盯价格容易踩坑,裸金属和虚拟化的计费模型、交付时间、运维责任完全不同,放在一起比单价没有意义。
价格结构完全不同
| 对比维度 | 裸金属 | 虚拟化 |
|---|---|---|
| 计费模式 | 按月/年起租,整机打包 | 按小时或按分钟计费 |
| 单价感觉 | 一次性支出高,长期摊薄成本低 | 单次小额,长期累计费用高 |
| 交付周期 | 通常需要数小时至1天 | 分钟级自动交付 |
| 网络配置 | 独享公网带宽和内网带宽 | 共享物理网卡,带宽有上限 |
| 运维边界 | 操作系统以上都由你负责 | 镜像或容器层以上由你负责 |
| 适用周期 | 30天以上的持续负载 | 几小时到几天的临时负载 |
多数情况下,裸金属的月租价格看起来比虚拟化贵,但这个价格里包含的是整机算力,不含“邻居干扰”这个概念,虚拟化按小时单价低,但如果一天24小时连续跑,一个月下来总花费大概率超过同等配置的裸金属。
成都GPU服务器租用,你的运维责任止于哪一层?
这是很多人忽略的点,裸金属交付后,驱动、CUDA、深度学习框架、代码环境,全都要自己装,服务商一般只负责硬件和基础网络层面的维护,系统崩溃重装可能要额外收费。

虚拟化则轻松很多,主流平台会提供预装PyTorch、TensorFlow、CUDA的镜像,创建实例时选一个即可,环境坏了直接换镜像,不用自己折腾驱动依赖。
选择逻辑很直白:
- 团队有运维能力和Linux基础,买裸金属,把省下来的钱用在算力上调优。
- 团队以算法为主、不想碰运维,用虚拟化镜像,快速出结果。
只有短期需求或测试场景,虚拟化是低成本验证路径
如果你还在验证技术路线、跑小批数据看效果,直接租裸金属容易产生闲置成本,先用虚拟化跑通流程,确认模型收敛效果后,再决定是否切换为裸金属长期租赁,这种组合路径目前在成都本地团队中比较常见。
成都GPU租用实操:验证交付和避开常见的坑
无论选哪种形态,拿到资源后都要做一套基础验收流程,避免“钱花到位了,东西不对”的情况。
成都GPU服务器租用,裸金属验收怎么做
收到裸金属服务器后,按以下步骤快速核验:
- SSH登录服务器,执行
nvidia-smi查看GPU型号、显存、驱动版本,确认与下单配置一致。 - 用
lscpu核对CPU核心数和主频,用free -h检查内存总量。 - 执行
nvidia-smi topo -m,查看多卡之间的通信拓扑,确认NVLink是否正常连接。 - 用
ethtool <网卡名>检查网卡协商速率是否为预期的万兆或更高。 - 跑一轮磁盘性能测试,例如
fio --name=test --rw=write --bs=128k --size=2G,观察延迟和带宽是否在合理范围。
每一步都要留截图或日志记录,硬件资源货不对板,及时发现还有协商余地。
虚拟化资源创建与规格选择
创建GPU虚拟化实例时,路径一般是:
- 在控制台选择区域为成都,选择邻近可用区。
- 选择GPU规格,查看显存大小、vGPU切分份额和计费方式。
- 选择基础镜像时优先选带CUDA和PyTorch的官方镜像,省去编译环节。
- 安全组规则放行22端口(SSH)以及Jupyter等业务端口。
- 创建后用
nvidia-smi检查虚拟GPU型号和显存大小,确认没有被平台切分得过小。
还有一个常见风险:平台超卖,同一张物理卡分给多个用户后,高峰期邻居任务会抢占算力,连续跑几次相同规模的计算任务,对比耗时波动,如果每次差异很大,说明该平台的共享隔离做得一般,考虑换裸金属或者换一家服务商。
成都GPU租用场景选型:训练、渲染、推理怎么挑
不同业务负载对算力的需求逻辑不同,没必要一套方案打天下。
大模型训练:裸金属为底座
训练任务的特点是长稳、高吞吐、多卡并行,虚拟化环境下NVLink不可用或性能打折,数据并行时的梯度同步效率会明显下降,再加上算力竞争的不确定性,训练到一半发现速度变慢,非常折磨人,长期跑训练任务,直接选裸金属,配置越高越好,省下的时间和调优成本远超硬件差价。
云渲染:虚拟化更划算
设计渲染和效果图制作的特点是任务并行度高、周期短、峰值明显,一台裸金属的算力跑满后就是上限,而虚拟化可以在渲染高峰期快速拉起几十个渲染节点,渲染完成立即释放,按张数计费的场景下,虚拟化的成本可控性更优,成都本地有大量设计公司和影视制作工作室,多数选择“错峰混合”策略,日常用裸金属,赶工期时扩容虚拟化节点。
推理服务:看并发和延迟承受力
线上推理服务需要7x24小时稳定响应,对延迟敏感,小型模型用虚拟化加上弹性伸缩,成本确实低;但如果并发量高、响应要求在毫秒级,虚拟化的调度开销和网络共享可能拖后腿,有条件的团队,推理服务建议用裸金属搭配负载均衡,或者至少用GPU直通型虚拟化。
成都GPU裸金属和虚拟化的常见选型疑问
预算有限时,成都GPU租用怎么选?
先用虚拟化完成开发调试和可行性验证,确认模型效果和训练稳定性后,再切换为裸金属做正式训练,这是目前较多成都本地创业团队采用的路径,既能控制前期投入,又能保证正式任务跑在可靠资源上。
成都GPU租用价格差异体现在哪里?
价格差异主要体现在计费模式和资源独占程度,虚拟化按小时计费,适合短期、弹性、碎片化的使用方式;裸金属按月整租,一次性支出高,但长期稳定性更好,连续满载运行的场景下,裸金属的性价比更高,同时避免了共享资源带来的性能波动。