南京高校科研团队租用服务器部署计算集群,先按计算任务定节点和调度方案,再选租用模式,最后落地上机。 别一上来就刷采购单,先把你手里那批实验跑一遍,搞清楚吃CPU还是GPU、并行效率多少、数据放哪,再决定怎么租,才是省钱的正确姿势。
南京高校科研团队租服务器部署计算集群,先想清楚这四件事
算清楚你的计算任务吃CPU还是GPU
实验室的活儿不一样,租的机器就得跟着变,做分子动力学、有限元仿真的,大多吃CPU高频和内存带宽;跑深度学习训练、推理的,就得靠GPU撑场面,这里有个小技巧:先看团队里现有代码的瓶颈在哪,用nvidia-smi跑一跑你的模型,如果GPU利用率一直上不去,多半是CPU喂不饱,换再多GPU也白搭。
场景对照
- 传统数值计算:需要高主频CPU,核心数多,内存要大,网络反而要求不高。
- 深度学习训练:GPU显存和算力优先,大批量多卡训练还得考虑NVLink或RoCE网络。
- 大数据处理或并行仿真:吃内存带宽和存储吞吐,SSD NVMe阵列比CPU数量更关键。
节点规模不用一步到位,按并行度来
很多团队上来就要租一百个节点,实际上调度器一挂,排队跑不满,浪费钱,建议先按"单任务最大并行度"来估算:你实验室里最大的那个作业需要开多少核、多少卡?集群规模取这个数的1.5到2倍就行,后续任务多了,再加节点也来得及。
还有个小问题:租服务器时,公网IP和防火墙都要留好,南京高校校园网环境下,很多机房的IP段会有白名单限制,你得提前把实验室的外网IP报给机房运维,不然节点间互访卡一半,还以为机器坏了。
存储和网络容易被忽略,但最影响实际体验
计算集群不是一堆机器拼在一起就完事了,共享存储是灵魂,哪怕你只有四个节点,也建议上一套NFS或Lustre,把 /home 和 /data 挂到所有节点上,这样提交作业时不用挨个机子传代码,网络方面,管理网和数据网最好分开,数据网用万兆以上,不然多节点并行时网络变成瓶颈。
计算集群服务器租用价格怎么算?南京高校怎么选机房
云上按量租和物理机托管,价格差在哪
这是个老生常谈但必须聊的话题,云服务器按小时计费,灵活,跑完就释放,适合短期调参或课程演示,物理机托管按年签约,一次性付个托管费,适合长期跑实验的固定团队,业内专家指出,南京本地高校的课题组通常混用两种方式:平时用云上竞价实例跑短任务,长周期的大作业放到物理机托管。
表格对比
| 对比项 | 云上租用(按量) | 物理机托管(年租) |
|---|---|---|
| 计费模式 | 按小时/按秒 | 按年或按季 |
| 网络带宽 | 按需付费,贵 | 包含在托管费里 |
| GPU卡型 | 随时换新卡 | 固定配置,升级麻烦 |
| 适合场景 | 短期调试、临时扩算力 | 稳定跑半年以上的项目 |
| 南京本地延迟 | 取决于购买区域 | 机房在本地,延迟极低 |
南京本地的机房和高校布点,怎么选不折腾
南京高校科研团队租用服务器时,多数会优先考虑江宁、江北新区、仙林大学城附近的IDC机房,原因很简单:离学校近,出了问题能骑着电动车过去看看,省去线上沟通的扯皮时间,江苏地区高校多,有些机房专门做教育网接入,能拿到教育网IPv6地址,访问国际学术数据库的速度会好很多。
选择机房时,重点问三件事:能不能在晚上九点之后接到人工运维电话、带宽有没有按月上限、退款规则怎么算,很多便宜机房在这三条上含糊其辞,等你开机跑数据了才发现网络拥堵,就晚了。
预算有限时,混搭租用也能跑出好效果
不一定非要整套集群都租同一种规格,可以把登录节点搞便宜点,计算节点用好卡,存储节点租个带软RAID的大容量机器,调度器只认资源,不认品牌,混搭完全可行,实际操作中,南京不少课题组是"学校超算账号+云上GPU租用"两手抓,急活跑云端,日常小任务校内解决。
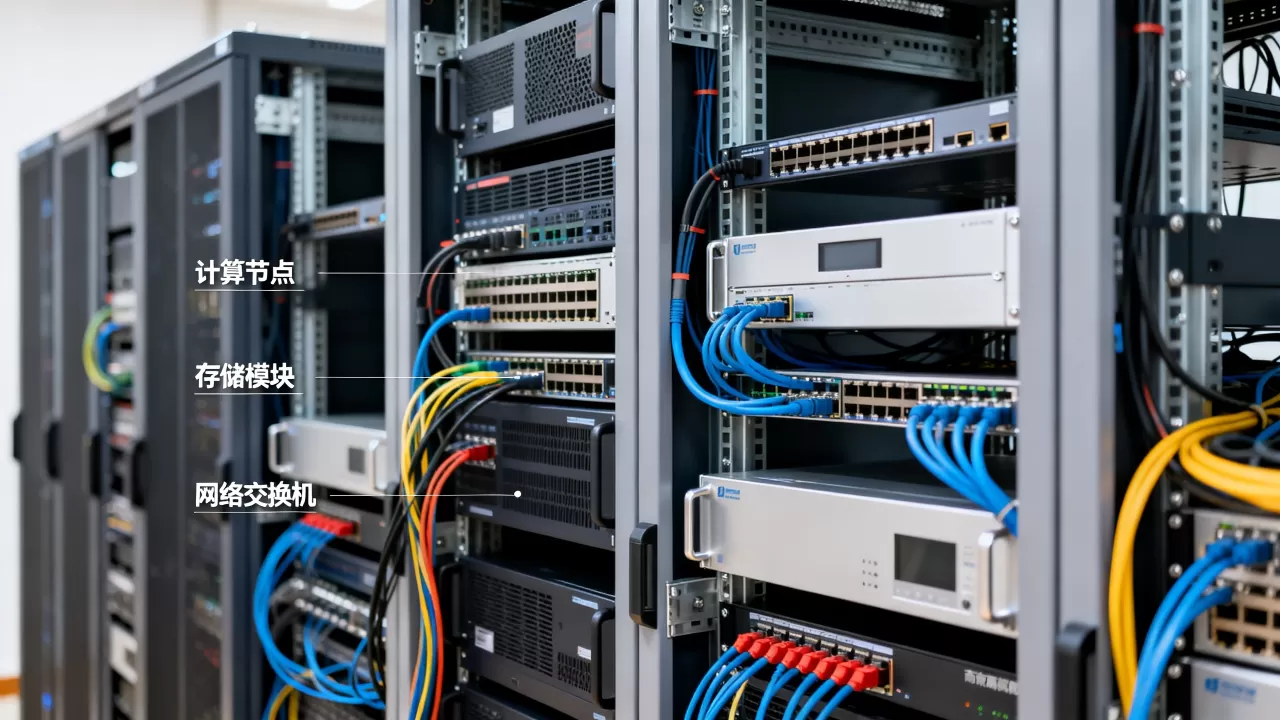
高校科研团队GPU服务器租用,部署计算集群的实操步骤
系统初始化和基础环境安装
租到机器后,第一步不是装软件,而是确认系统镜像,推荐直接用Ubuntu Server 22.04 LTS或Rocky Linux 9,这两个系统对深度学习框架和Slurm调度器的兼容性都稳,装完系统后,统一更新内核和驱动:
sudo apt update && sudo apt upgrade
sudo apt install build-essential gcc g++ gfortran装NVIDIA驱动时,别用默认的ubuntu-drivers auto,去NVIDIA官网查对应CUDA版本的驱动型号,装完用nvidia-smi验证,确保每个节点驱动版本一致,不然后面MPI通信会莫名报错。
装好调度器,把节点管起来
集群调度器选Slurm没错,它现在是高校实验室的事实标准,单机部署方式很简单:控制节点跑slurmctld,计算节点跑slurmd,先把/etc/hosts写清楚:
168.1.10 master
192.168.1.11 node01
192.168.1.12 node02然后安装Slurm包,改slurm.conf,定义NodeName和PartitionName,这里有个容易踩坑的点:StateSaveLocation目录权限不够会导致控制节点起不来,建议统一用/var/spool/slurmctld并给slurm用户所有权限,行业共识认为,调度器配置环节是部署过程中最耗时的部分,耐心点,一次配好后面半年省心。
共享存储和账号权限,一次配好省得后面烦
用NFS把存储节点上的/home和/data导出,所有计算节点挂载同一份,编辑/etc/exports:
/data 192.168.1.0/24(rw,sync,no_root_squash,no_subtree_check)然后在客户端mount -a,注意,每个节点上新建的系统用户UID和GID要一致,不然NFS共享目录会出现权限错乱,建议直接在服务端用LDAP或简单的rsync脚本同步/etc/passwd。
部署完怎么验证集群真的跑得顺
用一个小型高并行任务做压测
跑一个MPI版本的linpack,或者直接用mpirun -np 8 hostname,看每个节点是否都能正常响应,再提交一个sleep任务到Slurm,检查任务分布在哪个节点上,重点观察节点间的网络延迟,用
ping测一下,万兆网络内延迟应该在0.2毫秒以内,超过0.5毫秒就要检查网卡和交换机配置。
监控和日志,让你半夜不用起来修机器
计算集群出故障往往是半夜跑训练时,建议部署一个简单的Prometheus+Grafana监控,重点看GPU温度、显存占用、NFS吞吐量,再配个slurmctld日志轮转,日志别丢根目录,不然撑满磁盘后集群直接全体罢工。
日常运维还需要关注电费预算,南京夏天机房空调开得足,如果托管的是高功率双路GPU机器,单台功耗800瓦起步,一个月电费就好几百,这个成本算在服务器租用价格里,别只看硬件标价。
Q&A:南京高校科研团队租用服务器部署计算集群,常见问题解决
Q:租用服务器时,怎么判断机房能不能满足集群的并行计算需求?
A:先看机房的网络架构,问清楚交换机是不是万兆起步,最好支持RDMA或RoCE,再看是否提供独立的IPMI/带外管理,方便你远程重启死机节点,最后问带宽是BGP多线还是单线电信,南京高校访问教育网资源时,单线机房有时候要做特殊路由,绕路会拉高延迟。
Q:计算集群服务器租用价格控制在多少比较合理?
A:没有标准价,但可以按节点算,一台双路CPU、512GB内存的胖节点月租在800到1500元之间,带四卡A100的GPU节点月租就可能破万,南京本地的物理机托管比较划算,因为它省去了云平台的虚拟化损耗,算力能跑满,建议用"租期超过一年就谈折扣"的策略,很多IDC为了回本愿意给8折以下的价格。
Q:面向高校科研团队的GPU服务器租用,要不要选带调度服务的平台?
A:如果团队里没人研究过Slurm,可以选带容器调度平台的服务商,比如直接用Kubernetes加GPU插件,不过要注意,K8s更擅长处理无状态任务,传统MPI并行程序在K8s里跑要额外配kubectl和mpi-operator,运维门槛反而更高,还是那句话,先看你的代码能不能跑进容器,再决定要不要用平台。