GPU服务器租用费用主要看三个决定因素:显卡型号与数量、带宽与计费模式、服务商溢价,其中显卡成本通常占总费用的60%以上。
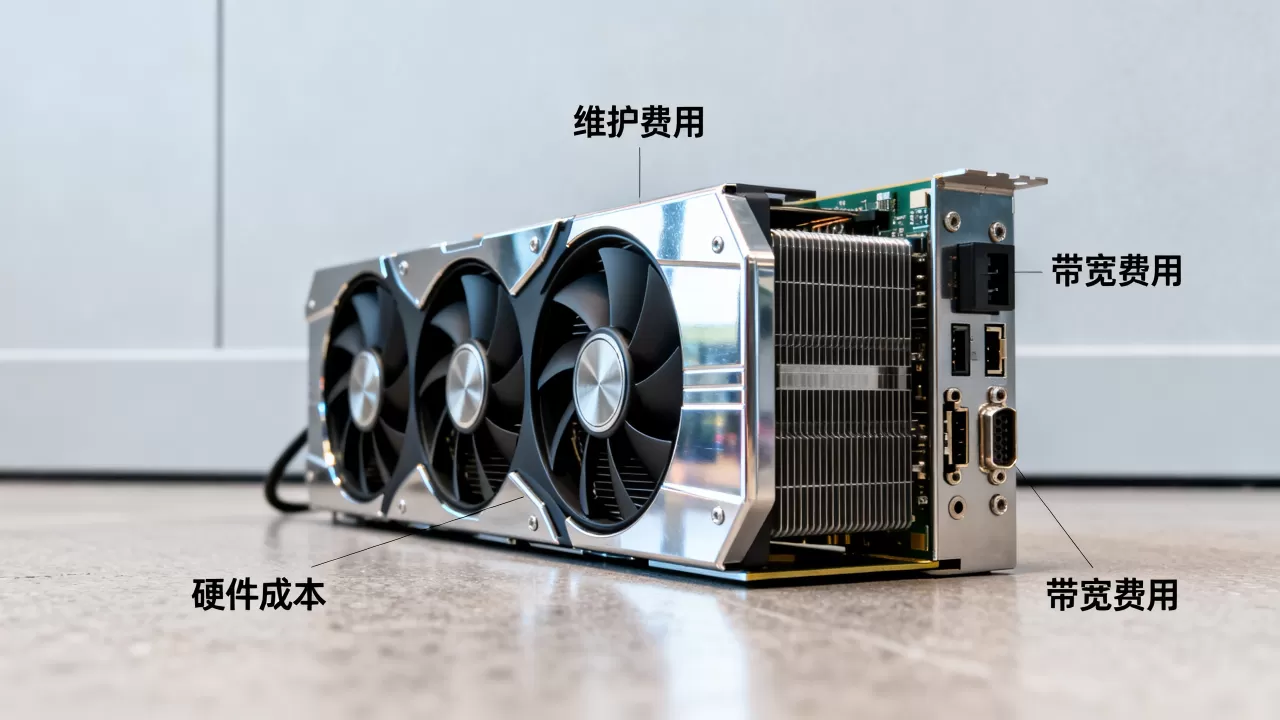
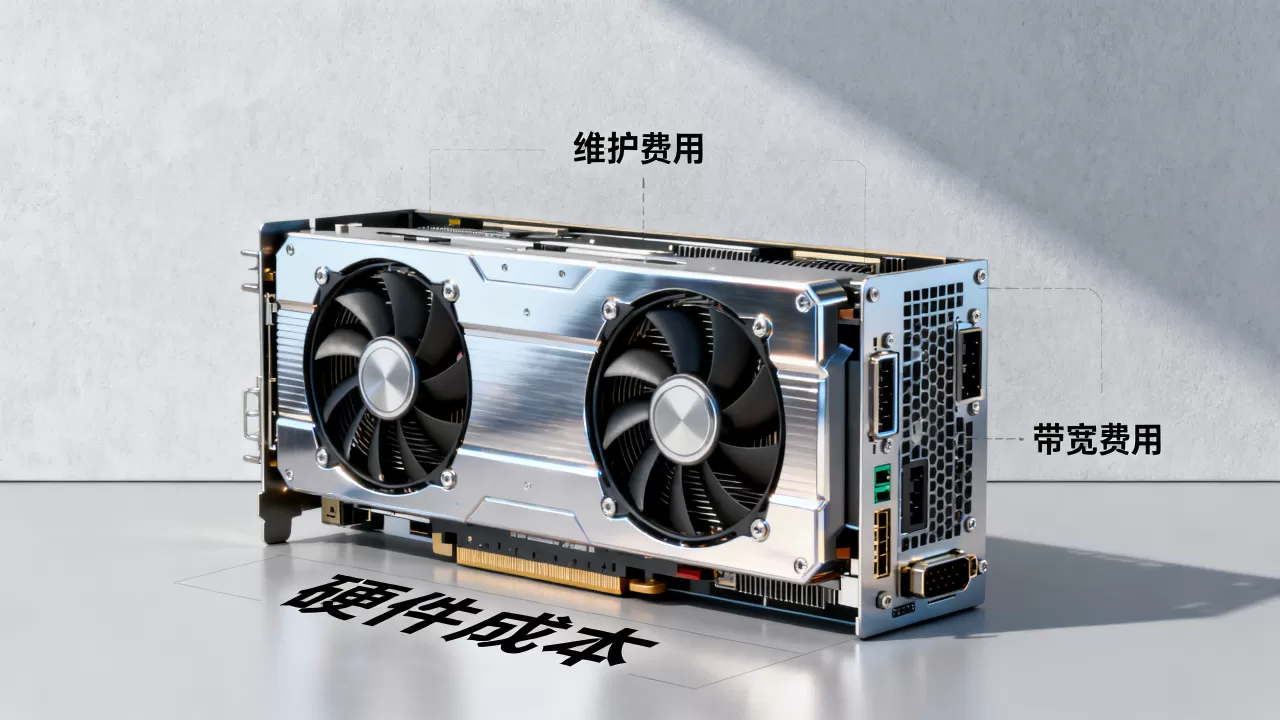
GPU服务器租用价格表显示的三大费用构成
打开任何一家服务商的报价页面,你会看到月付、年付、按量计费的标签,价格从几百到几万不等,作为常年跟GPU服务器打交道的人,我把它拆成三部分:硬件成本、带宽成本、服务商运营成本。
GPU硬件本身的成本占大头
这是费用的主体,一块RTX 4090的采购成本在5万元左右,A100更是高达6万到10万元,H100单价一度被炒到30万元以上,服务商把这几块卡插进一台服务器,按三年折旧算月成本,再加上机房托管费、电费、维护人工,就形成了你的月租金。
具体到配置上:
- 显卡型号:RTX 4090、A10、A100、H100、L20S等,价格从几十元/小时到上百元/小时不等
- 显存大小:24G、48G、80G直接决定了能不能跑大模型微调
- CPU与内存:大部分场景下够用就行,但CPU核心数影响数据预处理速度
- NVLink互联:多卡训练场景需要,有NVLink的机型比同配置无互联的贵20%-30%
GPU服务器租用价格表中,最容易被忽视的是显存带宽,同样是A100,80G版本比40G版本贵不少,训练吞吐量差距却很明显。
带宽计费方式的不同思路
带宽也是费钱的大头,国内机房普遍采用按固定带宽包月或按流量计费两种模式。
固定带宽适合稳定业务:10M独享带宽月费大约几百到一千元,适合大多数AI训练场景,因为训练期间主要是数据上传和结果下载,不持续占用带宽,按流量计费则适合模型推理服务,尤其是面向C端用户的产品,流量峰值不可控,用多少算多少。
如果你问GPU服务器租用哪家性价比高,带宽的坑往往在报价之外,有些服务商标价很低,但带宽只有1M或2M,上传一个几个GB的模型要等半小时,行业共识认为,
至少选择10M以上带宽才能保证AI训练的正常体验。
服务商的溢价从哪来
同样的配置,不同服务商价格可能悬殊30%-50%,这中间的差价不是纯利润,而是服务等级差异:
- 技术支持响应时长:7×24小时人工支持还是工单机器人回复
- 故障恢复时间:承诺30分钟还是24小时
- 网络品质:BGP多线接入还是单线,晚高峰是否丢包
- 数据可靠性:是否有分布式存储,是否做每日快照备份
这些隐性成本会体现在租用价格里,也会体现在你跑训练时的稳定性上。
深度学习GPU服务器租用哪家好对比供应商定价策略
深度学习GPU服务器租用哪家好这个问题没有标准答案,但搞清楚供应商的定价策略,你就能少花冤枉钱。
包年包月与按量计费有什么不同
两者的核心差异在于是否绑定资源。
| 计费方式 | 适用场景 | 优势 | 风险 |
|---|---|---|---|
| 包年包月 | 长期训练、持续推理服务 | 单价低,资源稳定 | 闲置时浪费费用 |
| 按量计费 | 实验验证、短期任务 | 用完即停,灵活 | 高峰期可能无货 |
| 竞价实例 | 可中断任务、数据预处理 | 价格极低(约1-2折) | 随时可能被回收 |
实际使用经验是:如果每天的GPU使用时间超过4小时,包月比自己按量控制成本更低,大模型训练通常要持续数周,按月购买是主流选择,但如果你只是调参测试,按小时租一台足够了。
大模型训练租用GPU服务器有什么不同
很多人第一次接触租GPU是为了跑大模型微调,这里有个误区:误以为卡越多越好。
超过32张卡的分布式训练对你的用处可能不大,除非你有专业的并行优化能力,多数情况下,单机8卡或4卡
已经能满足大部分微调和推理需求。
另外要看服务商是否提供镜像市场,有些服务商预装了PyTorch、CUDA、Python环境,开箱即用,省去半天环境配置时间,这条时间成本折算成费用,在按量计费模式下也是相当一部分开支。
上海GPU服务器租用费用在区域上的差异
上海GPU服务器租用费用在国内属于第一梯队,原因是上海机房成本高、电力资源紧张、需求旺盛,同配置下,上海机房通常比中西部城市贵10%-20%。
国内机房与海外机房的差异
如果你的业务不需要国内备案,可以关注东京、新加坡、法兰克福等海外机房,海外机房有些定价比上海便宜,但网络延迟是个问题。国内用户访问海外机房通常延迟在100-200ms,训练任务不受影响,但实时推理体验明显下降。
反过来,如果你的业务面向海外用户,用海外机房反而更好,这个要根据业务目标用户来选。
BGP多线与单线怎么选
国内租用GPU服务器时,网络路径分为BGP多线、电信单线、联通单线、移动单线。
BGP多线通常比单线贵100-200元/月,但能确保不同运营商用户都能快速访问,如果是部署对外服务的推理API,BGP多线基本是必需品,如果只是自己SSH上去训练,单线无所谓,选最便宜的就行。
不可忽视的隐性费用与成本控制实操
除了租金、带宽、电费,还有一些费用容易在你首次租用时被绕进去。
数据存储与迁移成本
- 系统盘容量:默认往往只有40G-80G,装完CUDA和模型框架就满了
- 数据盘价格:高性能SSD每GB每月5-1元,1TB数据一年就是6000-12000元
- 公网下行流量:从服务器下载数据到本地是免费的,但上传数据到服务器可能按流量收费
- 快照备份:部分服务商提供每日快照,但超出配额会额外计费
数据迁移也有讲究,如果数据量在几百GB级别,走公网上传一晚上能搞定,但数据量到TB级别,
用顺丰寄硬盘给服务商线下拷贝效率更高,也能省流量费,内网拷贝速度通常可以达到800MB/s到1GB/s。
实际控制成本的步骤
- 先估算任务需要的显存总量,再反推显卡型号和数量,不盲目上A100
- 对比包月、包年、按量三种计费方式,结合任务时间周期做选择
- 同样型号的配置,把带宽费、存储费、快照费加总后再比较总价
- 确认是否支持无理由退款和实例升降配,防止选错配置后的沉没成本
- 先租一台小配置机器跑通流程,确认无误后再扩大规模
GPU服务器租用费用常见问题解答
GPU服务器租用价格表里标注的"月付"包含电费和机房费用吗?
包含,服务商报出的月租价格通常已经将硬件折旧、机房空间、电力消耗、基础维护算进去了,你额外需要支付的只有带宽超出部分、数据盘扩容和快照备份费用,签署合同前问清楚报价单里是否包含这些项目即可。
为什么同样的显卡,不同服务商价格差很多?
主要有三个原因:一是硬件新旧程度有些用矿卡翻新,有些用全新卡;二是网络线路质量BGP多线比单线贵,CN2线路更贵;三是服务响应等级包赔协议、故障响应时间都会影响定价,选择时优先确认硬件是否全新、带宽是否独享、合同里有无赔付条款。
大模型训练租用GPU服务器时,是否推荐用多机分布式?
多机分布式训练只有在单机显存彻底不够用时才推荐,多机通信依赖InfiniBand或RoCE网络,大部分云厂商的普通网络不支持高效多机训练,租用多机前先确认服务商是否提供高速互联且价格能接受,否则跨机训练的通信开销反而超过性能提升,纯粹的浪费预算。
GPU租用费用是扣出来的数字,不是标出来的数字,算清楚硬件、带宽、存储、服务四笔账,你才能找到匹配自己任务场景的性价比方案。别只看单价,算总价。