支付系统容灾方案没有万能解,核心结论一句话:交易核心链路优先同城双活,账务数据用两地三中心保证强一致,异地多活靠单元化分片,中小机构从温备加异地冷备起步更划算。
支付系统容灾方案有哪几种架构?先看清四类主流选择
支付系统容灾不是买几台服务器就完事,先分清架构,再谈选型,常见四类:主备、同城双活、两地三中心、异地多活,每类都有边界,别指望一套方案包打天下。
主备架构:冷备、温备、热备的边界
- 冷备:备机不运行,只有备份数据,恢复要装系统、导数据,RTO小时级,RPO分钟到小时,适合非核心报表、历史查询。
- 温备:备机运行,数据同步,但不接流量,切换要改路由,RTO分钟级,RPO秒到分钟,中小支付机构常用。
- 热备:主备实时同步,VIP漂移,RTO秒级,但备机常年闲置,成本不低,适合交易核心但预算充足。
实操检查MySQL主从:mysql -uroot -p -e "show slave statusG" | grep -E "Seconds_Behind_Master|Slave_IO_Running",切换用orchestrator-client -c failover -i mysql-master:3306,注意半同步设置:SET GLOBAL rpl_semi_sync_master_enabled=1;。
| 架构 | RTO | RPO | 成本 | 适用场景 |
|---|---|---|---|---|
| 冷备 | 小时级 | 分钟-小时 | 低 | 非核心系统 |
| 温备 | 分钟级 | 秒-分钟 | 中 | 中小支付 |
| 热备 | 秒级 | 秒级 | 高 | 核心交易 |
同城双活:不是两台机器都跑就叫双活
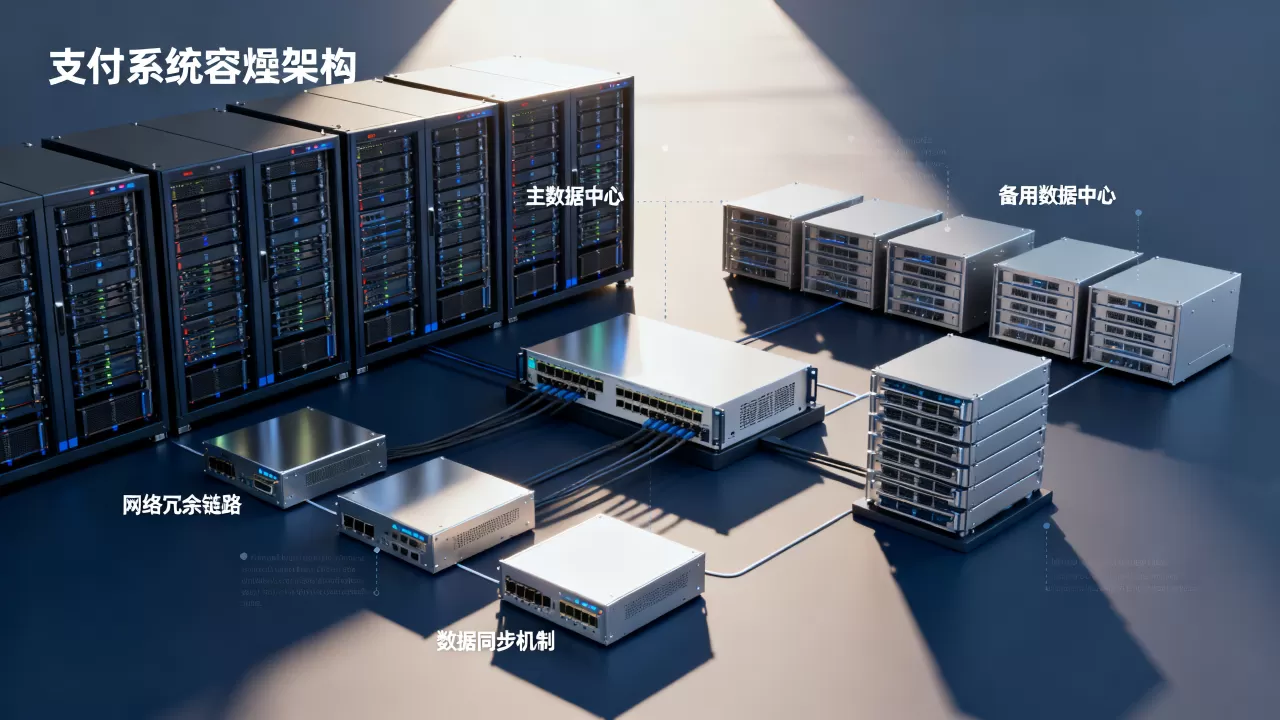
同城双活要满足三个条件:流量可切、数据可写、冲突可解,流量层用DNS/GSLB、LVS、Nginx,数据层用MySQL GTID、Paxos组复制或分布式数据库,写冲突用分片解决,比如用户ID取模。
配置GTID示例:CHANGE MASTER TO MASTER_AUTO_POSITION=1;,检查:mysql -e "show master statusG",应用层做双写或单元化写,避免同一笔订单在两个机房同时改。
同城双活和主备架构到底怎么选?看RTO、RPO、成本
业内专家指出,选型先定RTO和RPO,支付交易要求RTO秒级、RPO零丢失,同城双活更稳,内部管理系统RTO分钟级,主备够用。
同城双活的流量调度与数据同步
操作步骤:
- 接入层做健康检查,
nginx -s reload更新上游。 - 数据库半同步复制,
SET GLOBAL rpl_semi_sync_master_enabled=1;。 - 应用双写或单元化写,按用户ID路由。
- 定时演练,记录切换时间和数据差异。
主备架构的切换脚本与演练
- 写切换脚本:
ansible-playbook switch.yml -e "target=standby"。 - 每月检查备份:
xtrabackup --backup --target-dir=/backup/。 - 每季度模拟主库宕机,观察
Seconds_Behind_Master。 - 切换后对账:
python reconcile.py --date 2026-01-01。
成本对比:同城双活贵在哪
- 专线带宽:同城双活要求低延迟,专线费用不小。
- 资源冗余:两套环境同时跑,资源利用率可能不到一半。
- 一致性协调:分布式事务、时钟同步,增加研发和运维成本。
- 中小机构若预算有限,同城温备加异地冷备能覆盖多数故障。
金融云地域部署场景下,两地三中心和异地多活怎么落地?
行业共识认为,同城双活防机房断电,异地多活防城市级灾难,金融云地域部署时,要选多可用区,再考虑跨地域。
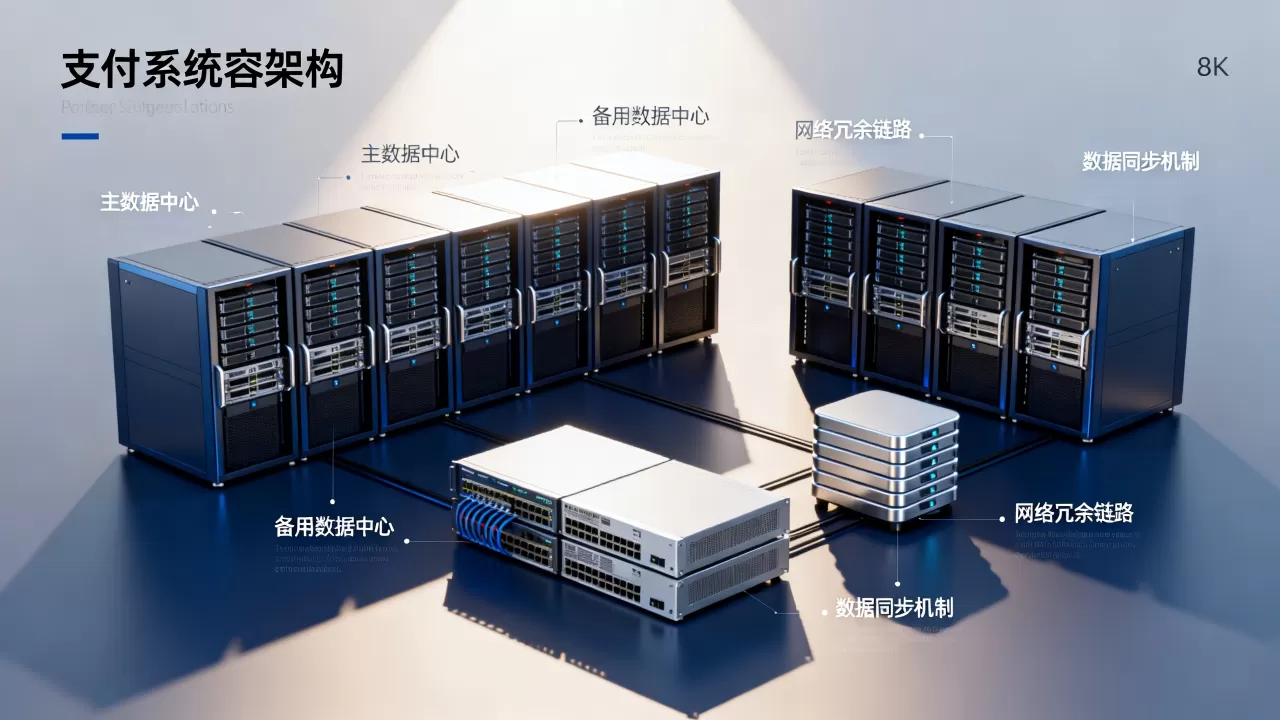
两地三中心:生产、同城灾备、异地灾备
- 生产中心:承载全部流量。
- 同城灾备:同步复制,数据零丢失,可接管。
- 异地灾备:异步复制,防城市灾难,RPO分钟级。
切换步骤:
- 确认故障范围,冻结交易。
- 提升异地库为主,通过云厂商控制台或
call mysql.rds_set_external_master...。 - 修改DNS和网关路由,
curl -X POST http://dns/api/switch -d '{"zone":"dr"}'。 - 跑对账,确认账务平衡。
异地多活:单元化架构是核心
单元化把用户分片,每个单元闭环,路由规则:unit_id = user_id % 16,网关根据用户ID转发。
实操:
- 配置单元化网关,
curl -H "X-Unit: 02" http://gateway/pay。 - 数据同步用binlog订阅,冲突用last-write-wins或业务规则。
- 灰度引流:先切1%用户,观察错误率和延迟。
云原生多可用区:K8s多集群加Service Mesh
- 节点池跨AZ,Pod反亲和:
topologySpreadConstraints。 - 存储用云盘跨AZ复制,数据库开多可用区。
- 流量用Istio多集群,故障注入:
blade create network delay --time 3000 --interface eth0 --local-port 3306。 - 监控用Prometheus加Alertmanager,告警规则写清楚。
中小支付机构容灾方案成本大概多少钱?分阶段投入更务实
中小机构别一上来就三地五中心,分阶段:先温备,再同城双活,最后异地多活,成本从每月几千到几万不等,看云厂商和带宽。
最小可行容灾:温备加异地冷备
- 同城温备:一台备机,数据同步,不接流量。
- 异地冷备:对象存储放备份,
aws s3 sync /backup s3://payment-backup。 - 预算:云主机加专线,每月几千元级别。
- 关键:备份可恢复,演练能切换。
演练与监控:花小钱防大事故
- 监控:Prometheus抓取MySQL指标,
mysql_up、slave_lag。 - 告警:Alertmanager配置钉钉或邮件。
- 演练:每季度一次,混沌工程工具ChaosBlade。
- 对账:每日跑批,差异自动挂起,人工处理。
支付系统容灾架构Q&A:常见疑问解答
同城双活能防机房断电吗?
能,同城双活的两个机房在不同可用区,一个断电,另一个接管,但同城双活防不了城市级灾难,比如地震、洪水,要防城市级,得加异地灾备或异地多活。
两地三中心和异地多活哪个更适合高频交易?
高频交易对延迟敏感,两地三中心同城同步复制延迟低,异地异步,异地多活若跨城写,延迟高,需要单元化让写闭环在本单元,多数高频支付核心用同城双活加异地多活做冷备或读扩展。
容灾切换后如何保证账务不丢不重?
靠三点:一是数据库半同步或强一致复制,确保RPO接近零;二是切换前冻结交易,记录断点;三是切换后跑对账,用流水号、订单号比对,对账脚本示例:python reconcile.py --date 2026-01-01 --diff-threshold 0.01,发现差异,按业务规则冲正或补单,据央行相关技术规范,支付系统灾备能力通常要求定期演练并留存记录。
支付系统容灾方案选型,本质是拿RTO、RPO和成本做平衡,同城双活保交易,两地三中心保账务,异地多活保城市级灾难,中小机构从温备起步,持续演练比堆架构更管用。