租用的物理服务器完全可以做故障切换,而且这是IDC高可用架构的标配能力,不是云主机专属。只不过实现方式比云主机要“手动”一些云主机点几下鼠标就能挂漂移IP,物理服务器得靠系统层面的技术自己搭,下面把方案、对比、实操步骤一次说清。
租用物理服务器怎么做故障切换?三种主流方案
物理服务器的故障切换,本质上就干一件事:把流量或服务从坏机器挪到好机器上,用户无感知或秒级感知,行业里最常用的有三条路子,按适用场景排序。
虚拟IP漂移(VIP漂移):最常见的主流方案
这个方案的核心工具是 Keepalived(Linux下的高可用软件),原理是给两台物理服务器绑定同一个虚拟IP,平时VIP绑定在“主服务器”上,主服务器每隔几秒通过VRRP协议(虚拟路由冗余协议)给备服务器发心跳信号,一旦主服务器宕机、网络中断或服务进程挂掉,备服务器收不到心跳,立刻抢过VIP,完成流量接管。
- 适用场景:数据库主从、Nginx反向代理、Redis缓存、企业官网
- 切换时间:多数情况下1-3秒,极少超过10秒
- 成本:只需要两台物理服务器+Keepalived软件(开源免费)
- 注意点:VIP漂移只解决“IP层面的切换”,服务本身(比如MySQL)还需要做主从同步,否则切过去也没数据
负载均衡集群:多个节点同时干活
如果业务流量较大,或者不想让一台服务器闲着当备胎,可以用负载均衡集群方案,前端用一台物理服务器装 LVS(Linux虚拟服务器)、HAProxy 或 Nginx 做分发器,后面挂2台以上物理服务器做真实工作节点,分发器做健康检查,哪台Web服务器没响应就直接摘掉,把请求转到健康节点。
- 适用场景:高并发网站、API接口服务、应用服务器集群
- 切换时间:毫秒级,用户完全无感知
- 成本:至少3台物理服务器起(1台分发+2台后端)
- 注意点:分发器本身是单点,建议分发器也做双机热备
共享存储+自动故障转移:数据库和服务器的硬核方案
对于核心数据库这种既要高可用又要数据不丢的场景,业内常用方案是 共享存储(如SAN存储阵列)+ 集群文件系统
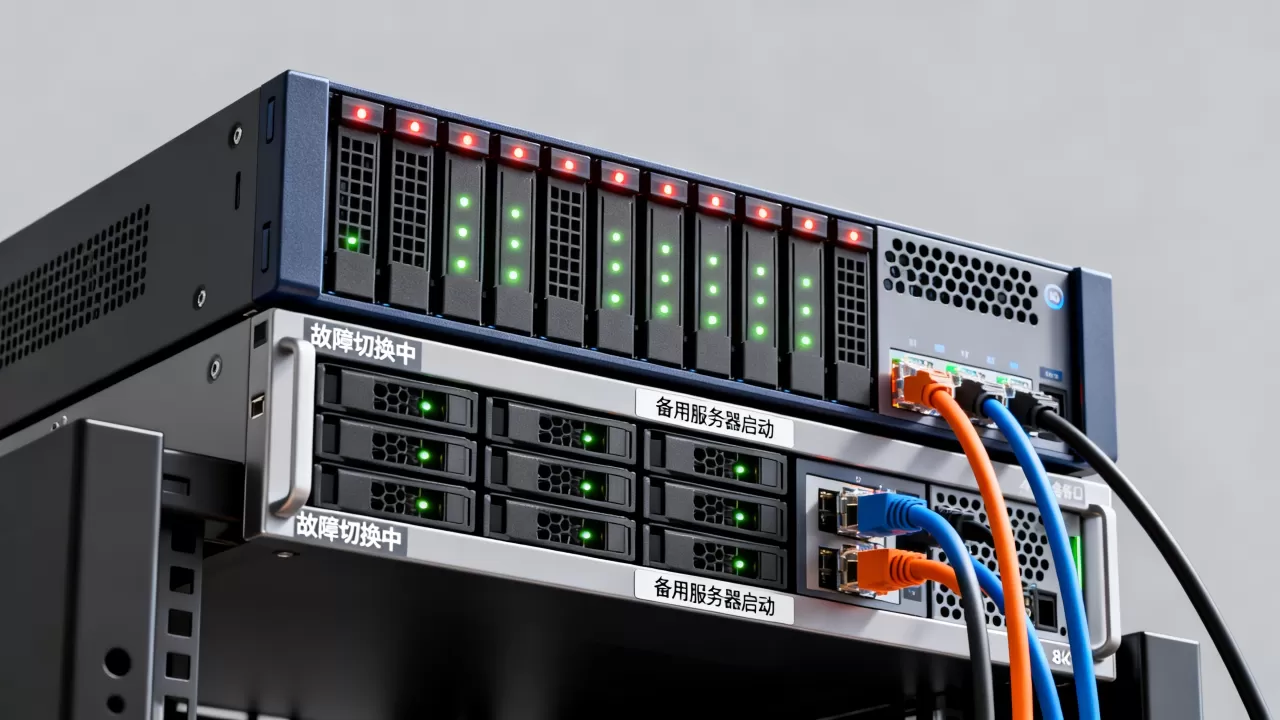
,两台物理服务器通过光纤通道或万兆网线连同一台存储设备,配合 Pacemaker 或 RHCS(红帽集群套件)做资源管理,当主服务器故障时,集群软件把存储挂载、服务进程、VIP地址整套切换到备机上。
- 适用场景:Oracle RAC、金融级核心交易系统
- 切换时间:多数会控制在30秒以内
- 成本:存储阵列价格不低,租用物理服务器时需和IDC确认是否支持挂载共享存储
- 注意点:这种方案对机柜空间和网络要求较高,租用前一定先问机房能不能拉专线
物理服务器和云主机做高可用有什么区别?
很多第一次接触物理服务器租用的朋友会纠结这个问题,两者在高可用层面,思路不同,结果也不同。
| 对比维度 | 租用的物理服务器 | 云主机(ECS) |
|---|---|---|
| 故障切换机制 | 自己装Keepalived/集群软件,手动配置 | 控制台一键迁移,后台自动化处理 |
| 切换速度 | 秒级(看配置复杂度) | 分钟级(虚拟机迁移需时间) |
| 数据一致性 | 自主控制,可做主从同步 | 依赖云厂商快照和云盘复制 |
| 故障责任归属 | 服务器硬件问题由IDC负责,服务层问题自己解决 | 平台整体负责,但受宿主机影响 |
| 成本控制 | 物理服务器租用价格通常比同配置云主机低30%-50% | 按量付费,弹性强但连续使用成本偏高 |
行业共识认为:物理服务器租用适合对性能、数据私密性、稳定延迟有硬性要求的业务;云主机适合弹性扩缩容需求频繁的互联网应用,两者在高可用上能做的事情基本一样,区别在于谁来做“脏活累活”租物理服务器,你得自己当架构师;用云主机,平台帮你兜底。
租用物理服务器做故障切换的实操步骤
光知道方案不够,下面是实际部署Keepalived双机热备的具体动作,假设你已租了两台物理服务器,操作系统是CentOS 7或Rocky Linux,内网IP分别是 168.1.10(主) 和 168.1.11(备) ,虚拟VIP设为 168.1.100。
第一步:两台机器都安装Keepalived
在SSH终端执行以下命令:
yum install -y keepalived
systemctl enable keepalived
第二步:配置主服务器的Keepalived
编辑主服务器的配置文件 /etc/keepalived/keepalived.conf:
! Configuration File for keepalived
global_defs {
   router_id LVS_MASTER
}
vrrp_instance VI_1 {
    state MASTER
    interface eth0
    virtual_router_id 51
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 123456
    }
    virtual_ipaddress {
        192.168.1.100
    }
}
第三步:配置备服务器的Keepalived
备服务器的配置和主服务器几乎一样,只改两处。state MASTER 改成 state BACKUP,priority 100 改成 priority 90,这样主服务器活着时VIP永远在主机器上。
第四步:顺便把业务服务做成自启动
Keepalived只负责IP漂移,如果MySQL或Nginx挂了你不知道,VIP一样不会动,所以要在主备机器上都把业务服务设为开机自启,并配合监控脚本,业界常用的做法是在Keepalived配置里加一个 vrrp_script 模块,定时检测服务端口,端口没响应就自动降权让VIP漂走。
vrrp_script check_nginx {
    script "/usr/bin/check_nginx.sh"
    interval 2
    weight -20
}
check_nginx.sh 的内容就一句话:killall -0 nginx(检查nginx进程是否存在),不存在则返回非0,Keepalived就会执行切换。
第五步:验证切换是否生效
在主服务器上执行 ip addr show eth0,能看到VIP绑定在上面,然后模拟故障:systemctl stop keepalived,过2-3秒再到备服务器上执行同样的命令,你会发现VIP已经自动跑到备机的网卡上,这个过程中,外部用户通过VIP访问服务,几乎不受影响。
物理服务器租用哪个机房稳定,从故障切换角度说,尽量选支持同城双机柜的IDC,就是把两台物理服务器放在同一个机房但不同的机柜,或者同一栋楼的不同电力和网络区域,防止单个机柜断电导致两台机器同时凉掉。
租用物理服务器做高可用,成本上的实际考量
说了这么多技术方案,最后聊实操层面的钱和权问题,这是很多团队最犹豫的地方。
- 租用成本:两台物理服务器的物理服务器租用价格
通常比在云平台上跑两台同配置云主机便宜不少,尤其是长期使用(一年以上)的场景,价格优势更明显
- 维护成本:Keepalived、HAProxy这些软件都是开源免费的,不产生授权费,最大的隐形成本是运维人员的学习时间第一次配置节奏可能慢,但配置好后长期运行很省心
- 带宽成本:物理服务器租用带宽一般是独占的,不跟其他租户抢,故障切换时不担心邻居机器跑满带宽挤掉心跳包
- 扩展成本:如果业务涨了,从2台扩到3台只需要让IDC再开一台机器,自己把配置复制过去加进集群,不像云环境那样自动伸缩,但胜在可控、无额外服务费
对于预算有限但又不想牺牲可用性的创业公司或中型企业,租物理服务器+自建故障切换是用有限的物理服务器故障切换方案预算换取核心业务稳定性的一个务实选择。
关于租用物理服务器故障切换的常见疑问
物理服务器换IP后,域名解析也需要改吗?
不需要,域名解析始终指向VIP,VIP从主服务器漂移到备服务器后,域名解析的指向不变,因为VIP是独立于两台物理机的逻辑地址,你只要确保VIP和域名解析(A记录)绑定就行,其余交给Keepalived自动处理。
如果不做任何故障切换方案,物理服务器宕机了会怎样?
业务直接中断,如果IDC监控到宕机,需要人工联系你确认处理方式,然后重启系统或更换硬件,整个恢复流程从几十分钟到几小时不等,没有VIP漂移和集群保障的物理服务器,本质上和一台独立PC没区别坏了自己担着,这也是为什么不少IDC租赁合同中会写明“硬件故障响应时效”,但不会为你承担业务中断损失。
主备两台服务器需要同配置吗?
不需要严格同配置,但行业里大多数用户会选同配置,原因是心理踏实且便于后续更换,备机配置可以低一档,只要在主服务器宕机时能扛住流量就行,如果你的业务平时负载较高,建议备机选择同规格,确保切换后性能不缩水。
租用的物理服务器和自建机房在故障切换能力上没有本质差距,关键是你是否愿意花半小时配置好Keepalived,以及IDC是否提供稳定的内网通信环境,把VIP这条“保命线”拉起来,物理服务器同样能做到像云主机一样从容面对故障。