GPU服务器托管这件事,真正拉开差距的从来不是带宽或IP,而是机房有没有能力喂饱你那几台高功率设备。多数普通机柜的供电冗余在2kW到3kW之间,而一台主流8卡GPU服务器满载功耗就能轻松顶到4000W以上,如果托管方供电跟不上,设备性能会被迫降频,严重的直接宕机,选托管前先看电气参数,比谈价格重要得多。
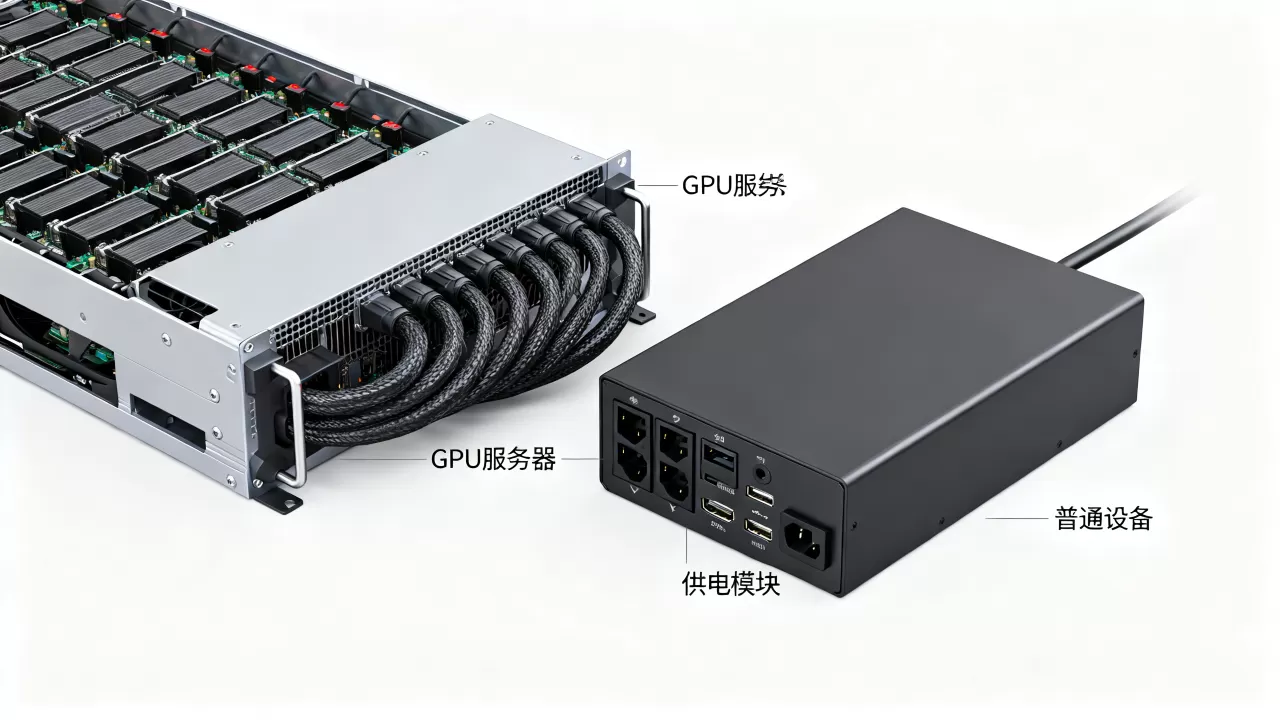
单台GPU服务器的耗电规模,和普通设备完全不在一个量级
很多第一次做GPU托管的朋友,习惯拿传统1U/2U服务器的经验去套,结果到了机房一看电费账单直接懵了,咱们先把账算清楚。
一张显卡的功耗,就顶得上一整台普通服务器
市面上常见的普通机架式服务器,双路CPU加一堆硬盘,满载功耗通常在600W到1200W区间,而单块专业计算卡,比如NVIDIA A100 80GB,TDP标称400W,新一代的H100更是直接站上700W,这意味着一块H100显卡的耗电量,约等于一整台传统数据库服务器的整机功耗。
一台典型的8卡GPU服务器,光显卡部分就是8乘以400W等于3200W的基线功耗,再加上双路CPU、系统内存、NVMe硬盘阵列、高速网卡以及风扇墙的功耗,整机满载摸到4200W到4500W是常态,如果是H100的8卡机型,满载逼近6000W的例子并不罕见,这还没算上机房空调为带走这些热量所额外消耗的制冷电费。
普通机柜的供电天花板,卡死了大半托管方案
行业共识认为,传统电信机房的单机柜供电能力普遍在2.2kVA到4.5kVA之间,换算成功率约等于2kW到3.6kW,这个容量设计,当初是给“一堆1U服务器”或者“刀片服务器”预备的,压根没有预见单台8卡GPU服务器的形态。
现在稍微像样点的数据中心,针对高性能计算区域会提供6kW、8kW甚至12kW的单机柜供电,但这类高配电柜数量有限,而且租金直接翻倍,很多宣传“支持GPU托管”的机房,实际只是把普通机柜腾出来,电表容量根本没扩容,你签合同前不确认配电参数,等设备上架后合闸瞬间,机房总开关跳闸的案例太多了。
供电不足的托管机房,会让GPU服务器性能大打折扣
供电不上不下最尴尬,不是完全带不动,而是电压和电流根本无法支撑GPU的瞬时性能尖峰。
降频和性能衰减比宕机更隐蔽
GPU在跑深度学习训练或者渲染任务时,功耗不是恒定的,而是随着计算负载剧烈波动,当整机功耗冲高时,如果机柜的供电线路压降过大,服务器电源管理机制会主动介入。
核心频率被打压、显存时钟往下掉,直观感受就是训练速度慢了近三分之一,但机器没有报警。
你排查网络、软件、驱动环境,一切正常,最后找机房运维要了PDU的实时电流读数才发现,电压已经跌到200V以下,设备在“饿着肚子干活”,这种隐性降频造成的GPU算力损失,造成的隐性成本远超你省下来的那点托管费。
供电冗余为零时,突然断电会直接毁掉训练任务
行业里某些低价托管机房,为了多塞几台机器,会在一路UPS后端挂超出额定负载的设备,平时负载低看不出来,一旦机房总输入高压侧闪断,UPS瞬间过载直接切旁路,服务器经历一次硬断电。
对于动辄训练几十个小时的模型来说,断电意味着检查点文件损坏、之前跑的算力全部报废,数据可以重新同步,但丢失的时间窗口补不回来,业内专家指出,GPU服务器因供电问题导致的非计划停机,是各类故障原因中占比最高的类型之一。
怎么判断一个托管机房能不能喂饱GPU服务器
选址考察不能只听销售吹“我们有GPU专区”,你得自己看电气图纸和现场设备。
第一步:算清你真实需要的功率上限
不要按GPU的TDP算,那个值偏理论,你要按整机的实际满载功耗再加上15%到20%的冗余余量来算。
- 以A100 8卡机为例:整机满载约4.5kW,预留余量后建议按5kW到6kW申报。
- 以H100 8卡机为例:整机满载接近6kW,申报功率建议不低于7.5kW。
- 如果是4卡机,整机功耗约2.5kW,但建议仍然按5kW起报。
这一步的目的是确保在跑极端负载时,供电链路不会成为瓶颈。
第二步:核查机柜的PDU规格和UPS容量
具体操作路径是这样:跟机房要机柜的配电示意图,重点看三处。
- PDU输入电流是32A还是16A,16A的国标插座在220V下极限只有3.5kW,带不动8卡机。
- UPS主机容量和当前负载率,负载率超过70%的机房,尽量不要考虑,因为逆变器余量不足。
- 柴发机组的带载能力,如果市电断了,柴发顶着,但柴发容量不够,照样是机房整体降压或局部甩负载。
第三步:直接问清“高密机柜”的空余位置和电表计费方式
不少机房把6kW以上的机柜称作高密机柜,你要确认的不仅是价格,还有这路供电是否独享,有些机房会在一台高密机柜里塞两台GPU服务器,共享6kW,结果每台只能分到3kW,跑起来必然抢电。
电费结算方式也很关键,按设备铭牌功率包干计费,还是按实际电表走读计费,差别很大,按实测电表走字虽然看着单价高一点,但对于真跑负载的用户来说,往往包干价更划算,因为机房会把空载和制冷损耗折算进去。
GPU服务器托管价格为什么参差不齐,供电是决定性变量
很多用户在网上问“GPU服务器托管多少钱一台”,得到的报价从每月几百到几千都有,抛开带宽和IP数量,最大的差价基本都体现在供电容量和制冷配套上。
同一个机柜,配电等级不同价格差三倍
普通机柜(2.5kW供电):月租六百到千元起步,适合放1U或低功耗设备。
中配电柜(4kW供电):月租普遍在一千五到两千五区间,带单台4卡勉强够。
高密机柜(6kW到8kW供电):月租直接跳到三千五到六千,而且通常要求签约半年或整年。
如果你要托管的是8卡A100整机,按最低6kW申电,那么机柜租金里有一大半是在为电容量买单,价格便宜到明显低于市场行情的托管方案,大概率在供电上留了暗坑。
冷却是供电的伴生成本,风冷和水冷方案怎么选
高功耗必然伴随高热密度,一个标准42U机柜如果放了2台8卡GPU服务器,出风温度能飙到45°C以上,普通风冷空调在这种局部热点下几乎无力回天。
目前主流的两个方案:
精密空调加封闭冷通道:适合单柜功率6kW到10kW的场景,机房通过精确送风,把冷空气直接压入机柜前端,这个方案需要机房有专门的地板下送风结构。
液冷背门或直接水冷板:针对12kW以上的超高密度机柜,需要机房预埋冷媒管道,很多老机房改造做不了。
你在考察时,务必问清机柜所在区域的空调送风方式和回风温度标准,有些机房虽然供电够,但制冷跟不上,夏天高温天气设备照样热宕机。
签合同时把供电保障条款写死
有实际运维经验的人都知道,口头约定的供电指标毫无意义,合同附件里必须写明:
单机柜最低可用功率数值,精确到kW。
PDU接口规格和最大承载电流(A)。
UPS和柴发在单路故障时的切换时间与带载保障范围。
机房环境温度控制范围,例如18°C到27°C。
如果因机房供电原因导致设备宕机,赔偿标准和处理时效。
这些条款落实在纸面上,比销售承诺“绝对没问题”有用得多。
常见的GPU托管供电疑问
GPU服务器托管需要什么条件才能保证供电稳定
核心条件是机房配电系统具备独立的GPU高密区域规划,你需要确认三件事:一是单机柜可用功率不低于你整机满载的1.2倍;二是机房UPS系统采用2N冗余架构,且电池后备时间至少满足柴发启动的时限要求;三是机柜所在机房的制冷系统具备独立调节能力,不要和普通低功耗区域的温控混在一起。
GPU服务器托管和普通服务器托管有哪些区别
区别集中体现在三个维度,第一是电气维度,普通服务器托管关注带宽和IP数,GPU托管首先关注的是机柜供电曲线能否覆盖GPU的功耗脉冲;第二是热管理维度,普通服务器每柜3kW左右热量,自然风冷即可,GPU高密机柜必须依赖精密空调或液冷系统;第三是运维维度,GPU机房需要更严格的防尘和温湿度波动控制,因为这些都会直接影响GPU的Boost频率稳定性,总体来看,GPU托管的隐性门槛全在基础设施的物理极限上。
GPU服务器托管电费是怎么计算的
行业里主要有两种算法,一种是包电模式,无论你用多少电,按月收取固定的电费或直接并入机柜租金,适合功耗模型稳定、长期满载跑训练的场景,另一种是独立电表模式,机房在机柜内安装电能表,按每度电单价乘以实际读数收费,适合负载波动大的情况,实际操作中,机房给出的电价通常是含税价,普遍高于居民电价,因为包含了线损、UPS损耗和制冷分摊,签约前建议直接问清电表读数频率和结算周期,避免中间环节加价。
GPU服务器托管的省钱捷径从来不在砍单价,而在于把供电冗余算够。先确认机柜能给多少电,再谈多少带宽和价格,别让设备在“半饥饿”状态下委屈运行。把供电和散热这两个物理底座夯实了,你的GPU集群才有机会跑出应有的性能。