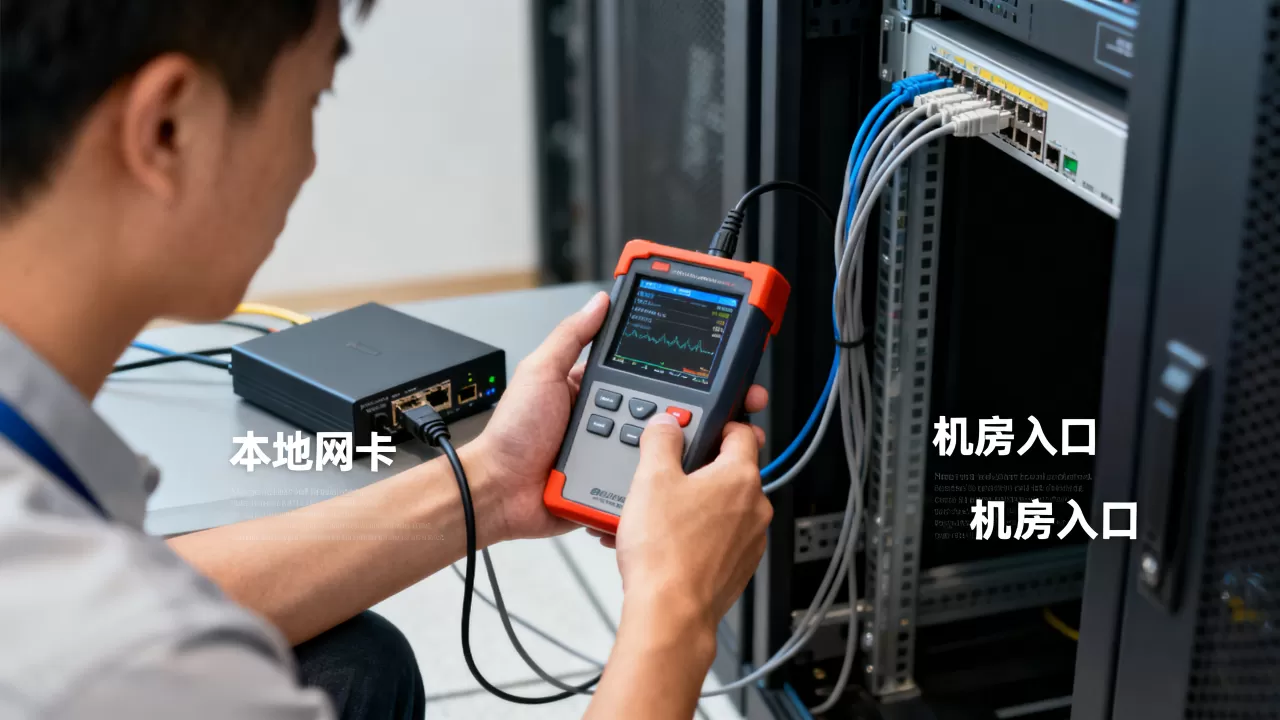
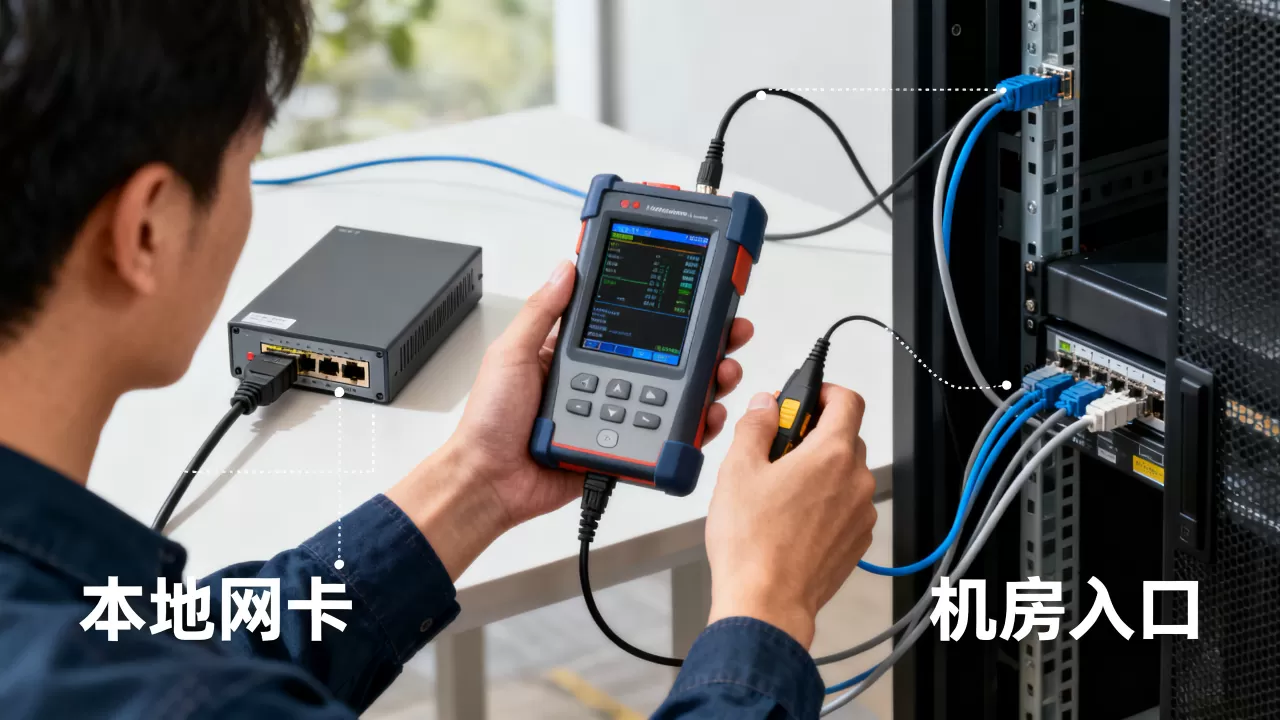
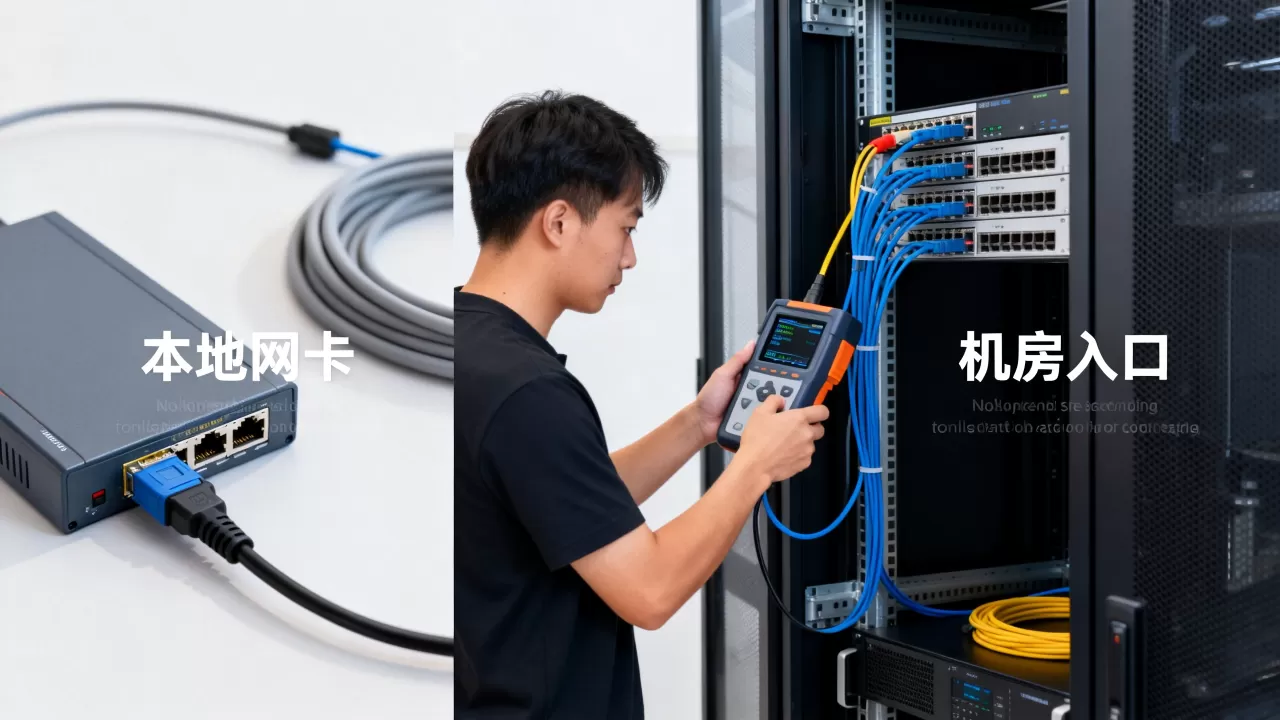
排查丢包的正确顺序是从本地网卡开始,先软件后硬件、先本机后链路,逐段缩小范围,最后锁定在机房入口设备上。如果你一上来就去ping机房网关,发现丢包就以为是机房的问题,很可能被中间链路“带偏”方向,下面这条排查路径,是处理过大量线上故障后总结出来的顺序。
先分清丢包发生在哪一段
丢包这件事,最怕的就是“凭感觉”,你以为丢包在公网,其实可能是你本机网卡驱动在捣乱;你以为机房入口有问题,结果一查是上联交换机端口CRC错误爆表。
丢包表现为哪几种形态
- 间歇性丢包:ping几十个包掉两三个,不影响大流量但影响实时业务。
- 持续丢包:延迟越来越高,重传激增,业务基本不可用。
- 单向丢包:从你这边ping机房正常,从机房ping你却丢包,这类问题经常被忽略,一定要两头都测。
用一种不再纠结的方法开始排查
所有排查都遵循一个原则:从源到目标,逐跳缩小范围,不要跨段判断,不要跳过物理层去看应用层。
第一步,从本地网卡到交换机这段怎么排查
本地网卡丢包怎么排查
先看本机,因为你控制力最强,多数人忽略的是,网卡本身就有丢包计数。
Linux系统:
ifconfig eth0重点看 RX errors、RX dropped、TX dropped 这几个字段,如果RX dropped持续增长,说明网卡缓冲区不够或者驱动有问题。
再深入一层:
ethtool -S eth0 | grep -E "drop|error|miss"这里能看到更细的计数,rx_missed、rx_fifo_errors,这些数值一旦不为0,说明内核协议栈来不及处理,不一定是链路问题。
Windows系统:
打开“性能监视器”,添加计数器 Network InterfacePackets Received Discarded,观察持续变化。
如果你是做直播、游戏加速这类高带宽业务,可以同步跑一个UDP压测工具,
iperf3 -u -b 100M,观察对端收到多少包,对比本端发送量,差值就是本机丢包。
局域网ping丢包排查步骤:先排除本机再责怪上游
本机没问题,接着往下看,先ping网关地址,ping 192.168.1.1 -c 100 -i 0.1,这里的判断逻辑很简单:
- ping网关丢包率低于0.1%:说明本机到网关这一段基本健康,继续往上查。
- ping网关丢包率超过0.5%:问题大概率出在这段局域网内,这时先换一根网线试试,再换个交换机端口试试,这类问题相当一部分是接触不良或网线质量差造成的。
业内专家指出,在局域网内排查丢包,最值得投入时间的是检查交换机端口的错误计数:
show interface gigabitEthernet 0/1看 input errors、CRC errors、collisions 这几个字段,CRC错误增多说明物理层存在干扰或线缆衰减,光看ping结果很难判断出来。
继续往下追:从核心交换机到防火墙
如果本机和接入交换机都正常,把ping目标换成核心交换机的VLAN虚接口IP,再换成防火墙出口IP,每换一个目标,丢包率都记录一下,哪一个IP开始出现丢包,问题就出在哪一段。
第二步,从本机追踪到机房入口丢包怎么排查
到这里,你已经确认问题不在局域网内,接下来要从跨网络段的角度继续往后摸。
用mtr一次性看清整条链路
不要只用 ping,因为它看到的只是整体结果,看不到每一跳的分布情况,用 mtr 才能看到每一跳的丢包率。
Linux系统:
mtr -r -c 100 机房入口IPWindows系统:
tracert 机房入口IPmtr输出里每一行就是一个路由器节点,这时候重点看两列:
- Loss%列:如果中间某跳Loss很高,但后一跳恢复正常,那多半是中间节点对ICMP限速,不必太紧张。
- 最后一跳之前的持续高Loss:这才是真丢包,如果从第8跳到第15跳都这样,那问题很可能出在同一条链路上。
跨地域网络丢包原因对比:CN2和普通线路的差距
如果你访问的是跨地区的机房,比如人在上海访问北京机房,丢包原因和线路选型高度相关,全网是CN2 GIA还是普通163骨干网,稳定性完全不同。选择机房时不要只对比带宽价格,带宽价格便宜但晚高峰丢包严重的线路,业务体验会大打折扣。
- 普通163线路:晚高峰丢包率可能上升到10%以上,延迟波动大。
- CN2 GIA线路:多数情况下丢包率低于1%,但价格更高。
- BGP多线:跨运营商访问时相对友好,但在跨地域调用场景下优势不明显。
跨地域丢包的处理思路
本机到机房入口链路丢包一旦确认,先切换备用IP测试,很多IDC提供多个入口IP,换一个测试就能判断是链路问题还是机房设备问题,再看 ping 测的是哪个端口,机房入口的DDoS防护设备也会对ICMP限速,这时用TCP端口连通性测试代替ping更有效:
tcping 机房入口IP 80TCP握手成功率比ping更能反映真实业务连通性。
第三步,机房入口的硬件和路由问题
入口防火墙和负载均衡设备的性能瓶颈
到了机房入口这一步,核心要排查的是防火墙和负载均衡设备是否成了瓶颈,防火墙开启了安全策略日志记录、NAT日志、DDoS清洗规则时,性能下降很常见,这种情况下ping大包比ping小包更能发现问题:
ping -s 1400 机房入口IP连续ping超过1400字节的大包,如果分片被丢弃,说明链路上存在MTU问题,或者中间设备限制了包长。MTU不一致导致的丢包,表现是ping小包正常、ping大包丢,这和大流量传输失败高度重合。
联系机房时给出这些信息
网上找机房客服或者技术支撑时,直接提交这些信息,处理效率会高很多:
- mtr排查结果截图,包含IP、丢包率、每一跳延迟数据
- 本地ping的丢包率记录
- 发起测试的时间段和持续时间
- 大概持续了多久,是否和业务高峰期重合
- 其他地域测试正常的对比记录
服务器丢包排查流程图的终点在哪里
如果机房入口各节点都正常,那么问题就收束到服务器本身,再次返回本机排查,重点检查几个方面:
- 带宽跑满:入口带宽跑到上限时,核心丢包率会明显上升,这是最常见的原因。
- 入方向流量突发:连接数突增导致防火墙会话表满,新连接直接丢弃。
- CPU软中断集中在单核:多队列网卡没有开启RSS,中断全压在一个CPU上,会导致这个核处理不过来而丢包。
据工信部数据,近年来国内数据中心规模持续扩大,跨地域访问场景越来越多,上面这些原因在实际故障中占了较大比例,也就是说,你的问题不一定是特例,按顺序排查能找到根因。
本地网卡到机房入口丢包常见问题解答
查了本地网卡没发现问题,为什么还要继续往上查?
本地网卡正常只说明第一段链路没问题,丢包可能发生在局域网交换机、核心路由、公网链路或者机房入口等多个节点,只有逐跳排除才能找到确切故障位置。
ping都通,但游戏或者视频会议依然卡顿,这是丢包吗?
ping用的是ICMP协议,你跑的业务用的是TCP/UDP协议,部分路由器对ICMP有限速,所以ICMP测试看起来正常,不代表TCP/UDP流量不丢包,建议用 tcping 测试TCP端口连通性,或者用 iperf3 打流测试UDP丢包率。
mtr显示中间几跳丢包,但最后一跳丢包为0,这说明什么?
说明中间节点对ICMP探测报文做了限速,实际业务流量并没有丢包,真正的丢包要看最后一跳之前的所有节点是否同时高丢包,以及业务层是否出现重传现象。