主库把预算和参数优先级交给写入性能与事务安全,从库则围绕复制应用速度与读并发能力做配置,两者不能简单按相同规格采购。
读写分离听起来像是“买两台服务器,一台写一台读”,实际操作时,主库和从库在CPU、内存、磁盘、网络以及数据库参数上的差异,会直接影响整套架构能不能扛住业务压力,如果不把配置差异确定清楚,最常见的结果就是:主库写入没问题,从库复制追不上,或者从库读性能浪费、主库磁盘被打满,下面从配置维度、延迟解决、预算分配、地域部署以及实操路径几个方面,把这件事拆开讲透。
读写分离主从服务器配置差异有哪些?先看五个核心维度
主库和从库的角色不同,压力模型也不同,主库面对的是高频写入、事务提交、binlog生成,从库面对的是复制线程回放、大量SELECT查询,配置差异的判断,不能只盯着CPU核心数,还要看下面五个维度。
- CPU侧重:主库要高频单核性能,从库要多核并行复制能力。
- 内存侧重:主库缓冲写入热点,从库缓存读热点。
- 磁盘侧重:主库看顺序写和日志刷盘,从库看随机读和复制回放。
- 网络侧重:主从之间需要低时延、高稳定内网链路。
- 参数侧重:主库提升持久化级别,从库打开并行复制和只读保护。
下面对主库和从库的配置差异做一个直观对比。
| 配置项 | 主库建议 | 从库建议 |
|---|---|---|
| CPU优先级 | 高主频、低核心数可接受 | 多核心优先,单核性能不能过低 |
| 内存大小 | 满足写入缓冲和事务日志 | 尽量放大,缓存更多热数据 |
| 磁盘类型 | NVMe SSD,独立日志盘更稳 | SSD即可,容量优先于极限写速度 |
| 网络要求 | 和从库同可用区或低时延专线 | 靠近主库部署,避免公网复制 |
| 关键参数 | sync_binlog=1,每次事务刷盘 | slave_parallel_workers调大 |
| 实例规格 | 独占型或独享型为主 | 通用型起步,按读QPS扩展 |
这张表能解释一个常见误区:主库不一定要比从库“贵很多”,但主库的钱要花在写入路径上,从库的钱要花在内存和读路径上。
主库配置重点:写入性能与事务安全优先
主库的配置差异,本质是让每一笔写入都能安全落盘,同时尽快释放连接,这里有两个数据库参数必须确定清楚。
-- 主库关键参数示例
sync_binlog = 1
innodb_flush_log_at_trx_commit = 1
这两行配置看起来不起眼,实际作用很大,sync_binlog=1表示每次事务提交都同步binlog到磁盘,innodb_flush_log_at_trx_commit=1表示每次事务提交都刷redo log,这样配置牺牲一点写入吞吐,换取主库宕机后数据不丢失,行业共识认为,读写分离架构主库的持久化级别不建议降级,否则从库切主时容易出现数据丢失。
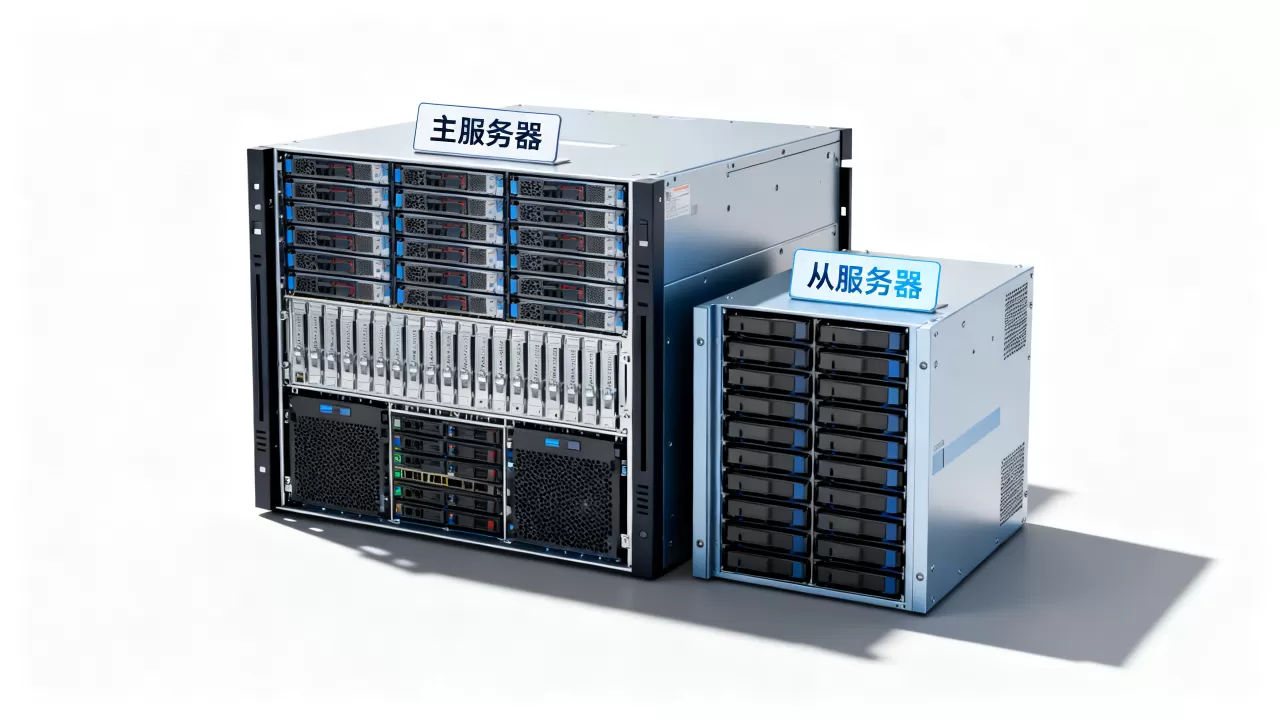
主库的硬盘不能用云盘默认性能,多数情况下,主库需要把数据目录和binlog目录分开,binlog单独放一块高IOPS的SSD,因为binlog是顺序写,redo log也是顺序写,和InnoDB数据文件的随机写混在一起,会互相拖慢,实际操作路径可以这样:
# 查看磁盘写入压力
iostat -x 1
# 关注await和util,主库util长时间接近100%就需要拆分日志盘
主库CPU选择上,不用盲目堆核,写入事务在MySQL里多数还是单线程模型,一个复杂事务可能只跑在单个核上,主库CPU应优先选主频更高的规格,核心数满足业务连接数即可。
从库配置重点:复制应用与读并发优先
从库的配置差异,核心是让复制线程追得上主库,同时还能扛住大量读请求,从库上最常见的参数调整如下。
-- 从库关键参数示例
read_only = ON
super_read_only = ON
slave_parallel_type = LOGICAL_CLOCK
slave_parallel_workers = 8
read_only和super_read_only是保护从库不被误写的基础配置,slave_parallel_workers是并行复制回放线程数,这个值不是越大越好,一般和从库CPU核心数匹配,8到16是常见范围,如果从库还承担级联复制,需要打开log_slave_updates,否则不需要。
从库内存可以比主库更大,比如读多写少的电商商品库,商品详情、库存快照等热数据需要大量缓存,从库的Buffer Pool大小直接决定查询是否走磁盘,实操时可以查看缓存命中率:
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool_read_requests';
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool_reads';
如果reads占requests的比例偏高,说明从库内存不够,查询频繁穿透到磁盘。
主从复制延迟怎么解决?配置差异里藏着答案
主从复制延迟是读写分离架构里最让人头疼的问题,很多团队会直接升级从库硬件,但延迟的根源往往是配置差异没有确定好,延迟在监控里表现为主库写入后,从库执行同样的写操作慢半拍,Seconds_Behind_Master持续大于0。
解决延迟,先看从库配置是否比主库弱太多,一个主库用高频核和NVMe盘,从库用低配虚拟机加普通云盘,这是典型的配置差异倒挂,业内专家指出,从库单核性能不建议低于主库单核性能太多,否则复制回放会跟不上。
具体从配置差异解决延迟的步骤:
- 检查主从复制格式,主库binlog_format建议用ROW,ROW格式在从库回放时能减少主从数据不一致的概率,对部分复杂SQL的延迟控制也更好。
- 调整从库并行复制,把slave_parallel_type改为LOGICAL_CLOCK,让从库按组提交并行回放,而不是单线程串行执行。
- 打开半同步复制,主库提交时等待至少一个从库确认收到binlog,这会增加主库写入响应时间,但能大幅降低延迟和数据丢失风险。
- 从库关闭不必要的日志,如果从库不做级联复制,log_slave_updates保持OFF,减少从库额外写盘负担。
- 网络方面,主从尽量同可用区部署,避免跨地域公网复制。
延迟场景不同,配置差异的侧重点也不一样,订单、支付类业务对延迟敏感,主库配置必须保持较高写入性能,从库数量不宜过多,否则半同步等待时间变长,报表、数据分析类业务对延迟容忍度高,从库可以堆内存、挂更多读节点,配置上向读吞吐倾斜。
读写分离服务器配置多少钱?预算分配不是平均主义
“读写分离服务器配置多少钱”这个问题,很多团队会按照两台同样配置的服务器做预算,但实际采购中,主库和从库的价格分配应该错开。
主流云厂商的数据库实例价格差异,主要来自CPU类型、磁盘类型和内存容量,主库通常选择独享型实例,确保CPU和内存不被其他租户争抢;从库可以用通用型实例起步,内存做大,磁盘用高效云盘,价格上,同样的8核16G,独享型比通用型贵一档,但主库选独享型比从库选独享型更有性价比。
配置差异带来的价格影响,可以这样判断:
- 主库优先保证磁盘IOPS,预算向NVMe SSD倾斜。
- 从库优先保证内存容量,预算向大内存规格倾斜。
- 主库CPU核数不用太多,但主频规格要选高一档。
- 从库在预算紧张时,可以适当降低CPU规格,保留内存和磁盘容量。
一个日写入量不大、读并发很高的内容平台,主库选4核16G独享型加500G NVMe SSD,从库选8核32G通用型加1T高效云盘,这个组合比两台同样配置成本更低,但读写分离效果更好,不要在从库上盲目省钱,从库太弱会导致延迟,最后只能把读流量切回主库,架构反而失败。
北京读写分离架构部署方案中的配置差异落地
北京地域的部署,常见于金融、在线教育、政企项目,对同城容灾和内网链路要求更高,读写分离架构在北京多可用区部署时,配置差异还要考虑可用区之间的网络时延。
主库通常放在主可用区,从库放在另一个可用区,北京同城可用区之间的网络时延一般较低,但跨可用区毕竟不是同一机房,主从复制链路要避免走公网,具体操作上:
- 在VPC内部建立主从实例,绑定内网域名,主库变更时不改应用代码。
- 从库所在子网的安全组只放通主库IP和业务读IP。
- 半同步复制建议打开,防止跨可用区网络抖动导致主库单点写入。
- 从库磁盘容量至少不低于主库,因为从库会保存同样的数据,还要额外存放relay log。
实操命令里,主从建立复制关系可以用以下方式,注意MASTER_HOST填写主库内网地址:
CHANGE MASTER TO
  MASTER_HOST='主库内网IP',
  MASTER_USER='repl_user',
  MASTER_PASSWORD='你的密码',
  MASTER_LOG_FILE='主库当前binlog文件名',
  MASTER_LOG_POS=主库当前binlog位置;
START SLAVE;
北京地域部署时,从库配置不要比主库低太多,同城跨可用区,复制链路的网络往返虽然不高,但从库自身回放太慢会放大延迟,从库CPU核数可以少于主库,但单核主频保持在同一代硬件水平。
配置差异确定的三步实操路径
配置差异不是拍脑袋决定的,要按业务指标一步步确定,下面三步可以在生产环境评估时直接使用。
第一步:采集业务读写模型
登录现有单机数据库,获取读和写的真实比例,以及读写压力峰值。
SHOW GLOBAL STATUS LIKE 'Com_select';
SHOW GLOBAL STATUS LIKE 'Com_insert';
SHOW GLOBAL STATUS LIKE 'Com_update';
SHOW GLOBAL STATUS LIKE 'Com_delete';
用Com_select的值和写入操作值的总和相除,就能得到读写占比,如果读占比远高于写占比,从库内存和连接数要大幅加强;如果写占比不低,主库磁盘和CPU要优先保证。
第二步:确定主库基准配置
根据写入TPS和事务大小定主库,TPS高,优先选独享型CPU和NVMe盘,每天写入量不大但单条SQL重,CPU主频更重要,主库参数按持久化安全配置,不为了性能调低sync_binlog。
第三步:从库按复制压力反推配置
从库配置至少保证复制线程不堆积,可以先用和主库接近的规格跑一段时间,观察复制延迟,如果Seconds_Behind_Master经常大于0,优先查从库CPU和磁盘利用率,利用率高就升级从库规格;利用率低就调整并行复制参数,而不是盲目加钱。
整个确定过程中,配置差异会自然浮出来:主库的问题集中在写入和刷盘,从库的问题集中在回放和读缓存,哪一侧有瓶颈,就把钱和参数调到哪一侧。
读写分离主从服务器配置差异常见问题
读写分离架构中从库内存应该比主库大吗?
读多写少场景下,从库内存可以比主库大,内存用于缓存热数据,从库承接大量SELECT,Buffer Pool越大,读性能越好,主库内存只要满足写入缓冲和事务处理即可,不需要为了读缓存堆高内存,如果写多读少,主库内存也要相应加大。
主从服务器配置差异会不会导致数据不一致?
配置差异本身不会直接导致数据不一致,数据不一致的常见来源是复制链路异常、binlog格式选择不当、从库被误写,主从配置不同时,更重要的是保持主从数据库版本一致、字符集一致、时间字段类型一致,从库打开read_only和super_read_only能防止人为误写。
小预算项目读写分离服务器配置怎么选?
小预算项目的主库选高IOPS云盘和独享CPU,从库选通用型和大内存,先控制为单从库,业务读压力增大后再加从库节点,主库磁盘容量可以只留当前数据的1.5到2倍,从库磁盘容量同样大小,内存比例向从库倾斜,小型项目不用一上来就上半同步复制,主从延迟可接受时异步复制成本更低。