主从复制延迟、网络带宽余量、从库磁盘与CPU配置,多数生产环境单主挂5个以内从库能保持稳定,超过这个数就要引入级联复制或读写分离中间件。
从库扩展能力怎么评估:先看这三个硬指标
从库不是越多越好,每增加一个从库,主库就要多推一份binlog,网络要多走一份流量,从库自己还要扛住回放压力,评估扩展能力,先盯住三个硬指标。
- 复制延迟:主库写入后,从库多久能追上,延迟越大,从库读到的数据越旧,报表、对账、缓存刷新都会出问题。
- 网络带宽:主库网卡上行吞吐、机房内网带宽、跨地域专线带宽,从库数量翻倍,带宽需求基本也是翻倍。
- 从库硬件:从库不只是“读库”,它要回放主库的写操作,CPU、内存、磁盘IOPS不够,回放速度跟不上,延迟就会拉高。
这三项不是孤立判断,延迟高,先看带宽是不是打满,再看从库磁盘是不是在排队,最后才怀疑主库压力。
一主多从架构主从复制延迟多少算正常
这个问题的答案依赖业务类型,在线交易类业务,从库延迟通常要控制在秒级以内,报表分析类从库,延迟放宽到分钟级甚至更久也能接受。
实操中一条命令就能看延迟:
SHOW SLAVE STATUSG
重点看 Seconds_Behind_Master 字段,这个字段为0,不代表零延迟,只代表从库正在执行的最新事件时间与主库当前时间没有明显差距,最准确的做法是把主库当前时间与从库已回放事件的时间戳做对比。
多数情况下,一主多从架构主从复制延迟多少算正常,行业共识认为在线业务从库持续超过5秒就需要排查,偶尔的毛刺可以容忍,持续高位说明扩展能力已经触顶。
从库服务器配置推荐:北京地区一主多从架构租用价格怎么算
从库的硬件配置要跟着主库走,而不是随便买一台低配机器,主库写入量大,从库回放的压力并不小。
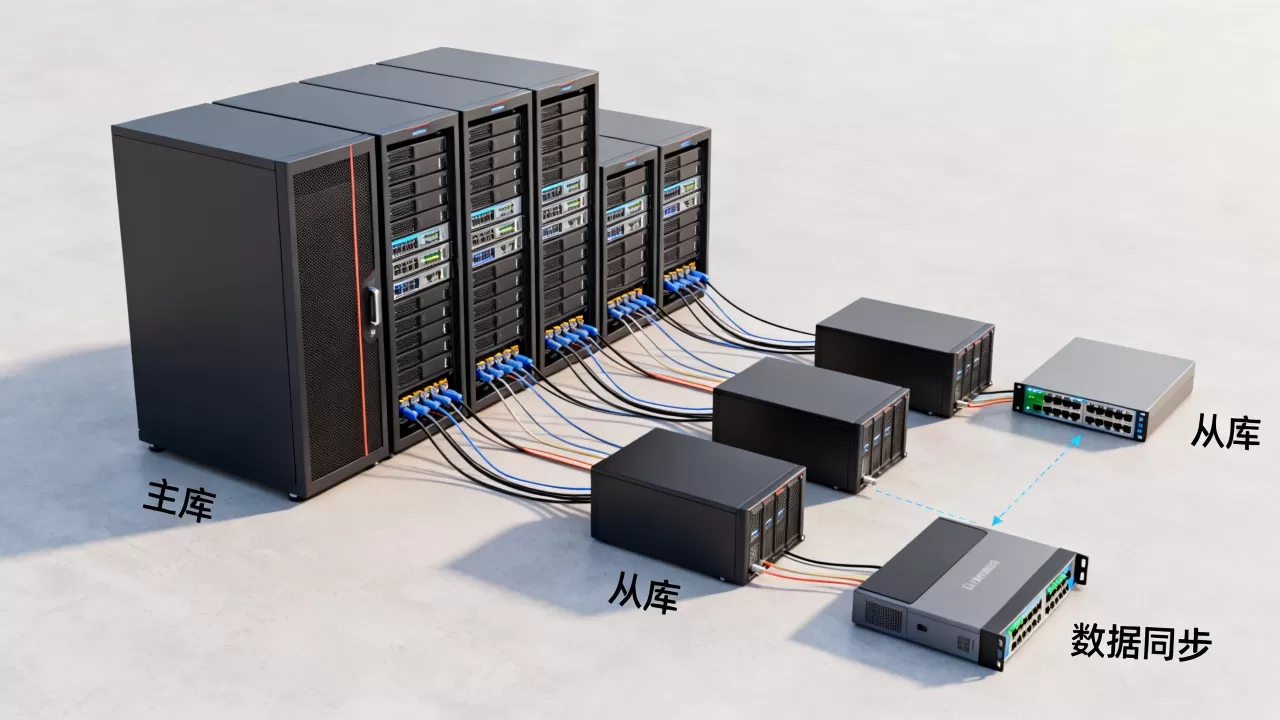
- CPU:从库至少保持与主库同代架构,核心数可以少一点,但单核频率不能太低。
- 内存:InnoDB Buffer Pool 要能装下热点数据,否则磁盘读会拖慢回放。
- 磁盘:优先SSD,NVMe更好,SATA盘在从库回放大批量写入时,IO等待会明显上升。
北京地区一主多从架构服务器租用价格受带宽、存储类型、机房等级影响较大,同样配置,BGP多线机房比单线机房贵,SSD机型比SATA机型贵一档,部分服务商对从库只提供内网带宽,价格会低一些;如果需要跨地域同步,专线费用要单独算。
建议从库优先选与主库同机房或同可用区,走内网复制,这样带宽成本低,延迟也小。
一主多从最多能挂几个从库
没有绝对上限,但实际生产中,单主直接挂5个以内从库是多数架构师的默认选择,超过5个,主库的binlog dump线程会增多,网卡上行容易成为瓶颈。
如果业务确实需要更多读副本,可以采用级联复制:主库只同步给2到3个中间从库,再由中间从库向下分发,这样主库压力可控,从库总数能扩到十几个甚至更多。
业内专家指出,判断从库数量上限,最简单的办法是观察主库网卡出口使用率和CPU单核负载,只要有一项接近饱和,就说明该换级联方案或引入中间件了。
从库扩展的实操步骤:从备份到监控
添加从库不是改个配置就完事,完整流程包含备份、恢复、建立复制、监控四个环节。
在主库执行备份,带上binlog位置信息:
mysqldump --single-transaction --master-data=2 -A > full_backup.sql
把备份恢复到新从库:
mysql < full_backup.sql
在从库上配置主库连接信息:
CHANGE MASTER TO
  MASTER_HOST='主库内网IP',
  MASTER_USER='repl_user',
  MASTER_PASSWORD='repl_password',
  MASTER_LOG_FILE='mysql-bin.000001',
  MASTER_LOG_POS=123456;
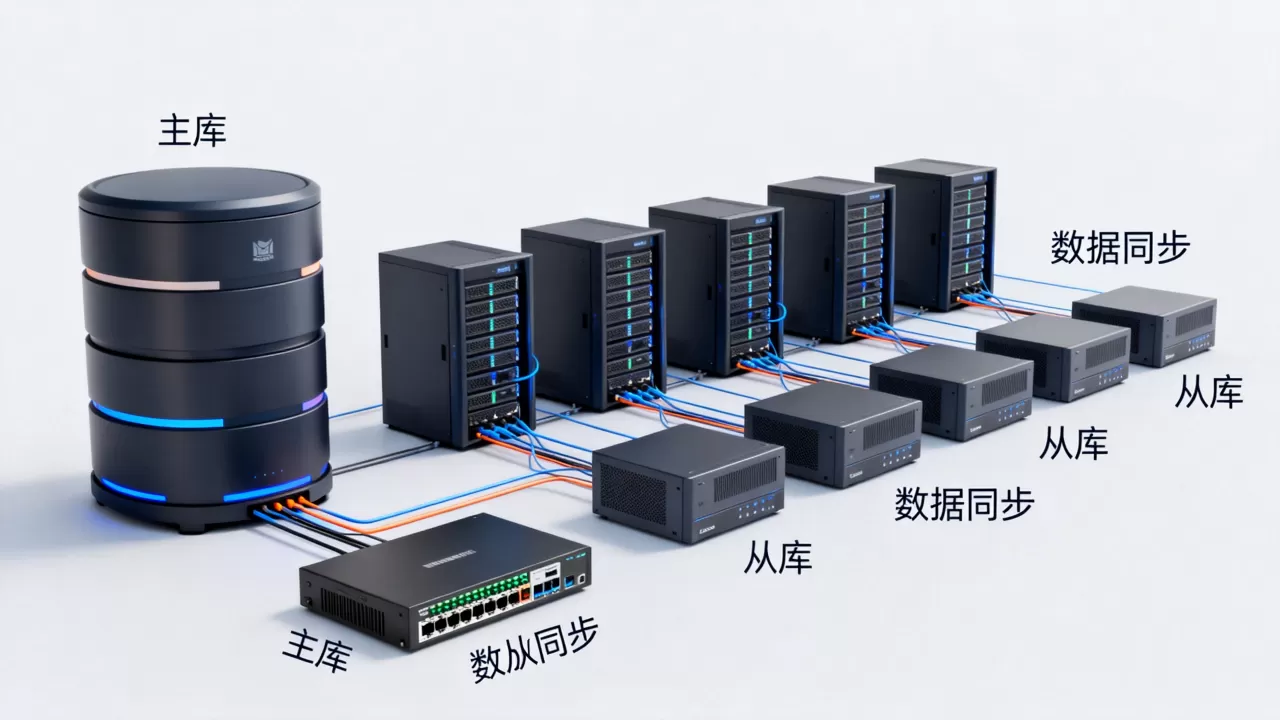
启动复制并检查状态:
START SLAVE;
SHOW SLAVE STATUSG;
- 写入监控脚本,定时采集
Seconds_Behind_Master和主库binlog文件大小,从库延迟超过阈值就告警,同时记录主库网卡流量。
这套流程可以重复用于横向扩展,每次新增从库后,主库的连接数和带宽占用都会上涨,所以扩展前要留出余量。
从库扩展能力对比:自建与云数据库只读实例
自建一主多从和云数据库只读实例的扩展逻辑不一样,自建更灵活,但运维成本高;云数据库扩展快,但要接受厂商限制。
| 对比维度 | 自建一主多从 | 云数据库只读实例 |
|---|---|---|
| 扩展速度 | 需要手动备份恢复,几十分钟到数小时 | 控制台点击创建,几分钟到十几分钟 |
| 硬件调整 | 可自由选配,更换磁盘或加内存需停服 | 在线升配,部分厂商支持自动扩容 |
| 带宽成本 | 同机房走内网,成本低 | 只读实例通常走内网,跨地域需额外付费 |
| 复制延迟 | 完全可控,可开启半同步 | 不同厂商的实现有差异,延迟波动较常见 |
| 从库数量 | 受主库硬件限制,通常5个以内 | 部分云产品支持更多只读副本,但费用按实例计 |
价格层面,自建一次性投入高,长期摊薄成本低;云数据库按小时或包年计费,从库数量越多,月度支出越高,短期测试可以上云,长期稳态业务更适合自建或混合方案。
从库扩展中容易踩的三个坑
半同步复制退化,开启半同步复制后,主库要等至少一个从库确认收到binlog才返回成功,如果从库网络抖动或硬件变慢,主库写入会被拖住,扩展从库前,要确认半同步的超时参数合理,否则一个慢从库会拖垮整套写链路。
从库读流量不均衡,如果应用层把大量复杂查询压到单一从库,这个从库的延迟会显著高于其他从库,扩展时要把读流量按业务类型拆分,报表查询单独走报表从库,线上查询走线上从库。
忽略主库binlog保留时间,新增从库往往要从头拉取历史binlog,如果主库binlog过期时间设置太短,新从库还没追平,主库已经把旧binlog清掉了,添加从库前,先调大 binlog_expire_logs_seconds,等从库追上后再调回来。
核心结论再强化
一主多从架构的从库扩展能力,最终看复制链路上每个环节是否留有余量:主库网卡、网络带宽、从库磁盘、从库CPU,先评估延迟和带宽,再确定从库数量和硬件配置,比盲目加机器可靠得多。
常见问题:一主多从架构从库扩展能力相关疑问
一主多从架构从库扩展能力怎么评估?
从三个层面评估:先看主库binlog产生速率和网卡上行带宽能否支撑更多从库,再看现有从库的 Seconds_Behind_Master 是否稳定,最后模拟新增从库后的压力,可以用 iftop 看主库出口流量,用 iostat 看从库磁盘利用率,三个数据凑齐,扩展上限基本就清楚了。
从库扩展时主从复制延迟怎么解决?
先定位延迟发生在哪个环节,网络打满就升级带宽或拆分从库到不同交换机;从库磁盘慢就换SSD或加大Buffer Pool;主库dump线程竞争CPU就控制从库数量,改用级联复制,必要时开启并行复制,让从库多线程回放事务,但这只对多线程写入的主库有效。
北京地区一主多从架构服务器租用价格受哪些因素影响?
价格主要受机房线路、带宽规格、存储类型、硬件代际四个因素影响,BGP多线比单线贵,SSD比SATA贵,新代CPU比旧代贵,同配置下,北京地区一主多从架构服务器租用价格还跟服务商提供的内网带宽有关,部分服务商对从库内网流量不单独计费,整体成本会低一截。