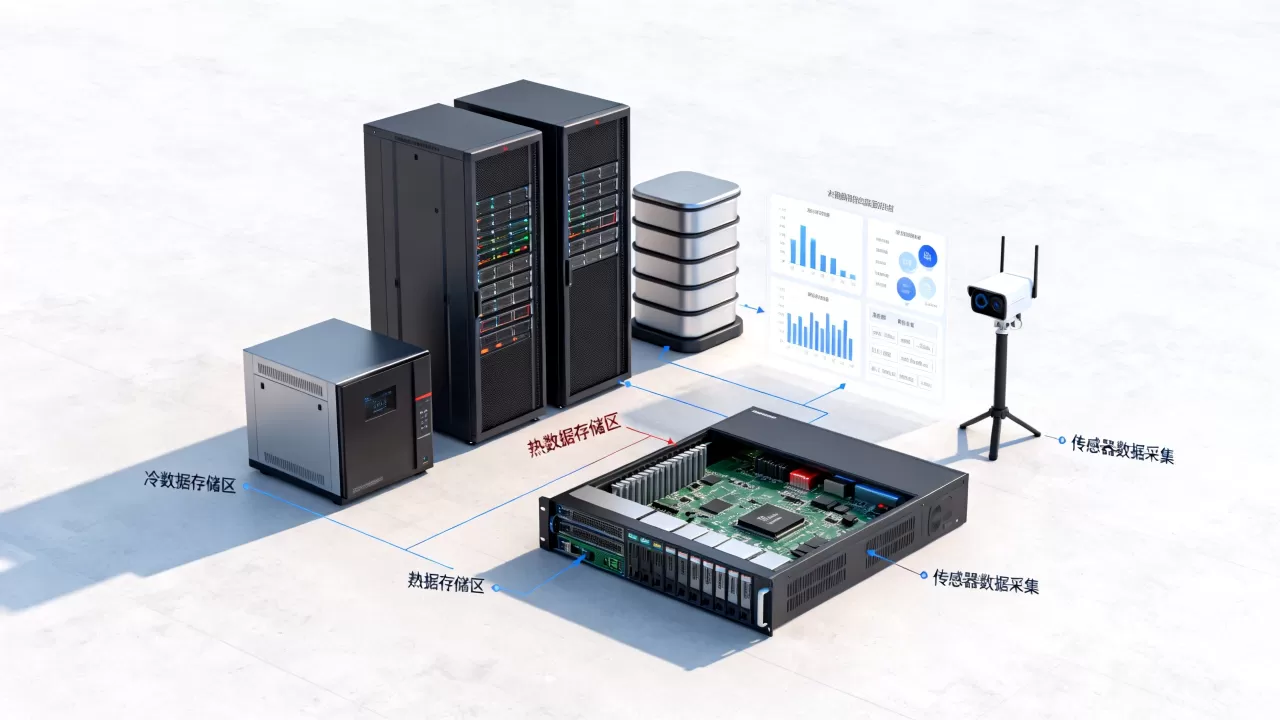
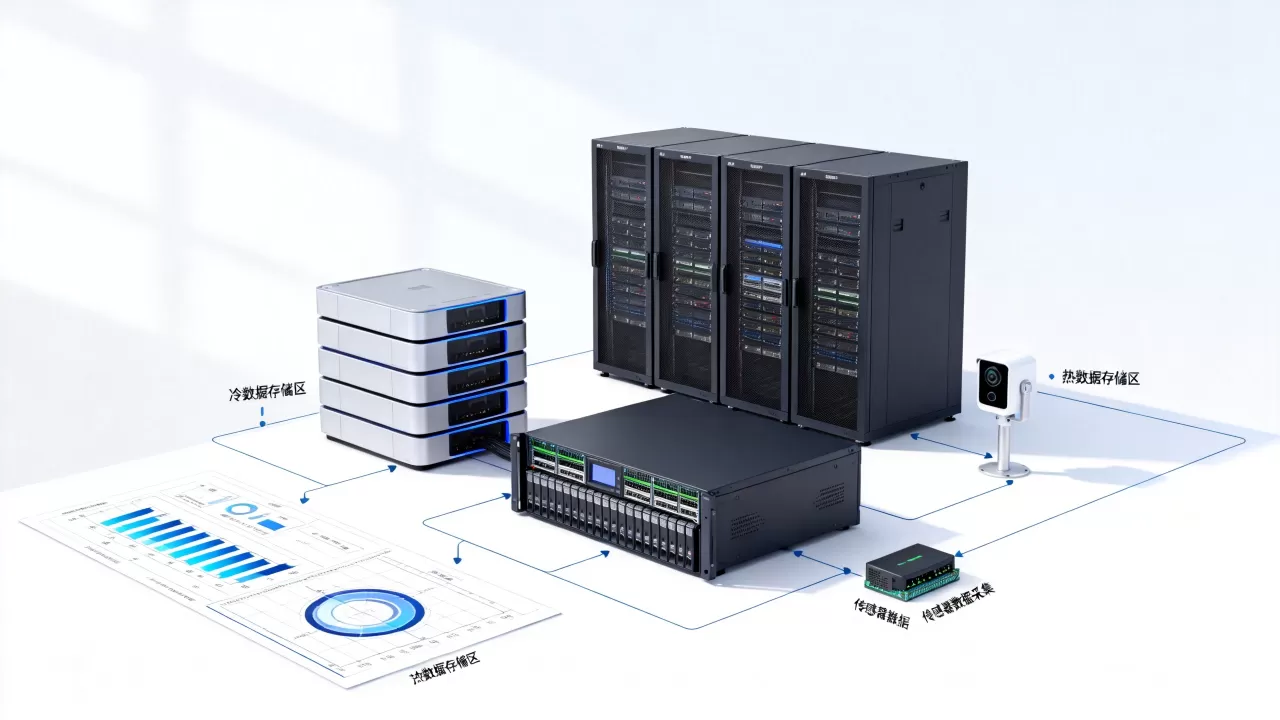
海量传感器时序数据冷热分层存储的核心思路,就是把最近写入、频繁查询的热数据留在SSD或内存里,把历史久、访问少的冷数据迁移到HDD、对象存储或归档层,用分层策略平衡查询性能与存储成本。
为什么传感器时序数据必须走冷热分层
近年来,物联网设备数量持续增加,海量传感器时序数据的存储压力越来越明显,工厂里几万个测点,每秒产生一条记录,一天下来就是数十亿条,这些数据写入后的头几天最受宠,监控告警、实时大屏、故障排查都盯着最近几小时,但过了几天,历史数据就像被塞进抽屉的旧报表,偶尔审计、月度分析才会翻出来。
如果让全部数据都住 SSD 和内存,成本会高到没法规模化,如果全部塞进便宜的机械盘或对象存储,实时查询又慢得让人抓狂,冷热分层就是给数据按温度分配住处。
- 热数据:最近写入,查询频繁,适合放在 NVMe SSD 或内存表。
- 冷数据:写入超过阈值,查询低频,适合放在 HDD、对象存储或归档文件。
传感器时序数据冷热分层存储方案:先理清三个核心问题
数据什么时候算冷?
没有统一标准,要看业务访问习惯,多数情况下,传感器数据在写入后 24 小时内访问最集中,之后热度快速下降,可以按三个维度判断:
- 按时间:写入超过 7 天或 30 天未参与实时查询。
- 按查询模式:只用于日报、月报、年度审计,不再参与实时告警。
- 按聚合度:原始高频数据被降采样后,原始明细数据通常可以视为冷数据。
冷数据迁到哪里去?
几种常见介质各有适用场景:
- 对象存储:MinIO、S3 兼容存储,适合长期归档,成本低,但查询延迟较高。
- 列式压缩文件:Parquet 或 CSV.gz,适合离线分析,用 Spark、DuckDB 直接读取。
- 分布式文件系统:HDFS,适合已有大数据平台的企业。
- 数据库内部冷热分层:TDengine、InfluxDB 企业版等支持自动分层,少写迁移脚本。
迁移过程怎么保证不丢数据?
核心原则是先复制后删除,加校验,操作路径可以这样走:
- 按时间分区导出数据,例如按天生成目录。
- 复制到对象存储或归档盘。
- 对文件做 MD5 或记录行数校验。
- 校验通过后再从热层删除。
- 保留元数据索引,方便后续按设备 ID 和时间范围查询。
物联网时序数据冷热存储怎么做?先看数据访问特征
第一步:摸清访问热度曲线
用数据库慢查询日志或监控系统统计查询频率按天分布,行业共识认为,传感器数据在写入后 24 小时内的访问热度会快速下降,之后趋于平缓,不要凭感觉定阈值,先看真实日志。
第二步:设定冷热分界与降采样策略
一个典型的工业传感器冷热策略可以这样设计:
- 0-7 天:原始数据保留在热层,支持任意精度查询。
- 8-90 天:降采样到 1 分钟粒度,占用的空间大幅减少。
- 90 天以上:只保留 1 小时粒度聚合,每测点每天只有几十条记录。
这种策略下,历史趋势分析不丢大方向,存储量却能压到原来的十分之一以下。
第三步:配置数据库的保留策略与分层规则
以 InfluxDB 为例,可以创建两个保留策略:
CREATE RETENTION POLICY "rp_hot" ON "sensor_data" DURATION 7d REPLICATION 1
CREATE RETENTION POLICY "rp_cold" ON "sensor_data" DURATION 365d REPLICATION 1
配合定时任务,将超过 7 天的数据导出为 Parquet 文件上传到对象存储,TDengine 用户则可以直接在建库时指定存储介质,利用数据库自带的冷热分层功能,把 SSD 和 HDD 组合起来。
海量传感器数据存储架构对比:冷热分层为什么比全热存储更划算
把三种常见架构放在一起看:
| 架构 | 查询性能 | 存储成本 | 运维复杂度 |
|---|---|---|---|
| 全热存储 | 最好 | 最高 | 低 |
| 全冷存储 | 差 | 最低 | 高(查询需解冻) |
| 冷热分层 | 热数据好,冷数据可接受 | 中等偏下 | 中 |
全热存储等于让所有数据都住五星级酒店,大部分房间长期空置,全冷存储则是把档案室当办公室用,找一份文件费半天劲,冷热分层让活跃数据享受高速通道,让沉睡数据住经济舱,整体体验和成本平衡。
时序数据库冷热数据分离价格:成本账怎么算
这一节看看钱的问题,存储成本主要由三块构成:
- 存储介质单价:NVMe SSD 每 TB 价格远高于 HDD,对象存储按 GB/月计费,长期归档通常比在线盘便宜一个数量级。
- 服务器硬件投入:热层需要大内存和高性能盘,冷层可以用普通服务器或直接买云对象存储。
- 运维人力:自建归档脚本需要维护,数据库内置分层能省人力。
工业传感器数据存储成本优化的关键,在于把访问集中在少数近期数据上的特点用到极致,可以通过以下三个动作实现。
工业传感器数据存储成本优化的三个落地动作
- 用列式压缩,Parquet 配合 Zstandard 或 Snappy 压缩,时序数据压缩率相当可观,尤其适合按设备、按时间列存储。
- 按时间分区并设置保留策略,每天一个分区,过期自动删除原始数据,只保留降采样结果。
- 把归档数据写入对象存储并启用生命周期规则,30 天后自动从标准存储转为低频存储,180 天后转为归档存储。
冷热分层的三个常见误区
阈值拍脑袋定
直接把冷热分界设为 30 天,不管业务查询习惯,结果要么热数据被过早归档导致查询慢,要么冷数据霸占 SSD 浪费钱,正确做法是先看访问日志再定阈值,业内专家指出,冷热分层的成败关键在于阈值设定是否贴合业务查询习惯。
只迁移不降采样
原始数据原封不动搬到对象存储,体积没变,成本降幅有限,降采样能极大压缩历史数据,尤其对振动、电流等高频采集信号。
迁移后不可查询
有些团队把冷数据导出成私有格式,后来发现想查历史趋势时根本读不出来,归档格式要选通用标准,Parquet、CSV,或者保留一层轻量索引。
冷热分层不是把旧数据一删了之,而是让数据在不同温度下各得其所,抓住访问热度曲线、设定合理阈值、选对迁移介质,海量传感器时序数据也能用低成本长期保存。
Q&A
传感器时序数据冷热分层存储方案适合哪些场景?
适合设备量大、采集频率高、历史数据需要长期留存但访问低频的场景,比如工业设备状态监测、车载终端轨迹、环境监测站、智能表计抄表等,如果数据量不大或者历史查询频繁,冷热分层的收益会打折。
物联网时序数据冷热存储怎么做才能不丢数据?
先复制后删除,复制后校验文件完整性,保留元数据索引,迁移任务要支持断点续传和失败重试,对象存储的版本控制和生命周期规则也能提供额外保护。
时序数据库冷热数据分离价格大概多少?
价格由存储介质、数据量和访问频率决定,云对象存储按 GB/月计费,长期归档单价最低,SSD 在线盘最贵,HDD 介于两者之间,多数情况下,冷热分层能把整体存储成本压到全热存储的几分之一,具体数值因压缩率和查询负载而异。