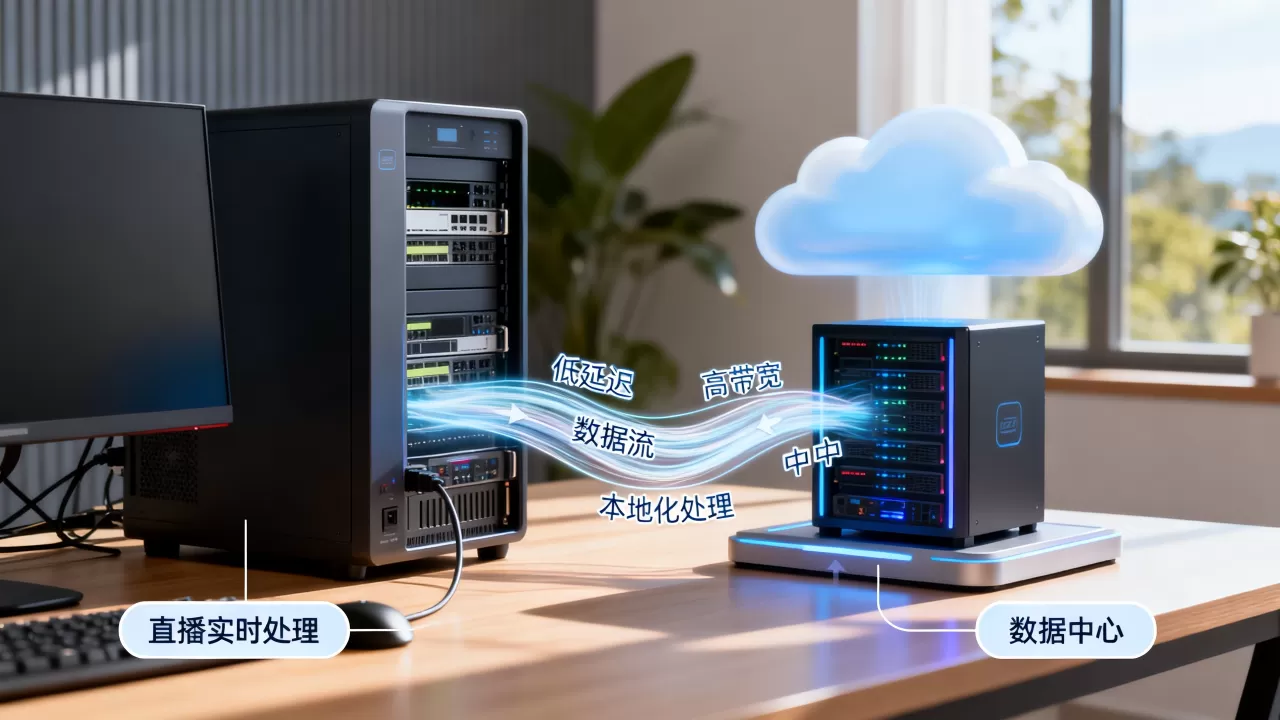
边缘算力在直播实时处理里的位置,一句话说完:它站在推流端和中心云之间,把转码、合流、截图、审核这些要命急活就近干完,云只负责存储和大规模分发。
边缘计算和云计算在直播中哪个好:先看谁在抢毫秒
很多人纠结边缘计算和云计算在直播中哪个好,其实直播实时处理里两者不是二选一,云计算适合离线、重度、全局任务;边缘算力适合延迟敏感、带宽占用高的即时处理,拿一场万人演唱会直播举例,如果所有视频流都先回中心云做转码再分发,物理距离会直接吃掉几百毫秒到数秒,边缘节点部署在离现场几公里或十几公里的机房,推流先到边缘,转码后一路回源,一路直接下行给附近观众。
| 处理位置 | 典型延迟 | 适合任务 | 成本形态 |
|---|---|---|---|
| 中心云 | 数百毫秒到数秒 | 存储、全量分析、回放 | 按量计费,弹性高 |
| 边缘节点 | 数十毫秒到数百毫秒 | 实时转码、合流、审核、弱网优化 | 硬件加带宽组合,区域性强 |
这个表格说明边缘算力不负责替代云,而是卡住“实时”这两个字。
为什么直播实时处理不能把所有活都扔给云
直播视频码率一路就是几兆比特,上百路同时回源,出口带宽压力相当大,边缘算力把最耗带宽的原始流转成适配码率,再往中心云只需要一条低码率源流,物理距离带来的往返时间也叫RTT,光纤再快也追不回跨省那几十毫秒,互动直播里这几十毫秒就是观众能不能跟主播接上话的分界线。
直播实时处理为什么要靠边缘算力
核心原因不是云不够强,是光速和带宽成本摆在那里,直播实时处理有三件事最吃资源:转码、合流、弱网对抗,这三件事都有一个共同点:离推流端越近,效果越稳,边缘算力正好卡在这个物理位置上。
户外直播画面卡顿怎么解决边缘计算是绕不开的答案
户外直播画面卡顿怎么解决边缘计算能直接给方案,主播用4G/5G上行,基站拥塞、信号波动都常见,如果把流推到远端中心云,弱网环境下丢包重传会雪上加霜,边缘节点部署在运营商本地机房或者附近的CDN节点,网络路径短,重传快,在推流端启用SRT协议,配合边缘节点做接收和纠错,卡顿率会明显下降。
实操路径:
- 推流端OBS输出SRT到边缘节点IP,端口比如9000
- 边缘节点运行SRS,监听SRT并转封装为RTMP
- 边缘节点执行动态码率调整,弱网时自动降档
- 稳定后边缘节点再转推到云源站
这个链路里边缘节点不是可选项,是弱网对抗的第一道关。
边缘算力节点部署在哪里才不拖后腿
边缘算力节点部署在哪里,直接决定延迟和稳定性,不是随便放一台服务器就叫边缘,优先位置:
- 一二线城市的运营商核心机房或汇聚机房
- 大型CDN厂商的省级边缘节点
- 活动现场、体育场馆、园区的本地机房
- 有5G MEC能力的基站侧
- 离主播群体集中的城市直线距离50公里以内的节点
判断方法很简单:从推流端ping边缘节点,延迟超过30毫秒基本不算合格边缘;traceroute跳数超过8跳说明路由绕路,给直播团队一个实操标准:先在目标城市租一台轻量云主机做测试,ping和traceroute都达标,再上正式边缘服务。
边缘算力服务器多少钱一台:成本账要换个算法
边缘算力服务器多少钱一台,这个问题的答案没法一口价,边缘服务器有x86小机架式、ARM盒子、带GPU的转码盒子,价格从几千元到几万元不等,租用方式更主流,按节点带宽和算力计费,单节点月成本常见从几百元到几千元,采购和租用对比:
| 方式 | 前期投入 | 适合场景 | 灵活性 |
|---|---|---|---|
| 自购服务器托管 | 较高 | 固定直播间、长期项目 | 中 |
| 租用边缘计算节点 | 低 | 多城市临时活动 | 高 |
| 用CDN边缘计算服务 | 低 | 无需运维、快速上线 | 高 |
小规模直播团队建议先租用,不要一上来买机器,一个城市一个节点,跑通SRT转码链路后再决定是否扩大,部分云厂商的边缘节点有按量计费,测试成本能压到很低。
实操:把边缘算力接进直播实时处理链路
这里给一套可落地的边缘转码节点配置步骤,适合有基础运维能力的团队。
- 准备一台靠近主播的Linux服务器,安装Docker
- 拉取SRS镜像:
docker run -d -p 1935:1935 -p 1985:1985 -p 9000:9000/udp ossrs/srs:5
- 进入容器配置SRT监听和RTMP转发
- 推流端使用OBS,输出模式选自定义,容器地址写:
srt://边缘IP:9000?streamid=#!::r=live/livestream,m=publish
- 边缘节点收到SRT流后,执行FFmpeg转码命令,示例:
ffmpeg -re -i rtmp://127.0.0.1/live/livestream -c:v libx264 -preset veryfast -b:v 2000k -c:a aac -f flv rtmp://源站地址/live/out
- 同时可以在边缘节点加一条截图命令,每2秒截一帧用于内容审核
- 最后把源站地址设为云直播服务提供的RTMP推流地址
这套链路适合多机位轻量化直播,延迟能压到比直接推云低一截,命令参数按实际网络和码率调整,不用照抄。
直播实时处理延迟多少毫秒正常:边缘算力给的是底气
直播实时处理延迟多少毫秒正常,行业里通常这样看:普通秀场和带货直播,端到端3到5秒多数观众无感;连麦、竞拍、答题类互动直播,要求压到1秒以内;使用WebRTC配合边缘节点,端到端300到800毫秒是常见范围,边缘算力的价值不是让所有直播都变成零延迟,是把不稳定变成可控,主播在户外推流,边缘节点做一层缓冲和纠错,观众端不会频繁转圈,这个位置就像直播链路的“前场调度”,云是“后场仓库”。
Q&A:直播边缘算力实时处理相关疑问
边缘算力对直播延迟的影响到底有多大
边缘算力主要压缩的是推流端到处理节点、处理节点到源站这两段网络耗时,如果主播和观众都在同一个城市边缘节点覆盖范围,延迟收益最明显,跨省甚至跨国直播,边缘节点只能改善局部,无法突破物理距离。
边缘算力节点部署在哪里成本最低
成本最低通常不是一线城市核心机房,而是二三线城市运营商机房或CDN区域节点,但成本低不等于效果好,必须先做网络质量测试,在目标城市选择三家以上云厂商的边缘可用区,用mtr命令连续测48小时,观察丢包率和抖动,再决定租用位置。
直播实时处理延迟多少毫秒算正常
泛娱乐直播端到端3到5秒属于正常区间,互动直播低于1秒,超低延迟方案常见300到800毫秒,该范围为行业公开测试常见结果,受运营商网络、推流设备、播放端策略影响,不同场景会有差异,边缘算力的作用是把多数普通场景拉进可接受范围,而不是承诺一个绝对数字。
边缘算力在直播实时处理里的位置,就是那个让“实时”二字落地的物理支点,没有它,中心云再强,也追不回光纤里损耗的每一毫秒。