把回放任务拆成“可等待”和“不可等待”两类,用优先级权重配合并发上限动态调度,而不是让所有任务挤在同一条流水线上。
很多人遇到直播回放生成慢,第一反应是加服务器,但多数情况下瓶颈出在队列策略上,转码队列不是越宽越好,也不是越深越稳,它需要一套能自己消化高峰的规则。
直播回放转码队列排队太久怎么办:先看机器再看队列
当你发现回放迟迟不出现,用户已经开始在评论区追问时,先别急着翻代码,按照下面顺序排查,能省下不少时间。
第一步:确认是卡在“排队”还是“转码中”
在任务列表里,这两个状态的处理方式完全不同,如果任务状态长期是“等待中”,说明队列调度出了问题;如果是“转码中”但进度条不动,那才是机器性能或编码器卡死。
第二步:检查队列里的健康心跳
行业共识认为,超过10秒没有心跳的转码worker应该被自动摘除,很多直播平台的转码服务用的是FFmpeg类的底层工具,它本身不报错,但进程已经僵死,你需要在worker里加一个探活接口,每5秒上报一次当前任务ID和进度,调度器发现两次心跳间隔超过阈值就主动kill掉进程,把任务重新放回队列。
第三步:清理“僵尸任务”和“孤儿任务”
直播结束瞬间产生的回放任务最容易出问题,主播断流时推流端可能没有正确发送结束标识,导致服务端还在等流,回放任务一直挂着,这类任务占着队列资源不干活,比真在转码的任务更讨厌,建议加一条规则:任务创建超过15分钟还没有进入转码中的,直接标记为失败并通知上游重新拉流。
直播回放生成卡在转码中是什么原因:调度策略和并发上限
排除了机器问题后,多数卡顿其实源于调度策略太简单,很多平台用的是先来先服务队列,这在小规模时没问题,一旦碰上直播高峰,回放任务会在队列里越积越多。
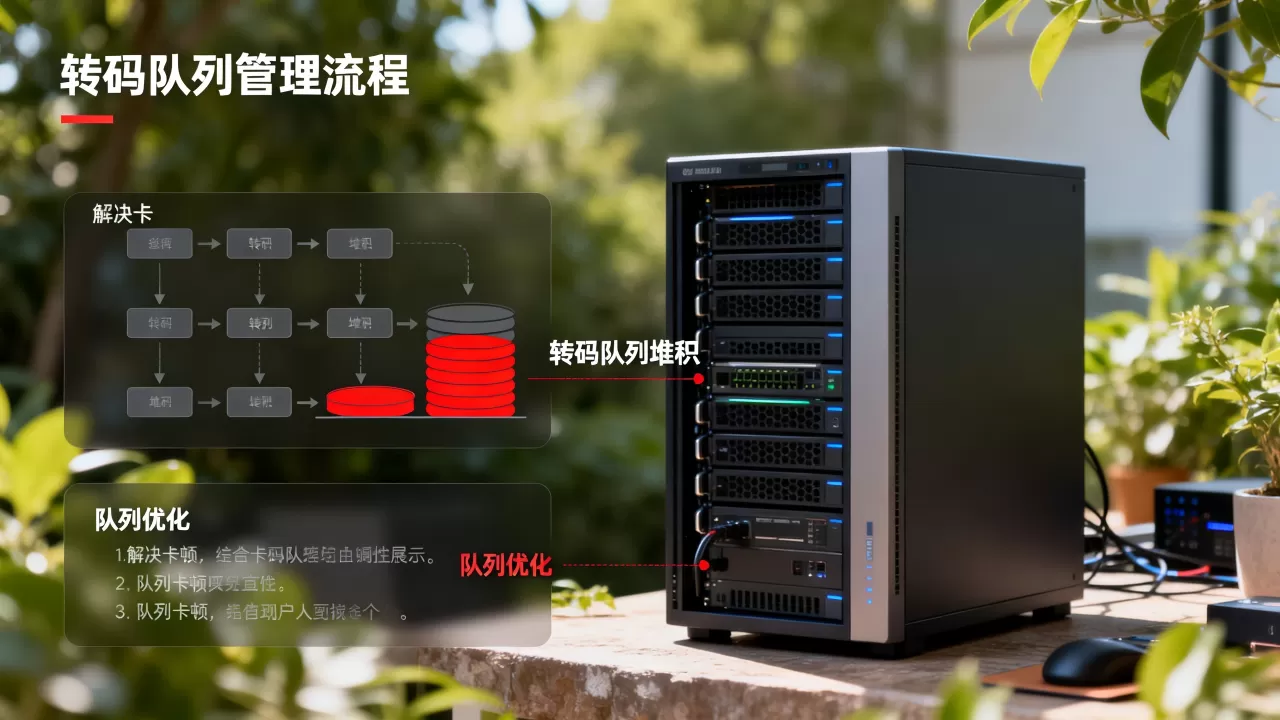
小队列的“堵车效应”
想象一下早高峰的单车道,所有车挤在一起谁也别想走,转码队列也是同理,如果当前有100个回放任务在排队,每个任务平均转码3分钟,最后一个任务要等5个小时才能开始,这个等待时长对用户来说完全不可接受。
解决思路:分优先级队列
不要用一个队列装所有任务,而是拆成三个:
- 高优先级:付费用户的回放、平台头部主播的回放、即将过期的事件性内容
- 中优先级:普通创作者的直播回放
- 低优先级:超过24小时前的直播回放、正在审核中的内容
每个队列分配不同的worker数量,高优先级队列确保有常驻worker,低优先级队列用空闲资源跑,这样即使高峰期积压了大量回放任务,头部内容的生成速度也不会被拖垮。
并发上限不是越高越好
有些团队会把并发数直接拉到物理机的CPU核心数,结果转码时和直播推流抢资源,导致画面卡顿,业内专家指出,转码线程数应该控制在物理核数的70%-80%,留下余量给直播链路本身,如果是复用机器,这个比例还要更低。
直播转码队列优先级怎么设置:回放给直播让路
直播回放的转码是低优先级后台任务,这一点要体现在调度器的代码逻辑里。
动态优先级调整的实际操作
每次直播开播时,触发一个“降级”事件,把当前队列中所有回放任务的优先级整体下调一级,直播推流需要的带宽和CPU是刚性的,不能让回放在旁边挤占资源。
用伪代码表示:
if 新直播流开始:
    所有正在转码的回放任务 pause 或 rate_control
    回放任务优先级 += 1(数字越大优先级越低)
释放 30% worker 给直播通道这里的pause不是真的终止,而是降低转码的帧率处理速度,FFmpeg里可以设置-re参数配合限速,让回放任务慢点跑,但不要杀掉,否则重新开始的成本更高。
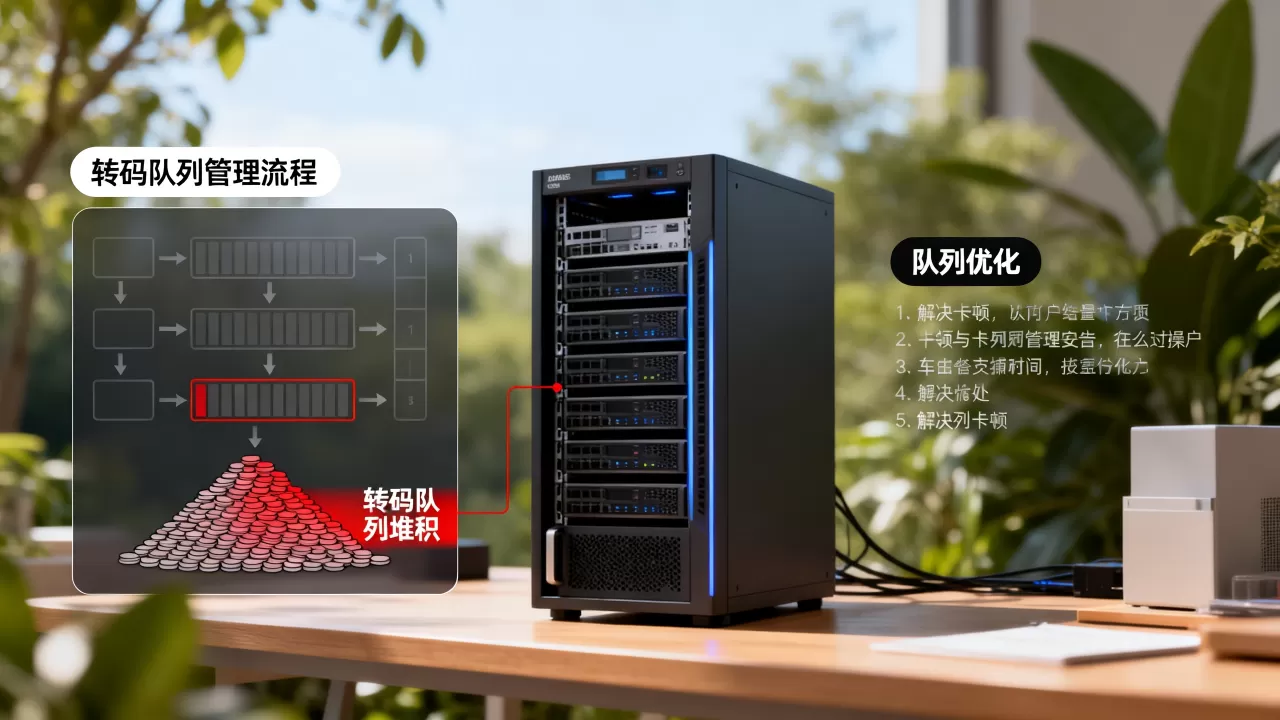
时间窗口错峰
对于可以预知的直播高峰,比如大型赛事、电商大促,提前在后台配置“回放任务禁止时段”,是这个时段内新产生的回放任务不进入队列,而是直接落盘等待,高峰过去后再统一调度,这样做的代价是回放生成时间变长,但换来了直播体验的稳定。
队列里的任务什么时候该手动干预:三个需要留意的信号
自动调度不是万能的,有些情况需要人工介入。
低优先级队列积压超过阈值
如果低优先级任务积压超过500个,或者预估等待时间超过4小时,说明系统进入了恶性循环,这时候手动把积压任务的前50个提升到中优先级,优先处理最早的那批,让队列“走出”堵塞状态。
转码失败率达异常
正常情况下转码失败率在个位数以内,如果某一段时间失败率突然升高,先别急着重试,很可能是源视频文件本身有问题比如直播录制时丢包严重,导致时间戳断裂,此时手动抽查几个失败任务的日志,如果是同一类错误(比如非零退出码、找不到关键帧),先修复源头。
高优先级队列被低优先级任务插队
检查调度器是不是被“蹭”了,有些运营同学会手动把普通用户的任务标记为高优先级,时间久了高优先级队列就名存实亡,设定一个限制:手动提升优先级的操作每天最多3次,且必须走审批,防止人为因素破坏队列生态。
转码队列管理的三个日常动作
这几件事建议每周做一次,能有效避免回放生成卡顿。
监控队列里各状态任务的时长分布
把队列里所有任务按“已等待时间”分桶,看看是不是有超过1小时还没开跑的,用脚本定期扫描:
curl -s http://your-transcode-server:8080/api/queue | jq '.tasks[] | select(.status=="waiting") | .wait_time'
如果切到等待时间超过30分钟的任务,直接降级或取消,别让用户在页面傻等。
抓取回放任务的开始/结束事件
每次转码任务从“排队”进入“转码中”时,记一条耗时日志,每天看看这个指标的均值,如果均值在缓慢上升,说明队列压力在增大,需要提前扩容或调整并发。
定期测试“队列弹性”
每周挑一个低峰时段(比如凌晨3点),手动把并发上限调低到正常值的50%,再把一批测试任务扔进队列,看看调度器是否会自动排队,恢复后是否能平滑消化积压,这能验证你的调度逻辑没有写死。
Q&A:直播回放转码队列管理常见问题
转码队列一直堆积,从哪几个维度排查?
依次查三处:机器负载是否跑满、任务是否存在无心跳的死进程、高优先级任务是否过多挤占了低优先级资源,建议使用一个可视化面板展示队列堆积量、平均转码耗时、worker空闲率三个指标,多数情况下,堆积是由于死进程占坑和优先级策略失效,而不是真正的算力不足。
回放转码和直播转码能不能用同一个队列?
不能,强烈建议物理隔离,直播转码是实时数据流,延迟单位是秒级;回放转码是离线文件处理,延迟单位是分钟级,把两者放在同一个队列里,回放任务会持续影响直播流的按时转出,如果机器资源紧张,也需要在逻辑上分成两个独立调度器,用不同的worker池。
定价或成本控制方面对队列管理有什么影响?
转码本身有算力成本,队列管理直接关系到成本,如果并发开得过大,高峰期的峰值算力租用费用会明显上升;但并发太小又会造成回放严重延迟,比较务实的做法是设置“动态缩容”:低峰期把worker数量降到最低,高峰期提前30分钟扩容,并根据历史上最长的队列等待时间设置一个合理的上限阈值,当预估等待时间超过该阈值时再触发扩容操作,而不是一有积压就加机器。