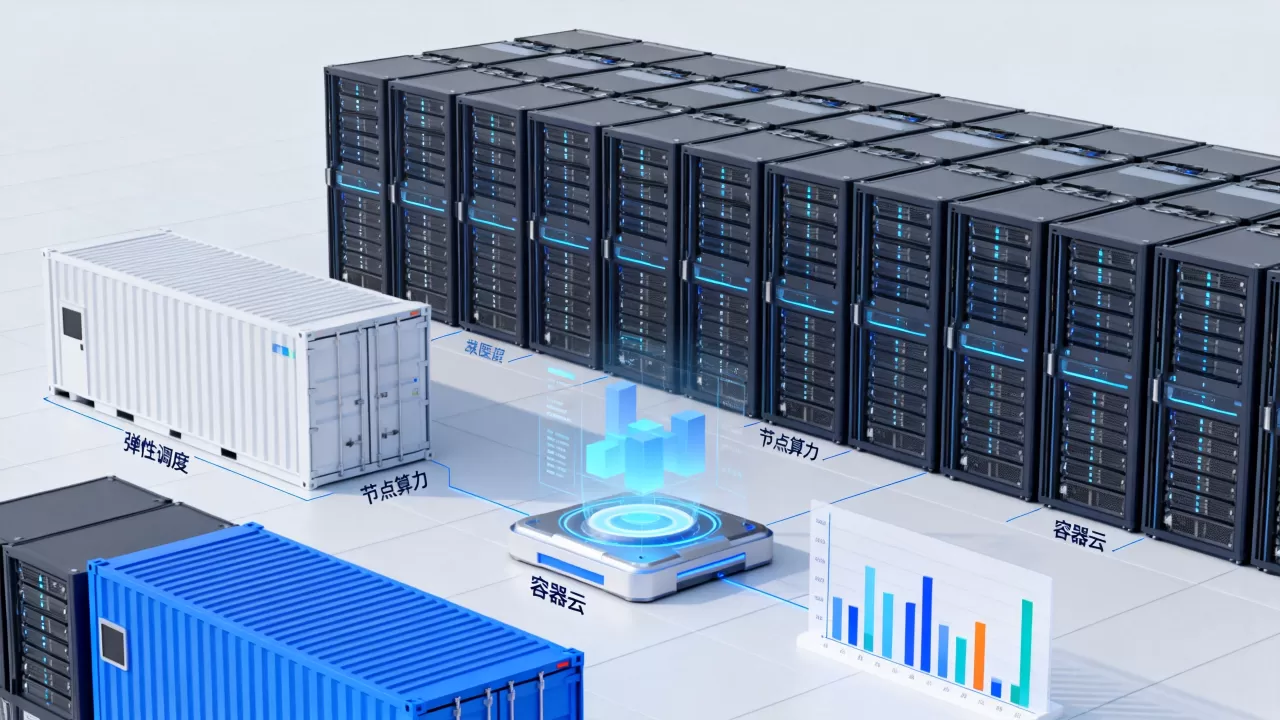
医院容器平台对节点算力的弹性调度,核心逻辑就一句话:让算力像水电一样,按需自动接入或退出,业务高峰时节点自动扩容扛住压力,低谷时缩容省钱省资源。这套机制今天已经不只是互联网公司的专利,越来越多的医院信息科在紧锣密鼓落地容器云平台,目的只有一个别让挂号高峰期把系统搞崩。
医院容器平台节点算力不足怎么解决
先认清医院业务流量的真实脾气
医院系统的流量规律跟电商有很大差别,电商是双11、618那种脉冲式爆发,而医院是每天都有固定节奏的潮汐效应,上午8点半到11点半,门诊挂号、收费、电子病历写入同时冲高,下午2点到4点检查报告回传密集,夜间住院医嘱和药房摆药又有一波小高峰。
这种节奏下,如果按峰值配置固定节点,意味着大部分时间服务器在空转,一台高性能物理机一年电费加运维成本不是小数,而医院信息科的预算从来都是精打细算的。容器平台的价值就在于,它不关心你物理机有几台,只关心当前业务需要的Pod有几个。
从节点到Pod的两层弹性逻辑
医院容器平台的弹性调度分为两层,缺一不可:
- Pod层伸缩:HPA(Horizontal Pod Autoscaler)根据CPU、内存或自定义指标自动增减业务副本数。
- 节点层伸缩:cluster-autoscaler根据Pending状态的Pod数量,自动在底层资源池添加或移除Kubernetes节点。
很多医院实施时只做了第一层,结果高峰期Pod加上去了,节点资源不够,新Pod一直卡在Pending状态,等于白忙活。真正有效的弹性调度,必须让两层联动。
具体落地操作路径
假设医院容器平台基于Kubernetes构建,实际操作并不复杂,但有几个关键配置项必须盯死。
# 为关键业务命名空间设置资源配额
kubectl create namespace his-core
kubectl apply -f - <<EOF
apiVersion: v1
kind: ResourceQuota
metadata:
  name: his-core-quota
  namespace: his-core
spec:
  hard:
    requests.cpu: "32"
    requests.memory: "64Gi"
    limits.cpu: "64"
    limits.memory: "128Gi"
EOF
资源配额只是第一步,真正决定调度质量的是节点亲和性和Pod拓扑分布约束。
# 为承载HIS核心库的节点打标签
kubectl label node k8s-node-01 role=his-db=true
部署时指定Pod必须调度到带该标签的节点
spec:
affinity:
nodeAffinity:
requiredDuringSchedulingIgnoredDuringExecution:
nodeSelectorTerms:
- matchExpressions:
- key: role
operator: In
values:
- his-db
行业共识认为,医院容器平台在调度策略上,核心数据库类Pod应该用required规则硬性绑定,而应用类Pod用preferred规则软性引导即可,这样既保证数据层稳定,又给应用层留足弹性空间。
医院容器云平台弹性伸缩配置方案对比
指标选择决定伸缩质量
只盯CPU使用率做伸缩,在传统Web场景够用,但在医院场景容易出问题,原因是医院核心业务,特别是HIS系统的门诊收费和药房发药模块,很多操作是IO密集型的,CPU可能只有30%,但数据库连接池已经快满了。
更合理的做法是混合指标,对外接口层看QPS和响应时间,中间业务层看CPU和内存,数据访问层看活跃连接数和慢查询数。
关键伸缩策略参数参考
| 指标类型 | 适合业务 | 建议阈值 | 冷却时间 |
|---|---|---|---|
| CPU使用率 | 影像归档、报告服务 | 60%-70%触发扩容 | 3分钟 |
| QPS | 门诊挂号、预约服务 | 峰值的70% | 2分钟 |
| 内存使用率 | 缓存服务、前置网关 | 65%-75% | 5分钟 |
| 自定义业务指标 | 排队叫号、药品库存计算 | 实时监控 | 1分钟 |
需要特别注意的是冷却时间,冷却时间设置过短,节点刚扩容完又触发缩容,产生抖动,数据库连接反复创建销毁,反而会把数据库拖垮,业内实际经验值,扩容冷却时间建议2-3分钟,缩容冷却时间建议10-15分钟。
多院区场景下的调度差异
集团型医院往往有总院、分院、社区中心多个物理位置,网络延迟和链路稳定性差异,决定了不能把所有节点混在一个集群里,现在主流的做法是分院自治加总院统一管控:每个院区独立管理本地节点,总院通过联邦调度能力在紧急时刻跨院区借用算力。
遇到突发公共卫生事件,总院可以把体检中心的空闲节点临时调度给发热门诊的影像系统用,这种跨院区节点调度,在传统虚拟化架构下需要人工协调,而容器平台只需在总控台点几下,
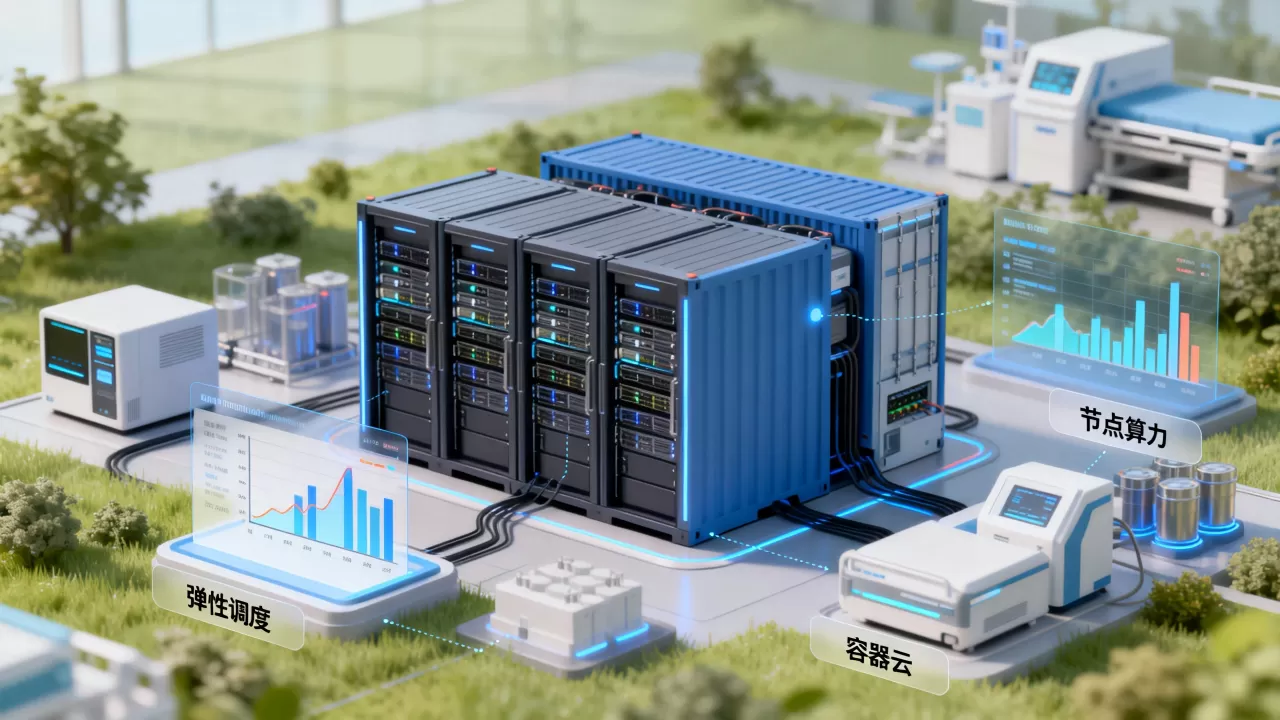
策略下发到各院区集群通常不超过1分钟。
医院容器平台选型时如何评估调度能力
医院信息科在做容器平台选型时,往往被厂商的PPT绕晕,评价节点弹性调度能力,重点看三点就够。
调度延迟实测
让厂商现场演示:模拟一次200个Pod同时创建,从节点加入到PodRunning状态,耗时多少。能控制在3分钟以内的算及格,2分钟以内算优秀,有些厂商用预置镜像缓存和节点模板来加速,这是正当手段,但你要问清楚缓存更新机制,免得新版本镜像发布后首次调度反而变慢。
调度策略的精细化程度
能按命名空间设置调度策略是基本能力,关键看能不能做到Pod粒度的精细化控制,比如同一套HIS系统,住院医生站和门诊医生站,一个要优先保障在线率,一个可以适当容忍冷启动等待,平台能不能给这两个工作负载设置不同的调度优先级和抢占策略,能做到的厂商基本是真工夫。
底层资源池的兼容水平
医院环境里常常既有物理机也有老旧虚拟化平台,新建容器集群多数跑在物理机上。平台的节点纳管能力决定了弹性的上限,好一点的平台支持异构节点混部,Intel和ARM芯片的机器可以同时纳管,据统计,国内三级医院信息科现有硬件设备中,ARM架构占比逐年提升,如果平台只支持x86,将来扩容会非常被动。
实际操作中的选型测试清单
- 把业务容器镜像分别调到小节点和大节点,观察调度器的均衡策略
- 在业务低峰期人工将某个节点标记为不可用,看工作负载迁移是否平滑
- 连续执行10次伸缩操作,观察是否有资源碎片化问题
- 检查节点故障时,Pod自动重建的时间是否超过业务可容忍的最大中断时间
医院容器平台节点算力调度的日常巡检要点
弹性调度系统上线不等于一劳永逸,医院信息科在运维侧需要建立一套日常巡检机制,才能确保关键时刻调度策略真正起作用。
定期核对伸缩记录
每周拉取一次HPA和cluster-autoscaler的工作日志,重点看是否有频繁伸缩的记录,如果某个工作负载一天之内伸缩超过10次,说明指标阈值设置不合理,或者业务本身存在资源争抢,典型场景是PACS系统的缩略图生成任务,批量任务每轮启动都会抢占CPU,把伸缩阈值带偏。
验证节点池的最小存活节点数
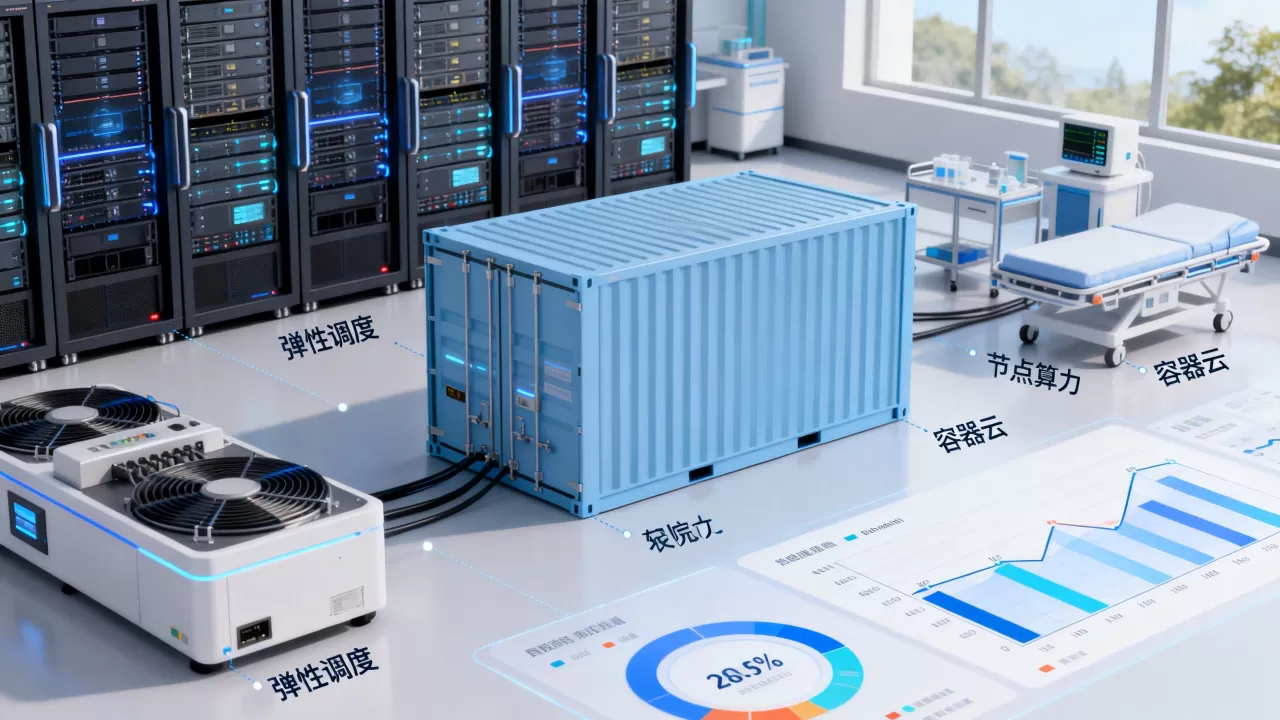
容器平台通常允许设置节点池的最小节点数,有些医院为了省成本把最小节点数调到1,结果某个依赖固定节点标签的Pod因为节点数不够,调度器无从选择。最小节点数建议不低于3,避免单点故障时弹性调度没有缓冲余地。
关注镜像拉取对扩容速度的影响
节点扩容最大的时间消耗往往不是节点启动,而是镜像拉取,医院内网带宽通常有限,一个HIS应用镜像动辄2GB,新节点从加入集群到第一个Pod就绪,镜像拉取可能占了一半时间,实操中的有效解决方式是平台侧开启镜像预推送和跨节点分层复用,每次业务发布后,立即把新镜像推送到各个节点池的缓存中,而不是等扩容时现场拉取。
Q&A
医院容器平台弹性调度能节省多少硬件成本
这个没有统一数字,跟医院原有资源利用率强相关,多数情况下,传统的医院虚拟化环境平均资源利用率只有10%-20%,而容器平台加上弹性调度后,可以把日常资源利用率拉高到40%以上,高峰时段通过临时扩充承担流量,对一家中等规模的三级医院来说,固定节点数量减少意味着未来三到五年的硬件采购预算可以延缓,释放的机房空间和电力成本同样可观。
容器平台的调度策略会不会和现有虚拟化平台冲突
很多医院目前是虚拟化和容器共存的过渡阶段,实际做法是新建容器集群跑新增业务系统,存量系统继续在虚拟机上运行,通过服务网格进行互通,等容器平台的稳定性和团队运维水平经过验证后,再分批将重点业务迁移上容器,这种双轨制运行模式下,容器平台的调度策略只对其纳管的物理节点生效,不影响虚拟化平台的资源分配,只要在前期规划中预留好IP地址段和存储LUN的映射关系,冲突基本可以避免。
弹性调度在突发公共卫生事件中如何快速响应
医疗资源在突发公共卫生事件中的算力峰值不可预测,但节点资源的弹性调度可以缩短响应周期,以大型核酸检验批量结果上传为例,区域内短时间内集中写库,常规节点数量下数据库连接池很快被打满,容器平台提前配置好HPA策略,监听特定业务接口的排队长度指标,当指标超过阈值后自动扩容Worker节点,整个过程无需人工干预。从触发条件到新节点承载业务,理想状态下可压制在5分钟以内,这个速度是传统采购服务器动辄数周的项目周期无法比拟的。