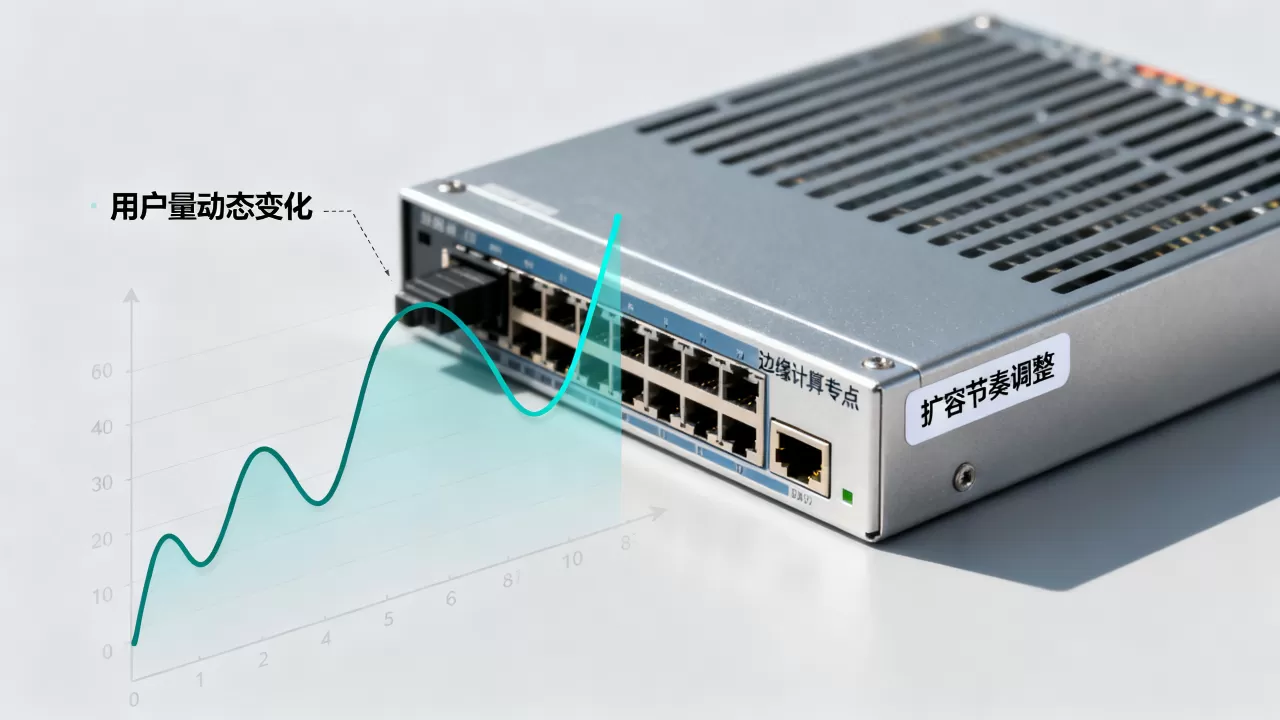
边缘节点的扩容节奏应该跟随接入用户量动态变化,提前盲堆资源是浪费,等故障再补救是被动。这是边缘计算架构里最常见的一道分水岭:运营团队是看着曲线做事,还是拍着脑袋做事,本文从扩容方案、故障应急、节点对比到成本控制,拆解一套可落地的动态扩容节奏。
边缘节点扩容方案:如何跟随用户量动态调整
边缘节点不像中心机房那样可以提前几个月做资源规划,它的生命周期由终端用户的活跃度决定,某个地区突然涌入大量用户,节点压力随之抬升,扩容就得跟上;用户退潮后,资源又可以回收到其他热点区域。
先看关键指标,再谈扩容动作
想判断扩容时机,不能等监控告警响起来才动手,日常运营中,建议重点盯住三个信号:
- 用户接入量的实时曲线:这是最直接的驱动因素,按小时粒度观察趋势,区分工作日和周末的不同峰值
- 节点负载的基线水位:CPU、内存、带宽使用率长期超过70%的节点,已经进入预警区间,不建议等到85%以上再做预案
- 请求响应时间的波动幅度:响应时间突然翻倍,往往先于容量瓶颈出现,是一个隐藏信号
行业共识认为,把三个指标放进同一个看板里观察,比单看任何一个都靠谱,边缘节点的扩容不是简单的"加机器",而是对应着具体的接入流量。
设定三级触发阈值
给节点定义清晰的三级水位线,扩容时就不会纠结:
| 水位等级 | 触发条件 | 建议动作 |
|---|---|---|
| 黄色关注 | 带宽使用率连续30分钟超65% | 预置容器镜像、拉起备用节点待命 |
| 橙色预警 | 用户接入量环比增长40%以上 | 弹性扩容节点至需求量的120% |
| 红色告警 | 响应时间翻倍或超时率抬升 | 立即切流至邻近节点,同步重启扩容流程 |
实际操作中,很多团队把阈值设置成固定值,这在流量平稳时够用,但遇到突发热点就很被动,更好用的做法是结合历史趋势做动态基线,比如同比上周同时段的数据,超过均值一定比例再触发扩容,用户活跃度爬坡的阶段,扩容节奏应该快半拍,给资源预热留出时间。
边缘节点不够用怎么办:从预警到扩容的完整路径
不少运营同事问过同一个问题:
边缘节点不够用怎么办?最常见的处理方式是临时加带宽,但这只是缓兵之计,节点资源不足本质上是一个容量管理问题,得走完整的处理路径。
第一步:快速定位瓶颈层
节点不够用通常表现为三种形态:
- 计算资源耗尽,表现为CPU长期满载,并发处理能力下降
- 存储容量打满,缓存命中率跌到90%以下,回源请求大幅增加
- 网络带宽饱和,用户端感知到视频加载变慢或文件下载速率下降
先用监控面板确认瓶颈落在哪一层,再针对性地扩容,计算资源不够就增加Pod副本数;存储满了就挂载新的云盘;带宽顶不住则升级带宽套餐或启用多线BGP,不要一上来就整节点替换,那样既费时间又容易引入新的不稳定因素。
第二步:用弹性伸缩规则代替人工盯盘
边缘节点的资源池通常托管在边缘云平台上,可以配置自动伸缩策略,具体的操作路径如下:
- 在边缘云控制台找到"弹性伸缩"模块,创建伸缩组
- 设置最小实例数(通常为日常需求峰值的80%)和最大实例数(预计业务增长的上限)
- 绑定已经定义好的监控指标,比如CPU使用率超70%持续5分钟就触发扩容
- 设定冷却时间,避免指标抖动导致频繁扩缩容,一般建议冷却10-15分钟
需要手工介入的场景其实很少,除非是大型活动前预知流量高峰,可以提前扩容,比如直播大促或新品发布会,提前4到6小时把节点拉起来,让链路预热到稳定状态。
第三步:热数据提前下沉
不少节点扩容后效果不明显,根因在于热门内容还在中心源站,边缘节点每次请求都要回源拉取,扩容的同时要把高热度内容提前缓存到边缘节点上,这样新增的容量才能真正为用户提供加速效果,日常运营中,可以根据前一天的请求日志,把访问量排名前5%的内容推送到各边缘节点。
边缘节点和中心节点区别:为什么边缘扩容节奏必须更敏感
很多刚接触边缘计算的团队会问,边缘节点和中心节点区别到底在哪里?从扩容角度看,两者的响应速度要求完全不同。
距离决定了敏感度
中心节点服务的是全网用户,资源规模大,流量波动相对平缓,扩容节奏以周或月为单位,边缘节点贴近用户,服务范围可能只是一个城市甚至一个区,某个区域举办大型演唱会或者突发公共事件,接入用户量可能在一个小时内翻倍,扩容窗口只有分钟级。
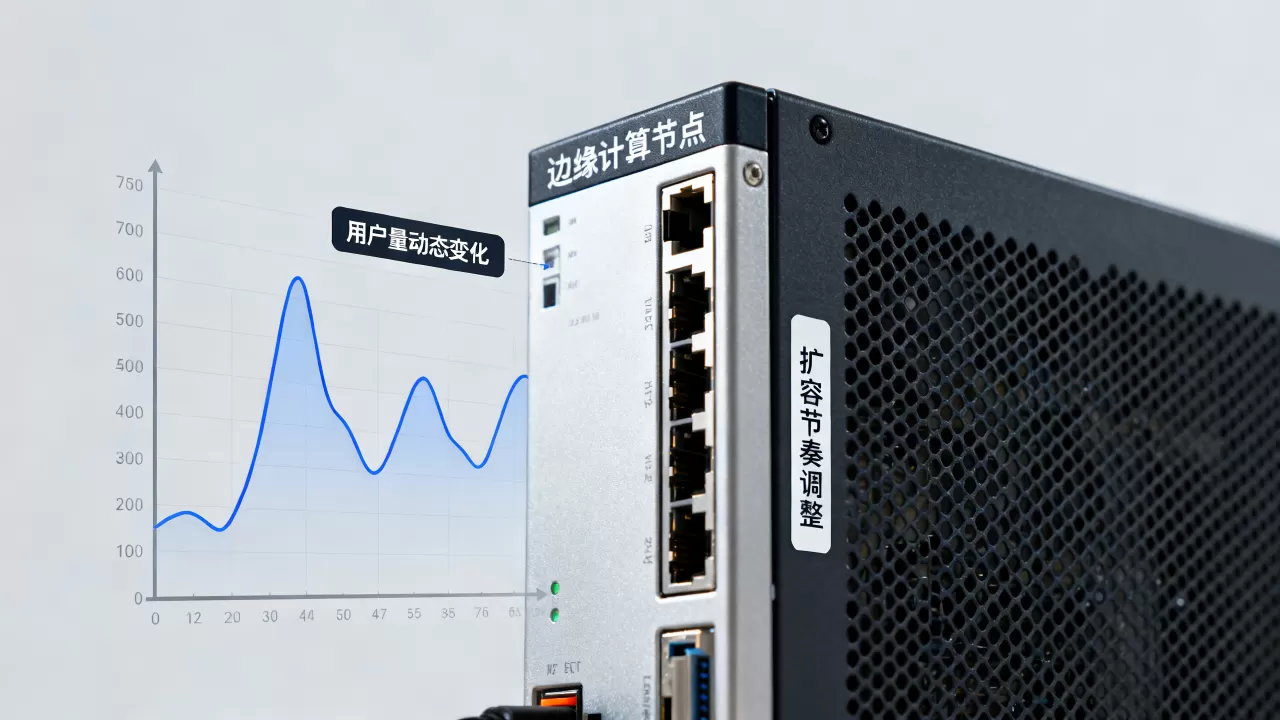
这就像城市供水系统:中心水厂可以按季度计划扩建,但小区二次供水的水泵,突发用水高峰时必须在当天就加大功率。
成本结构不同,浪费更可惜
中心节点一般由多台服务器组成集群,临时加几台机器摊薄到整个集群中,成本感知不强,边缘节点数量多、单体规模小,每个节点都保持高冗余就意味着成倍的资源浪费。
行业内的做法是边缘节点按比较低的常驻水位运行,依赖弹性能力吸收脉冲式流量,常驻资源只保留日常峰值的1倍左右,突发流量靠自动扩容承接,如果每个边缘节点都按照最高水位常备资源,整体资源浪费可能达到一半以上,这也是边缘节点部署成本在业内讨论最多的话题之一。
容灾策略也不一样
中心节点出故障,一般靠多可用区冗余切换;边缘节点出故障,流量直接调转到邻近节点或回源,这意味着边缘节点的"扩"不只是扩自己,还包含"冗余空间"的预留,每个边缘节点至少保留20%的冗余容量,用来承接相邻节点故障时溢出的流量,这是边缘容灾的基本底线。
边缘节点部署成本怎么管:动态扩容如何不超预算
边缘节点扩容跟着用户量走,从成本角度也说得通,传统IDC模式要提前买断物理机,资源利用率低了就是浪费;边缘计算场景下,资源是按需开通、按量计费的,扩容节奏和用户量曲线越贴合,成本越低。
分时复用盘活闲时资源
边缘节点的流量有明显的潮汐效应,白天工作时段办公类应用流量高,晚间家庭娱乐类应用流量高,同一个边缘节点上混合部署不同类型的业务,可以实现错峰复用,比如白天跑在线文档和视频会议,晚间把资源让给直播和短视频分发,这种调度思路能在不增加整体资源的前提下,让各个业务的扩容空间都更大一些。
细粒度计费是控制成本的关键
边缘云平台提供按小时甚至按分钟计费的资源,扩容只持续几小时,花费也就是几杯咖啡的钱,但如果扩了容就忘记缩容,多跑一个晚上,账单可能翻倍,建议给每个伸缩组设定自动缩容策略,流量回落后15分钟自动释放多余的实例。
推荐一个实用习惯:每周复盘一次每个节点的扩容记录,把扩容次数最多、持续时间最短的节点标记出来,看看是否存在资源碎片化的问题,很多成本超支都可以在复盘阶段发现。
边缘计算节点怎么选:匹配业务场景才是核心
边缘计算节点怎么选这件事,直接关系到扩容的平滑程度,如果选错了平台或节点位置,后续的扩容节奏再精准,体验也难保证。
- 看节点覆盖范围:尽量选择运营商边缘云或大型云厂商的边缘节点,覆盖的城市越多,用户就近接入的余量就越大
- 看弹性API的成熟度:有些平台支持秒级弹性,从调用API到新节点上线只有几十秒,这决定了你的扩容节奏能赶多快
- 看与中心云的连通性:边缘节点需要频繁和中心云做数据同步,如果专线带宽不够,扩容后回源链路很容易成为新瓶颈
一位长期做视频分发的朋友分享过经验:选边缘节点不要光看节点数量,要看目标用户群所在城市的覆盖密度,如果目标用户集中在三线以下城市,一线城市节点再多也没用,接入延迟依旧居高不下,先分析用户地域分布,再决定引入哪些边缘节点,这条原则比任何选型评测都管用。
边缘节点扩容节奏怎么定
Q:边缘节点扩容节奏怎么定比较稳妥?
A:以用户接入量曲线为基准,按小时粒度动态调整,常规节点保持1倍常驻资源,热点区域预留30%-50%的缓冲余量,扩容触发后观察15分钟,如果负载仍然超过阈值,继续往上叠加,直到负载回落到舒适区。
Q:边缘节点扩容会影响现有业务的稳定性吗?
A:如果只是增加Pod副本或带宽,不会影响,但更换节点规格或迁移数据会产生一定的连接中断风险,推荐在低峰期操作,多数边缘云平台支持热迁移,配合滚动发布策略,可以将影响降到最低,用户侧几乎无感知。
Q:边缘节点扩缩容太频繁会不会有问题?
A:频繁扩缩容会增加调度系统的压力,也容易踩到平台限频,把冷却时间设置成10至15分钟,同时把触发阈值提高一些,可以减少这种无意义的抖动,容量管理的目标是用最小幅度的调整去适配用户量的大部分波动,剩下的少数极端情况靠临时预案兜底。
边缘节点的扩容节奏,本质上就是跟随用户接入量的一张晴雨表,贴着用户曲线走,资源利用率高,用户体验稳;脱离曲线空谈规划,只会陷入要么浪费要么被动的循环,动态扩容不需要多么复杂的技巧,把指标看准、把阈值设好、把自动伸缩规则配齐,边缘节点就能自己找到合适的节奏。