实时处理选边缘流式还是中心批处理,核心看数据量:每秒几百到几千条、延迟要求毫秒级时用边缘流式更稳;每小时GB到TB级、能等分钟级结果的用中心批处理更省钱。
边缘流式处理和中心批处理哪个好?先把数据量摆到台面上说
很多团队纠结实时处理方案怎么选,其实问题没想象中复杂,先把“数据量”拆成三个可测量的维度:单点产生速率、全量汇聚速率、需要保留的原始数据规模,行业共识认为,判断框架里数据量权重最高,其次是延迟容忍度和网络稳定性。
- 单点产生速率:一个传感器、一路摄像头、一台服务器每秒吐出多少条记录。
- 全量汇聚速率:所有终端加总后,中心平台每秒或每小时要接收多少数据。
- 原始数据规模:一天下来落盘多少GB或TB,决定存储和重算成本。
如果单点速率低但终端数量巨大,汇聚到中心后会形成洪峰,比如十万个电表每5分钟报一次数,看着单点很轻,中心每小时要消化上千万条记录,这种场景边缘只做协议解析和数据整形,批量回传反而更合理。
实时数据处理方案怎么选:用数据量阈值做三步判断
这里不背概念,直接按实操路径走,先在边缘侧统计真实速率,再评估业务延迟,最后算网络和存储账。
第一步:统计单点数据产生速率
在Linux边缘网关上用命令看网络包速率:
ifstat -i eth0 1
sar -n DEV 1
如果部署了Kafka,查看某个topic的消息积压和消费速率:
kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group edge-group
看到的消息量如果在每秒几百到几千条以内,边缘流式处理通常承接得住,超过每秒几万条,单台边缘节点内存和CPU会快速触顶,要考虑在边缘做窗口聚合或抽样,而不是全量逐条处理。
第二步:评估延迟容忍度
- 毫秒级:设备联锁、安全急停、视频电子围栏,数据一出必须立刻在本地响应,不能等待云端往返。
- 秒级到分钟级:质量趋势预警、能耗看板,边缘先做初筛,中心做分钟级微批计算也够用。
- 小时级到天级:日报、月报、用户画像训练,直接走中心批处理,资源利用率更高。
第三步:测算网络与存储成本
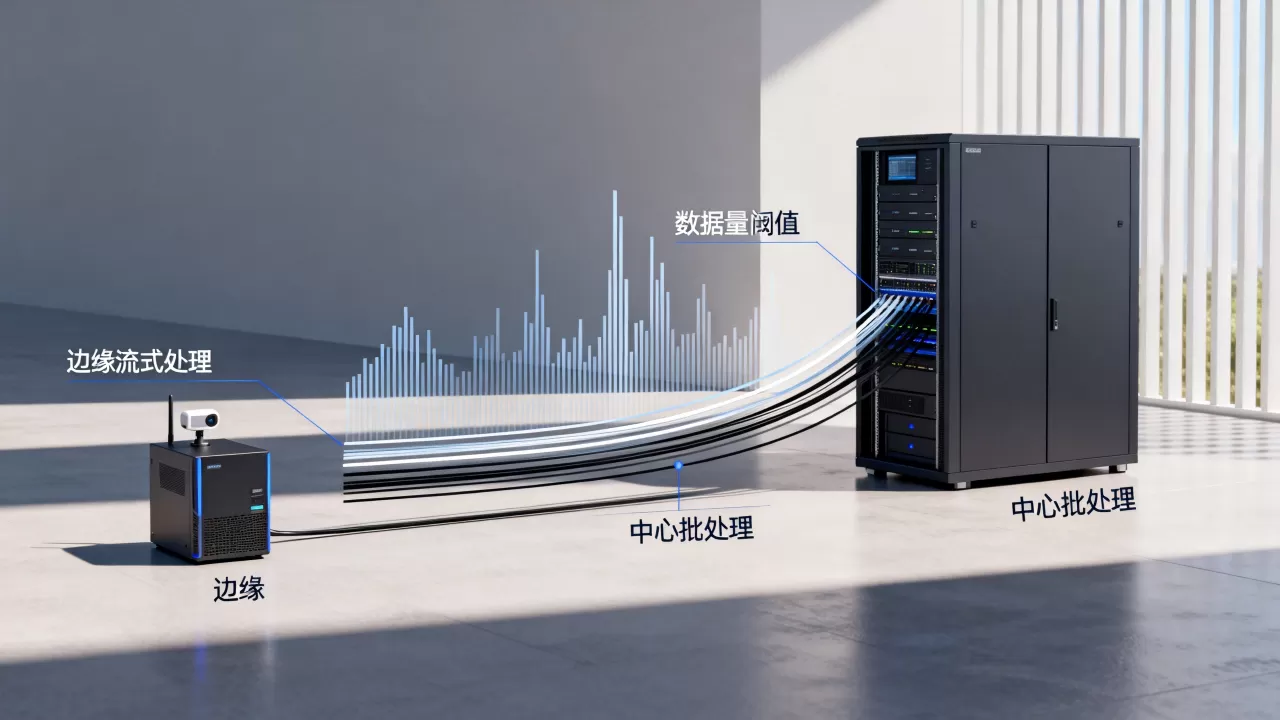
把同一条数据“全量上传”和“边缘过滤后上传”做对比,假设一个工厂有200个振动传感器,每个每秒产生1条512字节记录,全量上传一天约8.8GB,一个月约264GB,边缘只回传超过阈值的事件,一天可能不到100MB,云带宽和存储账单差距明显,这个例子里的具体字节数仅作估算演示,实际项目需要按自己采样率和字段长度算。
| 维度 | 边缘流式处理 | 中心批处理 |
|---|---|---|
| 数据量规模 | 每秒几百到几万条 | 每小时GB到TB级 |
| 延迟 | 毫秒到秒级 | 分钟到小时级 |
| 计算复杂度 | 规则引擎、轻量推理 | 复杂SQL、机器学习训练 |
| 网络依赖 | 弱网可短时自治 | 强依赖上传链路 |
| 典型场景 | 设备健康监测、实时质检 | 离线报表、推荐特征计算 |
| 成本结构 | 边缘硬件加运维 | 云端计算加存储 |
边缘流式处理适用场景:数据量不大但响应要快
不是所有“实时”都要上中心流处理引擎,数据量小、响应快、网络不稳定的场景,边缘流式处理几乎是最优解。
工业设备异常检测
每台空压机每秒上报温度、压力、振动三个测点,单点数据量不大,但异常要马上停机,操作路径是在边缘网关部署轻量规则:
rule: vibration_alert
condition: vibration_rms > 7.5 mm/s
action: local_alarm + stop_signal
window: 3s
边缘侧连续3秒超阈值就触发本地停机,同时把事件打包上传,这样做不依赖中心链路,断网时也能保护设备。
智能摄像头人形识别
一路1080p摄像头每秒产生25到30帧,单路原始码率在4Mbps到8Mbps,如果全部回传中心做识别,带宽成本高,延迟也大,边缘盒子跑轻量检测模型,只回传“有人闯入、时间戳、目标坐标”这类结构化事件,数据量从每天几十GB压缩到几十MB以内,实时性从秒级提升到毫秒级。
中心批处理适用场景:数据量大、能等得起、算得要重
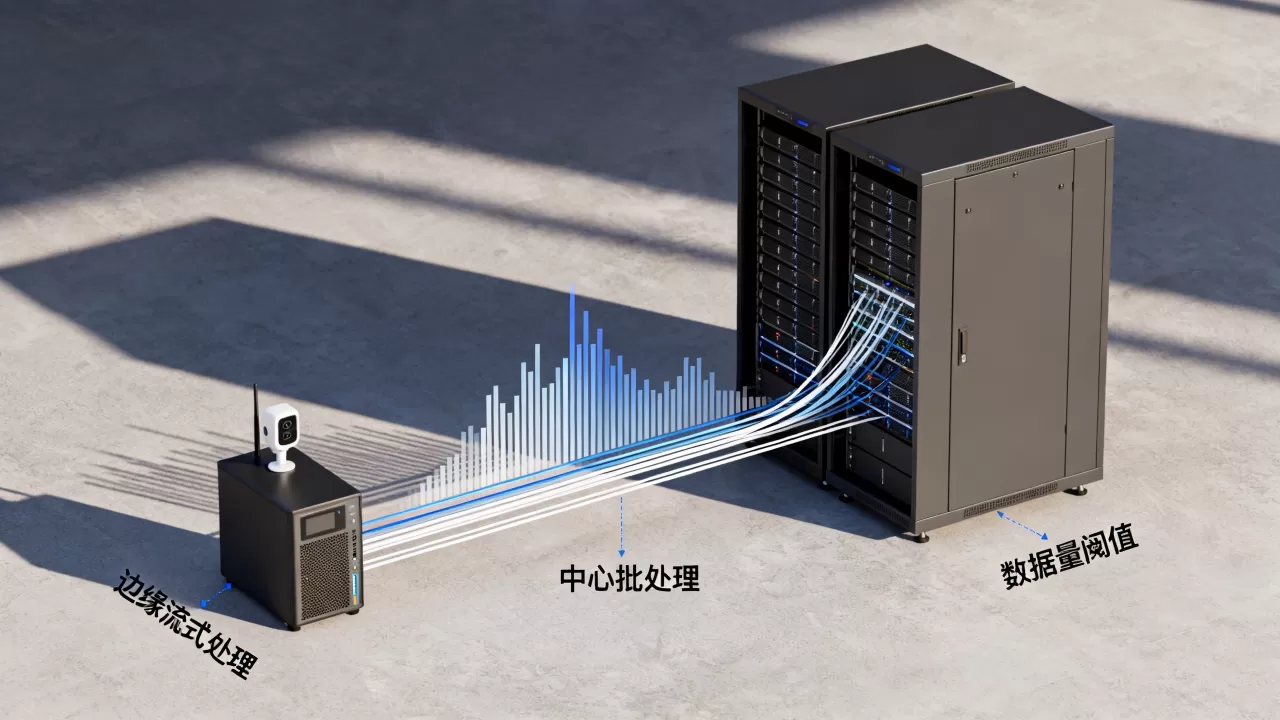
有些数据天然适合攒一批再算,边缘流式硬上反而会把简单问题复杂化。
电商用户行为日志
买家常在App里浏览、搜索、加购、下单,一次大促期间每天点击流可能达到数亿条,这种量级放到边缘无法成立,因为数据源是分散的App终端,根本没有单一边缘节点能承载全量,中心批处理用Hive、Spark SQL在凌晨跑漏斗分析、复购率、热销榜单,数据量再大也能靠集群横向扩容扛住,单次任务成本比维护一条实时流低不少。
财务报表与月末汇总
财务数据天然按周期出结果,凭证吞吐量不一定大,但计算规则复杂,涉及科目拆分、成本分摊、审计留痕,中心批处理把一个月数据统一重放,还能随时修正口径重跑,这种情况强行上实时流式,只会增加对账难度,没有任何业务收益。
边缘计算平台价格一般多少钱?由算力、接口和防护等级决定
很多项目卡在预算,因为不清楚边缘计算平台价格一般多少钱,价格不是单一数字,而是和数据量、算力类型、部署地域强相关。
影响价格的核心变量
- CPU和AI算力:纯ARM网关仅做数据采集和规则判断,价格通常在百元到千元级;带NPU或GPU的推理盒子,能跑视觉模型,价格上探到数千元甚至更高。
- 工业防护等级:0到40摄氏度的商用设备便宜;负40到75摄氏度、防尘防水的工业级设备贵得多。
- 接口数量:需要接入多路RS485、CAN、以太网、DI/DO,接口越多成本越高。
- 软件授权方式:部分平台按设备台数收年费,部分一次性买断,按设备订阅的方案初期便宜,长期量大了总费用会超过买断。
地域差异
一线城市边缘计算节点资源更丰富,带宽质量更好,但机柜和运维人工成本也更高,中小城市或园区本地部署边缘服务器,采购成本相近,但现场维护响应速度受地域影响,做预算时不能只看硬件价格,要算三年运维和链路费用。
混合架构为什么常被忽略:边缘先过滤、中心再全量分析
单聊边缘流式或中心批处理哪个好,容易走极端,真实项目里最稳的往往是混合架构。
- 边缘侧做实时告警、数据清洗、异常事件标记。
- 中心侧做全量历史存储、离线模型训练、跨节点聚合分析。
- 回传策略按优先级区分:紧急事件立即传,摘要一分钟传一次,原始数据深夜批量传。
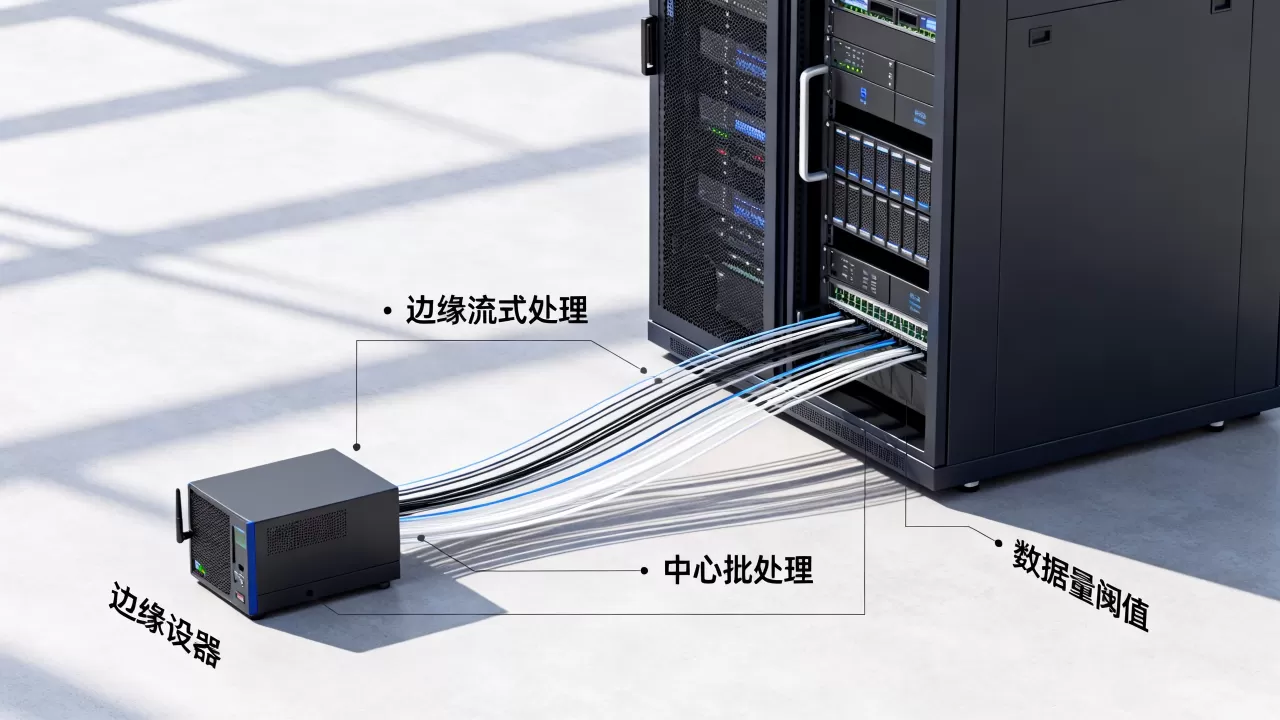
以车联网为例,车上边缘终端实时判断急加速、急刹车、疲劳驾驶倾向,触发车内语音提醒;中心平台每晚批量回放全天轨迹,做道路热力图和驾驶行为评分,这个组合既保证实时安全,又控制通信成本。
实时数据处理方案怎么选:一张表记住结论
再碰到“实时处理选边缘流式还是中心批处理”的问题,可以直接按这张表套。
- 数据量小、延迟毫秒级、弱网:边缘流式处理。
- 数据量大、延迟分钟级、强网络:中心批处理。
- 数据量中等、需要双重价值:边缘过滤加中心批处理。
- 数据量不大但计算复杂:中心微批或流处理,不要用边缘硬扛。
业内专家指出,多数生产环境不需要二选一,而是把数据量作为第一判断条件,再决定边缘和中心各自分担多少工作。
Q&A
边缘流式处理和中心批处理哪个更适合工业实时监控?
工业实时监控通常有机械联锁和保护停机需求,数据单点速率不高,但延迟必须控制在毫秒级,这种情况边缘流式处理更合适,边缘侧完成本地告警和数据过滤,中心只接收事件和分钟级统计,断网时设备仍能独立执行保护动作。
实时数据处理方案怎么选能兼顾成本和延迟?
先统计全量数据产生速率,再区分紧急数据和普通数据,紧急数据走边缘流式,普通数据走中心批处理,回传链路不要全量上传,边缘做聚合或事件过滤,这样既满足毫秒级响应,又把带宽和云端存储成本压低,具体阈值要按项目测试得出,没有通用精确数字。
边缘计算平台价格一般多少钱如何评估?
边缘计算平台价格由算力类型、接口数量、防护等级和软件授权方式共同决定,纯采集网关百元到千元级,带视觉推理能力的边缘盒子通常数千元级,工业宽温型号更贵,评估价格不能只问硬件报价,要把三年运维、现场维护、软件订阅都纳入总成本,一线城市带宽和人工成本更高,但边缘节点资源选择更多,事实是,同样规格的硬件放在不同行业和地域,最终落地成本差异可能达到数倍。