在海量设备上报场景中,用边缘聚合把高频小写入合并成低频批量写入,是显著降低中心入库压力的最直接手段。 它不是把数据变少,而是先算再传,让中心库从“每秒接无数小单”变成“每次接一批有信息量的数据”,下面按压力来源、聚合方法、落地步骤、网关成本、边界配合展开。
海量设备上报场景为什么中心库总被压垮
很多物联网平台前期调通了,设备一上量就频繁超时,表面看是服务器配置不够,实际多数情况下是写入模型出了问题,设备不是偶尔上报一条,而是几十台、几百台设备同时按秒级频率打点,中心库收到一条就 insert 一条,写入次数会成倍放大,单条数据包可能只有几十字节,但数据库要付出完整事务开销、索引更新和日志刷盘。
设备直连中心库的典型压力链路
- 传感器或 PLC 通过 DTU、采集网关把原始数据直接发到中心平台。
- 中心平台接收一条就写一条,不做窗口合并。
- 高频小事务持续占据连接,数据库连接池很快被占满。
- 网络稍有抖动,客户端重试,又叠加一波相同数据的重复写入。
行业共识认为,海量设备直连中心库时,多数数据库性能瓶颈不是磁盘容量,而是写入事务和连接管理的开销,中心库就像一个只开了一个柜台的前台,每台设备都来排一次队,队伍自然越来越长。
边缘聚合降低中心数据库写入压力怎么做
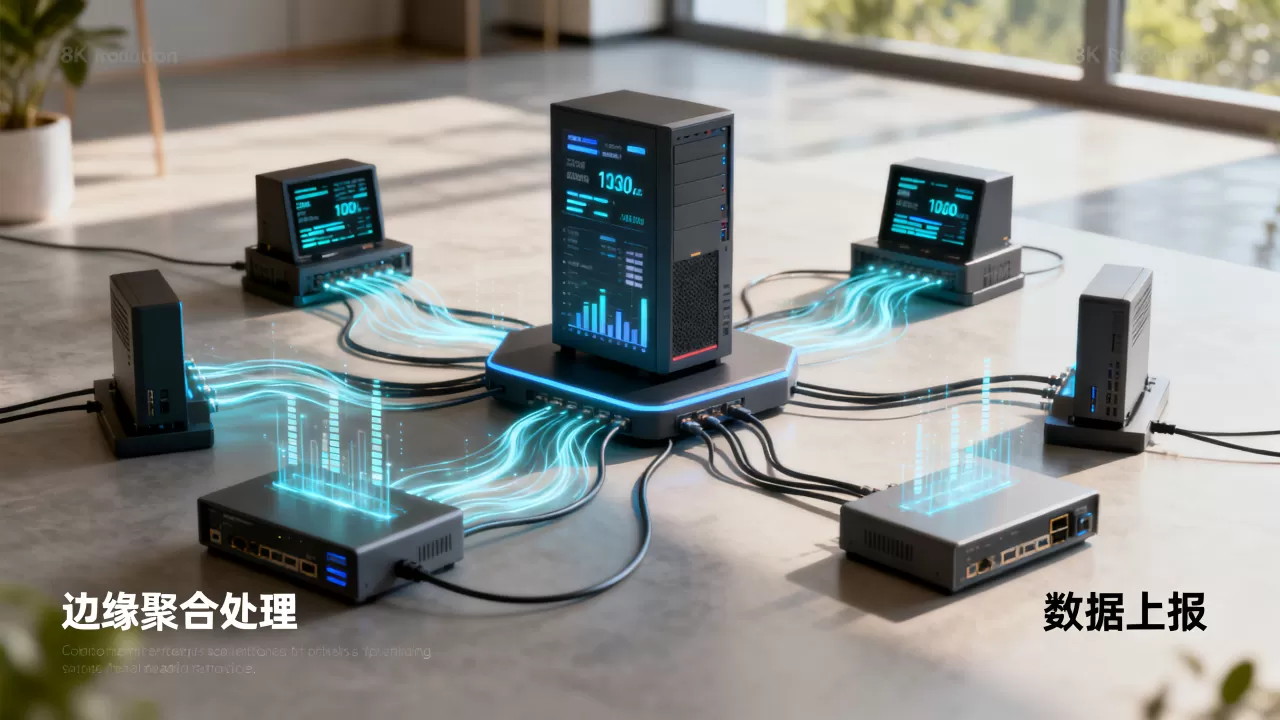
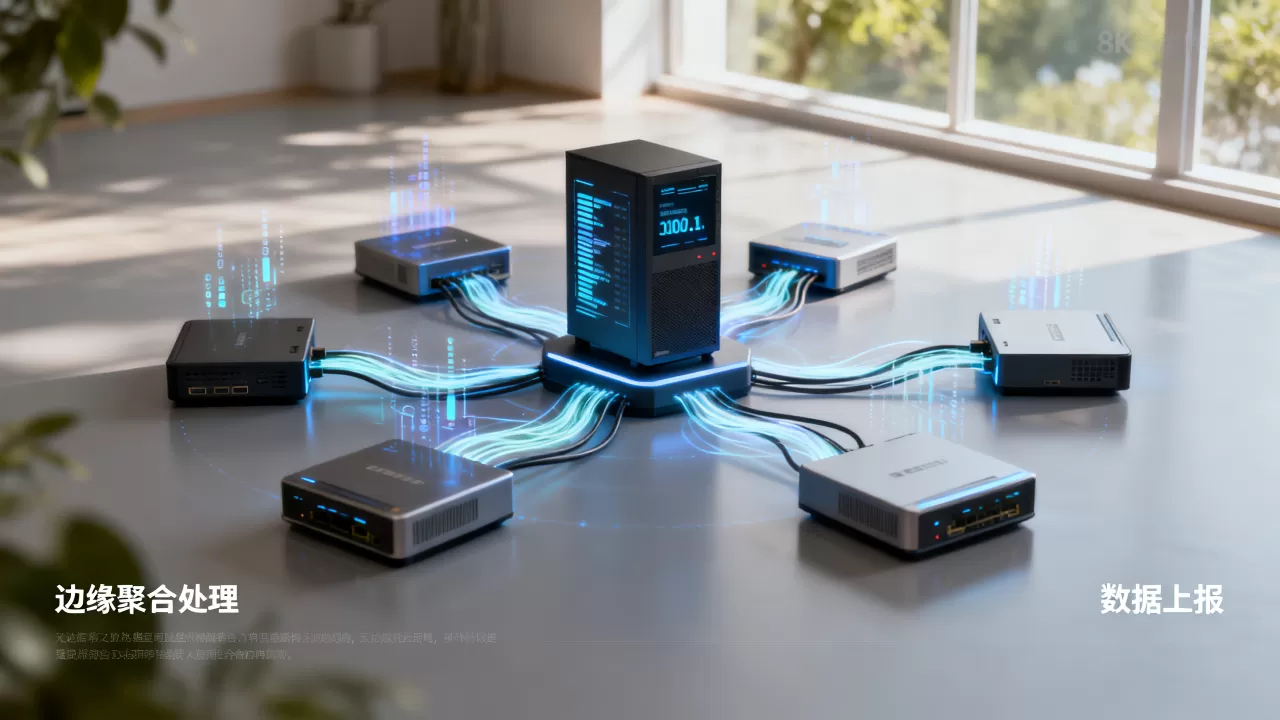
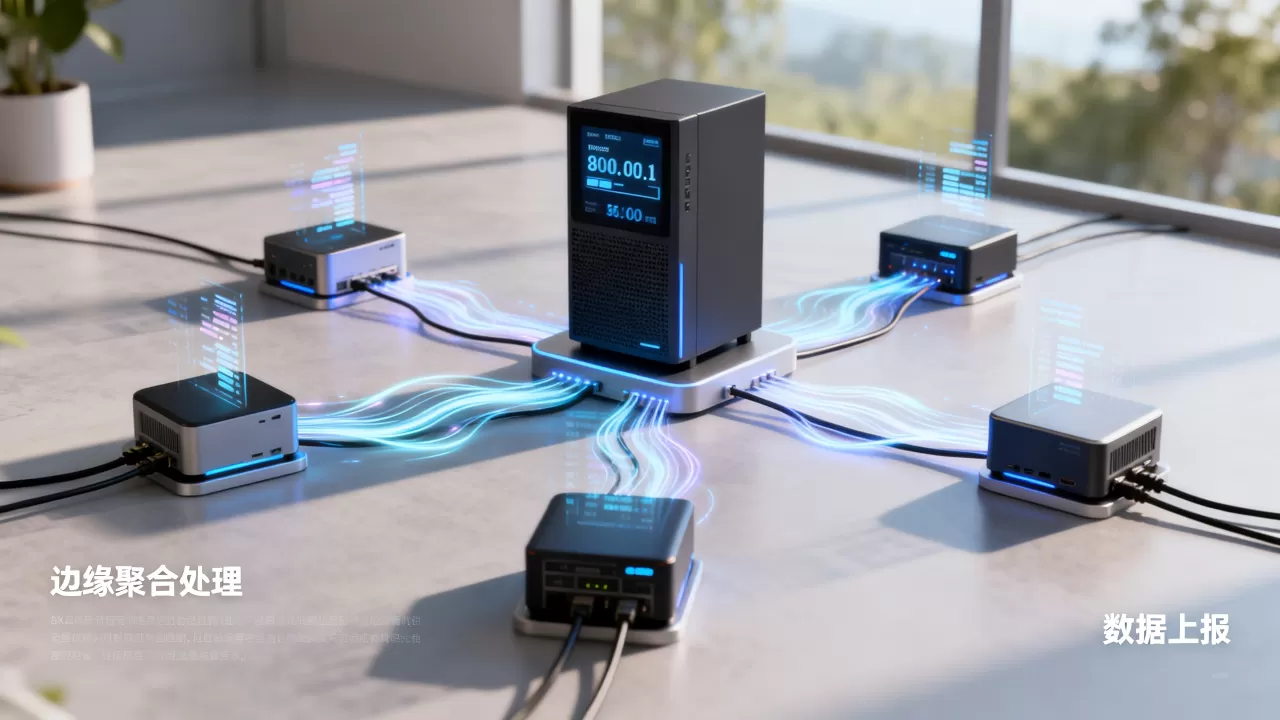
边缘聚合的核心不是“少采”,而是先算再传,边缘网关把同一类数据按时间窗口或数据条数合并,再统一批量送到中心库,原来每台设备每秒钟制造一次连接,现在变成每台设备每 10 秒甚至更久才产生一次批量写入。
时间窗口聚合:先把数据“合并同类项”
以温度传感器为例,原来每秒上报 1 条,边缘侧改成每 10 秒出 1 条,携带这 10 秒内的平均值、最大值、最小值,对中心库来说,写入条数从 10 条变 1 条,压力直接下降,窗口长度要按业务定:
- 温度、湿度等慢变量,10 秒或 30 秒窗口通常足够。
- 振动、电流等快变量,可用 1 秒或 5 秒窗口,重点保留峰值。
- 安全联锁信号不建议过度聚合,必须保持实时性。
批量写入和连接复用
边缘网关把窗口内数据打包成一个数组,通过 HTTP 或 MQTT 一次推给中心接口,中心库收到后走批量 insert,而不是逐条事务,这样数据库连接池占用显著减少,事务提交次数也大幅下降。批量写入比单条写入性能高出几个量级,这在时序数据库里尤其明显。
异常触发上报
很多场景不需要全部原始点都传到中心,可以配置规则:温度超过阈值立即上报原始值,正常波动只上报聚合值,这样中心库只在真正需要时接收细粒度数据,平时只收聚合后的轻量数据。
工业设备数据采集方案里边缘聚合怎么落地
工业设备数据采集方案实施时,边缘聚合不是买来网关就自动生效,需要配置规则、调整入库接口,还要考虑断网续传。
落地第一步:确定聚合窗口与业务容忍度
先梳理每类设备的上报频率、告警延迟要求、数据用途:
- 报表分析用分钟级聚合基本够。
- 设备故障诊断需要秒级峰值和异常点。
- 远程控制指令不能走聚合路径,必须直连。
落地第二步:在边缘网关配置聚合规则
以通用边缘网关为例,常见配置结构如下:
{
  "device_group": "temp_sensor_",
  "window_seconds": 10,
  "aggregations": ["avg", "max", "min"],
  "batch_size": 500,
  "upload_interval_seconds": 10
}
这条规则的含义是:匹配 temp_sensor_ 前缀的设备,每 10 秒计算一次平均值、最大值、最小值,满 500 条或到 10 秒就上传一次,不同厂商字段名会有差异,但思路一致。
落地第三步:中心库改为接收批量报文
中心入库接口要支持数组写入,以时序数据库为例,批量写入比单条写入性能高得多,接口示例:
POST /api/v1/batch/telemetry
Body: { "points": [...] }
数据库侧做好分区和索引,写入吞吐会稳定很多,接口要做幂等设计,防止断网补传时产生重复数据。
落地第四步:配置边缘断网续传
边缘网络不稳定时,聚合数据不能直接丢弃,网关需要启用本地缓存,断网时把批量包先落磁盘或内存队列,网络恢复后按顺序补传,这样中心库不会因断网恢复后的重试风暴再次被打满。
边缘计算网关价格和部署成本怎么算
很多人在选型时先问:边缘计算网关价格一般多少? 这个问题没有统一答案,因为硬件规格、协议库、是否带边缘容器、防护等级都会拉开差距,市场上入门级工业边缘网关通常几百元,带 AI 算力和丰富接口的往往数千元甚至更高,价格不是唯一权重,聚合能力和本地存储才是海量设备上报场景下的关键。
影响价格的关键因素
- 是否内置规则引擎,能否做时间窗口和阈值判断。
- 支持的工业协议数量,Modbus、OPC UA、DL/T645 等。
- 本地存储容量,断网续传能存多久。
- 环境防护,粉尘、高温、车载等场景需要加固。
- 是否支持远程配置和批量下发。
不同地域部署的价格差异
在华南、华东等工业设备数据采集方案集中地区,本地供应商多,入门级网关选择丰富,部署和调试成本相对可控,北方某些工业园区如果涉及低温环境,需要加温控和防护,成本会略高,综合看,边缘聚合降低中心入库压力带来的收益,通常远高于网关本身的一次性投入。
边缘计算和云计算的区别对中心入库压力的影响
边缘计算和云计算的区别在于:边缘负责局部实时计算,云负责全局分析和长期存储,海量设备上报场景中,如果所有原始数据都塞进云端中心库,带宽成本和写入压力都会失控,边缘聚合后,中心库接收的是已经加工过的“半成品”,数据量下降,入库压力自然减轻。
| 维度 | 直连中心库 | 边缘聚合后 |
|---|---|---|
| 写入次数 | 设备数×秒频,成千上万 | 窗口批量,明显减少 |
| 网络抖动影响 | 重试风暴容易产生 | 边缘缓存后再补传 |
| 数据库连接占用 | 高且持续 | 批量复用,占比下降 |
| 单条数据价值 | 原始点,噪音多 | 聚合值+峰值,信息密度高 |
| 适合场景 | 设备少、实时性极端 | 海量设备、报表与监控为主 |
落地时最容易忽略的三个点
- 聚合窗口和告警延迟要平衡:窗口太大,设备异常要 10 秒甚至更久才上报,影响响应速度。
- 不要把所有设备都强制聚合:保护类、联锁类信号应保持直连或极短窗口。
- 中心库批量接口要支持幂等写入:断网补传时可能出现重复包,幂等设计可以避免脏数据。
业内专家指出,边缘聚合不是要替代中心库,而是把中心库从“高频写入事务”里解放出来,让它去做更适合的查询、分析和长期存储,这个分工一旦跑通,海量设备上报场景的中心入库压力会从数量级上缓解。
Q&A:海量设备上报场景边缘聚合降低中心入库压力常见问题
边缘聚合降低中心入库压力会不会影响数据精度?
不会必然影响,聚合值保留平均、最大、最小等特征,中心库看到的数据密度下降,但关键特征没有丢,原始明细可以选择性保留在边缘或只对异常事件上传,对大部分监控和报表场景,聚合后的数据依然够用。
海量设备上报场景中哪些设备不适合边缘聚合?
安全联锁、急停、火灾报警、控制回路反馈等信号不适合长时间窗口聚合,它们的数据量通常不大,但对实时性要求极高,应直连中心库或走独立高速通道。
边缘计算网关价格和聚合性能是正比关系吗?
不完全是,价格较高的网关通常算力更强、协议更多、防护更好,但聚合性能还取决于规则引擎实现和本地存储设计,选型时应先确认设备总量、单点频率和窗口需求,再对比价格与实测写入吞吐,多数场景下,中端工业网关的规则引擎已经能满足基础的时间窗口聚合和批量续传。