边缘节点故障会影响业务连续性,但会不会影响整体,取决于架构里有没有自动摘除和流量切换机制。 单点故障只会造成局部延迟或少量失败请求,具备冗余和健康检查的架构,通常在几秒到几十秒内完成流量转移,整体业务不会中断。
边缘节点故障会影响业务吗?先拆开故障链路
边缘节点是靠近用户的转发、缓存或计算入口,它可能是CDN缓存节点、物联网边缘网关、5G MEC设备,也可能是自建的小型机房,节点一旦故障,用户侧首先感知到的是响应变慢、部分资源加载失败或连接超时。
常见故障类型主要有三类:
- 硬件故障:磁盘损坏、电源掉电、温度过高导致死机。
- 网络故障:上联带宽拥塞、光缆中断、BGP路由撤销错误。
- 软件故障:配置发布错误、进程OOM、证书过期未续期。
影响会不会扩散到整体业务,取决于两个变量:
- 是否有其他节点承载相同区域流量。
- 上层调度系统能否及时发现故障并自动切走流量。
如果用户请求通过DNS直接解析到故障节点IP,且没有备用记录,该区域所有用户都会无法访问,反过来,如果负载均衡器或DNS把故障节点快速摘除,请求会自动分发到邻近健康节点,业务连续性不会受到整体冲击。
边缘计算和云计算的区别,决定了故障隔离能力
边缘计算和云计算的区别不只是物理位置远近,更在于故障半径不同。
- 云计算中心集中部署,单地域故障可能影响全国甚至全球业务。
- 边缘节点分布广,单一节点故障通常只影响局部用户,天然具有隔离性。
- 云计算容灾更成熟,依赖多可用区、多地域切换。
- 边缘节点数量多,必须依靠自动化健康检查和调度,人工逐个处理不现实。
| 对比项 | 边缘节点 | 云计算中心 |
| 故障影响范围 | 局部用户 | 可能全量用户 |
| 网络延迟 | 低,适合实时业务 | 高,适合离线批处理 |
| 容灾方式 | 多节点自动剔除 | 多可用区切换 |
| 管理复杂度 | 节点分散,依靠自动化 | 集中度高,操作相对统一 |
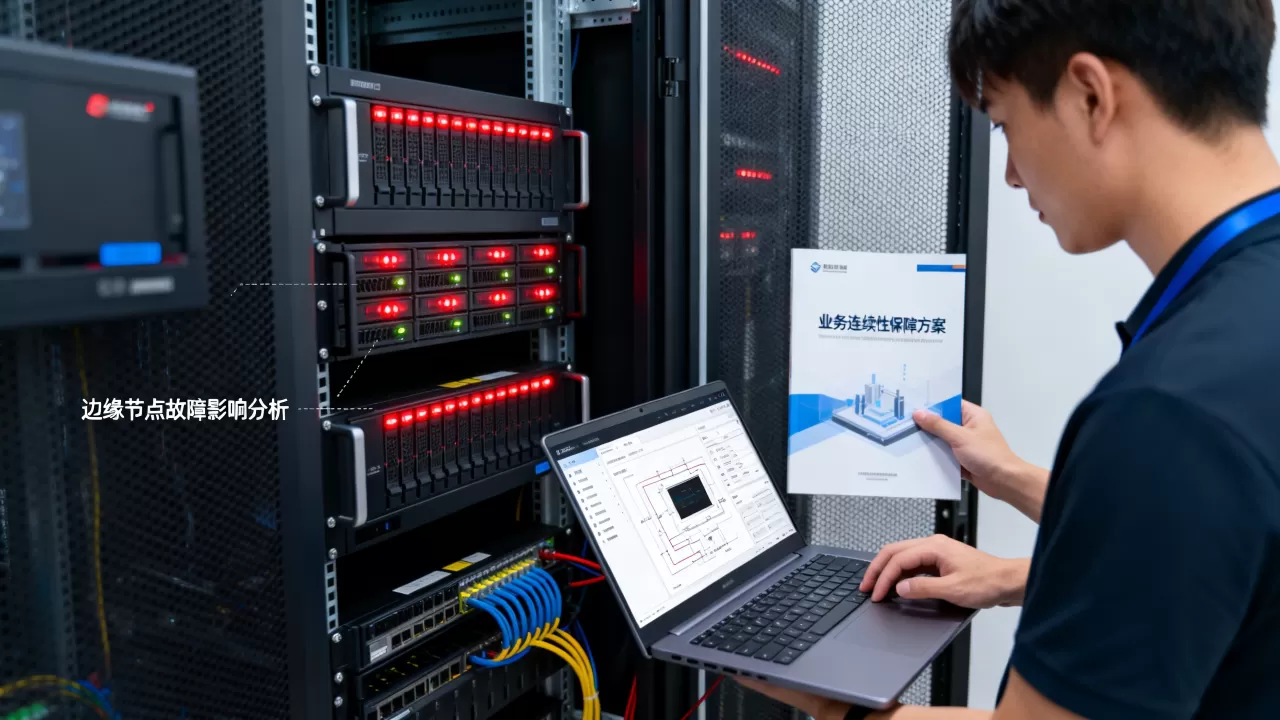
这意味着边缘节点故障时,整体业务连续性是否受影响,本质上不取决于节点本身,而取决于调度层是否具备云计算级别的自动化能力。
边缘节点单点故障解决方案:冗余切换实操
边缘节点最怕的不是故障,而是单点,行业共识认为,任何直接面向用户的边缘服务至少要做一层冗余,下面从DNS到应用层逐步拆解。
-
DNS健康检查与切换
在DNS服务商配置健康检查,探测边缘节点返回200或TCP连接成功,失败后自动把该节点的A记录权重降为0,或切换到备用节点,简米云DNS、DNSPod都支持按线路和权重配置。 -
Nginx上游摘除
边缘节点作为Nginx upstream时,可以用健康检查参数自动剔除故障节点:
upstream edge_backend {
    server 10.10.1.11:8080 max_fails=2 fail_timeout=15s;
    server 10.10.1.12:8080 max_fails=2 fail_timeout=15s;
    server 10.10.1.13:8080 backup;
}
连续失败2次后,Nginx会在15秒内不再转发到该节点。
- Kubernetes节点驱逐
边缘场景使用KubeEdge或OpenYurt时,节点失联后Pod不会立即重建,手动摘除命令如下:
kubectl get nodes
kubectl cordon edge-node-01
kubectl drain edge-node-01 --ignore-daemonsets --delete-emptydir-data
确认服务正常后再恢复节点。
- Anycast路由收敛
多个边缘节点宣告相同IP,北京节点故障后BGP路由自动收敛到其他地域,用户无感知,接入IP保持不变。
北京边缘节点故障怎么处理?看地域级容灾设计
如果北京边缘节点故障,影响的是华北区域用户,处理重点不是第一时间修机器,而是快速把流量切到可用地域。
操作路径可以按下面顺序执行:
- 登录CDN或边缘计算控制台,找到北京节点,确认健康检查是否已自动标记异常。
- 在DNS解析中,将华北线路的CNAME或A记录从北京节点切换到天津或济南边缘节点。
- 若使用自建Anycast,检查BGP邻居状态,确认北京节点路由已经撤销。
- 观察请求成功率恢复后,再排查北京节点底层原因,按硬件、网络、配置三类分别处理。
- 恢复后不要一次性切回北京节点,先按10%流量灰度验证,避免二次抖动。
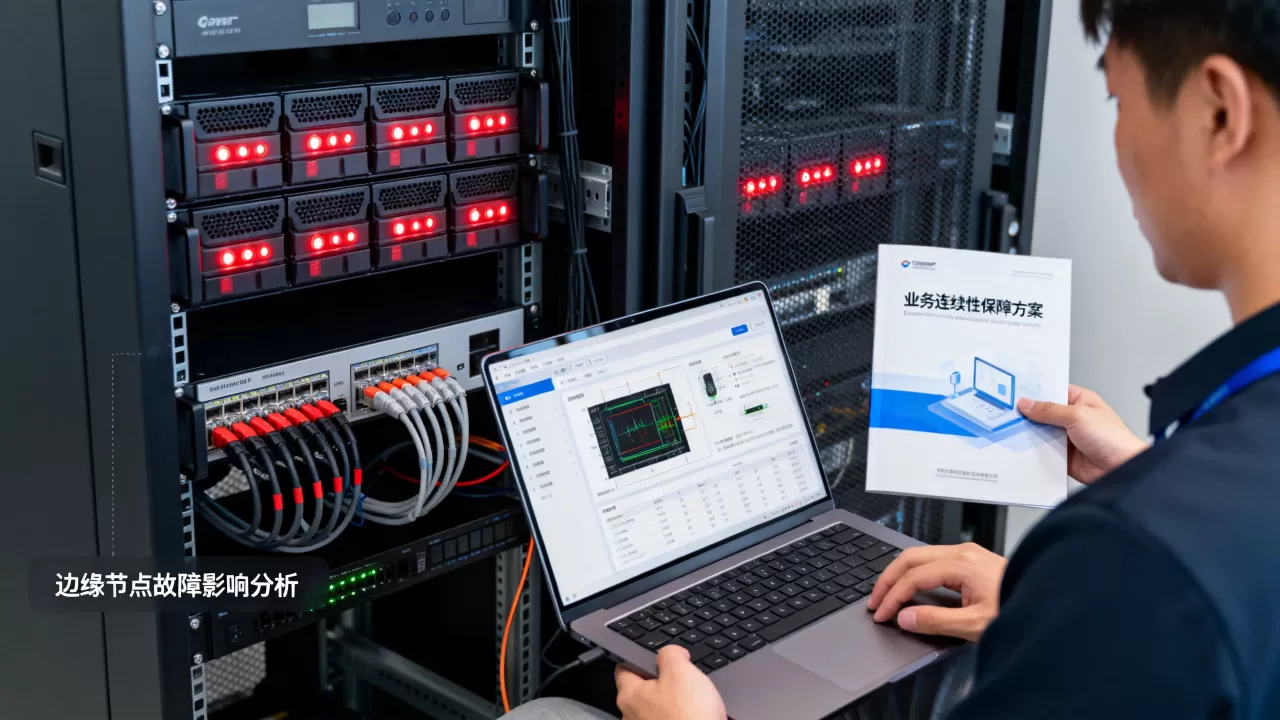
北京边缘节点故障怎么处理的核心思路,是“先切流、后修机、再灰度回切”,这个过程通常不会影响整体业务连续性,但华北用户延迟可能会增加几毫秒到十几毫秒。
边缘节点部署成本一般多少?容灾投入怎么算
边缘节点部署成本一般多少,主要看部署形态:
- 使用云厂商CDN或边缘计算服务,按流量、带宽、计算资源计费,无需一次性采购硬件。
- 自建边缘机房,成本包括服务器、交换机、机柜、带宽、UPS和运维人员。
- 混合模式,核心区域自建,次要区域用云边缘,兼顾成本和可靠性。
近年来,相当一部分中小企业倾向用云边缘服务替代自建边缘节点,主要原因是减少了机柜带宽和驻场运维两项固定支出。
业内专家指出,评估边缘节点成本时,不能只看单节点价格,还要算上故障造成的业务损失,一个没有冗余的边缘节点,省下的钱远低于一次局部业务中断带来的损失。
| 部署方式 | 初期投入 | 运维复杂度 | 故障恢复速度 |
| 云边缘服务 | 低,按量付费 | 低 | 快,平台自动调度 |
| 自建单节点 | 中 | 中 | 慢,需人工介入 |
| 自建双节点冗余 | 较高 | 高 | 快,需自动化配置 |
如果预算有限,可以先为核心区域边缘节点配置DNS级冗余,成本增加不大,但能避免局部节点故障直接变成用户不可用。
实操验证:如何检测边缘节点故障对整体业务连续性的影响
验证不能靠想象,要用故障演练来完成。
模拟边缘节点故障
在测试环境用tc命令模拟网络丢包:
tc qdisc add dev eth0 root netem loss 30%
或使用iptables屏蔽服务端口:
iptables -A INPUT -p tcp --dport 8080 -j DROP
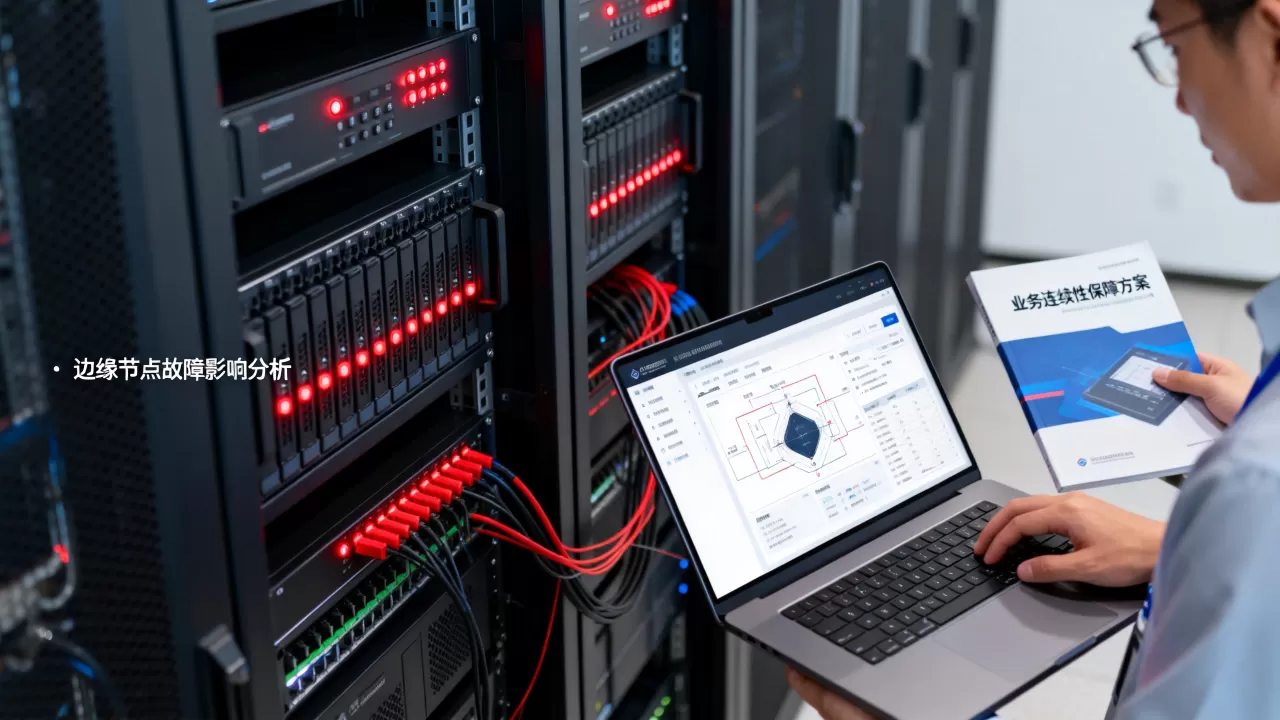
观察自动摘除效果
用curl循环请求业务域名,观察HTTP状态码和响应时间:
while true; do
  curl -s -o /dev/null -w "%{http_code} %{time_total}n" https://api.example.com/health
  sleep 1
done
如果状态码持续200,说明流量已经切到其他节点,如果出现非200或超时,说明健康检查配置未生效。
验证恢复过程
停止丢包或解除屏蔽后,观察节点是否自动重新加入,Nginx健康检查恢复后会自动转发,Kubernetes节点需要手动uncordon:
kubectl uncordon edge-node-01
同时确认日志中没有反复上下线抖动,抖动比直接故障更影响业务连续性。
通过这套验证步骤,可以明确边缘节点故障后业务连续性是否达标,若验证失败,优先检查健康检查间隔、失败阈值和超时时间是否合理。
边缘节点故障无法完全避免,但整体业务连续性可以被设计出来,只要有健康检查、自动摘除和流量切换三层机制,单点故障就不会扩散成整体中断,规划边缘节点时,先想清楚故障半径和切换路径,再谈部署数量和价格。
Q&A
边缘节点故障会影响业务吗?
会,但影响范围取决于架构,没有冗余和自动切换时,单点故障会导致局部用户无法访问,配置了健康检查和备用节点后,业务整体连续性通常不受影响,只可能出现短暂延迟或少量失败请求。
边缘节点单点故障解决方案有哪些?
常见方案包括DNS健康检查与权重切换、Nginx upstream自动摘除、Kubernetes节点驱逐、Anycast路由收敛,所有方案的核心都是提前定义故障判断条件,并让调度系统自动执行切流。
北京边缘节点故障怎么处理?
先在控制台确认节点状态,再把华北线路流量切换至备用边缘节点,等待请求成功率恢复后处理底层故障,最后通过灰度方式逐步回切,整个过程优先保障业务可用,再排查硬件或网络原因。