日志结构化存储比纯文本更容易检索,核心原因在于它把“读日志”这件事从人眼逐行扫描交给了机器精确定位,检索效率相差几个数量级。
日志结构化存储和纯文本格式的核心差异
要理解效率差距,得先看清两者底层的数据组织方式。
从人读到机器读,数据组织方式完全不同
纯文本日志长什么样?它是一长串连续字符,时间、级别、模块、内容全靠空格或逗号分隔。
2026-05-12 14:33:21 ERROR order-service 下单失败 user_id=1024
这种格式人眼能看懂,但机器看来就是一个字符串,想从中提取 user_id 这个值,需要写正则表达式去“抠”。
结构化日志则不同,它在写入时就按预定义字段拆好了,以最常见的JSON格式为例:
{"timestamp":"2026-05-12T14:33:21Z","level":"ERROR","service":"order-service","message":"下单失败","user_id":1024}
每个字段有明确键名和类型,没有歧义,不需要猜测,这就是最根本的分水岭。
检索原理对比:字段索引与全文扫描的效率差距
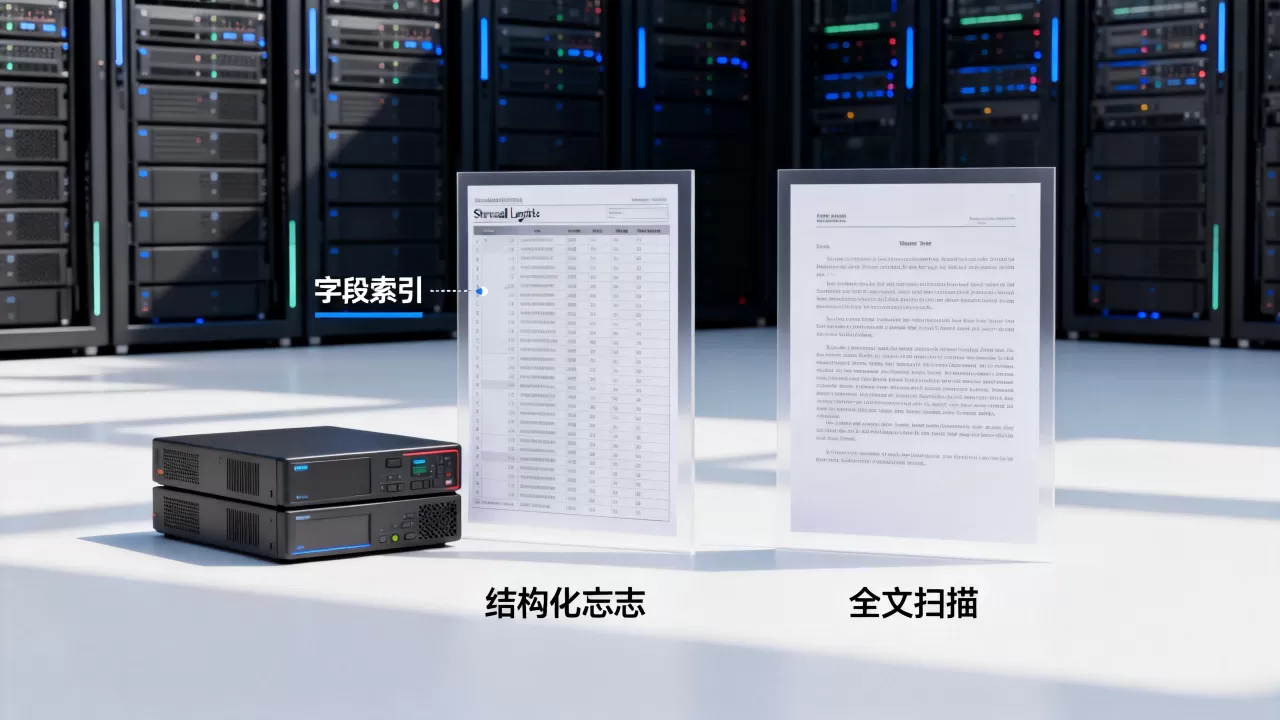
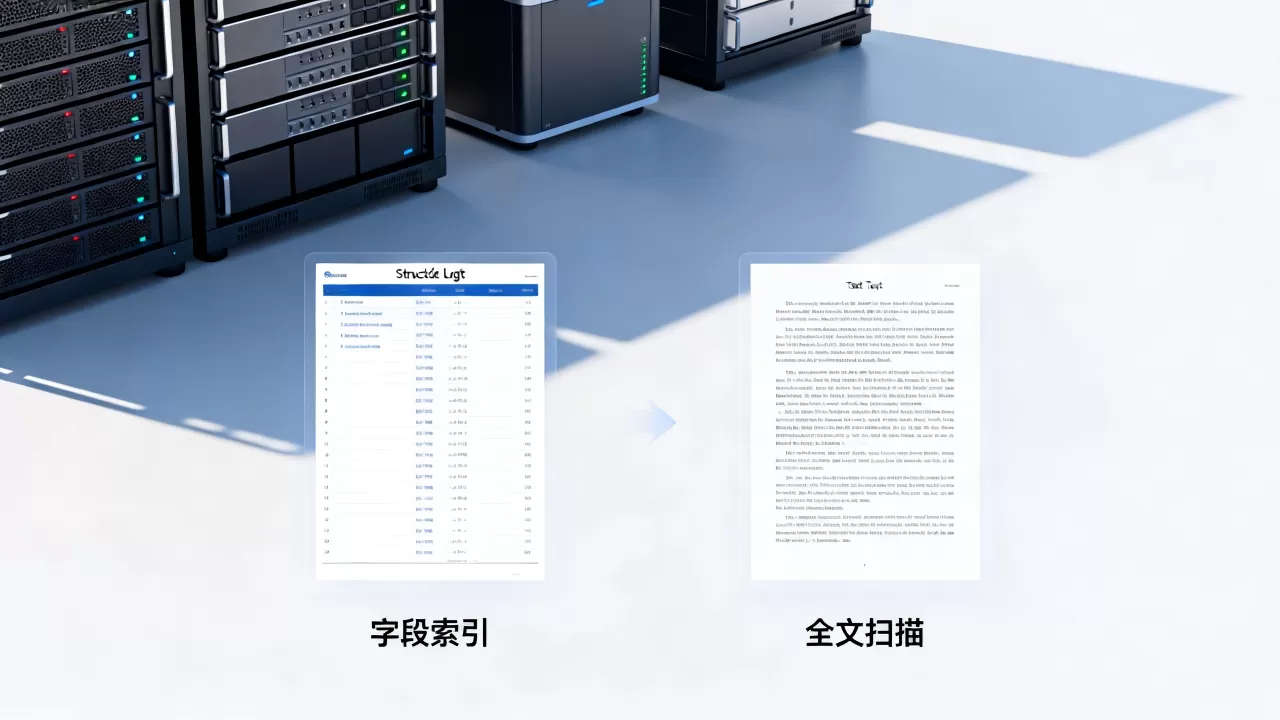
纯文本检索依赖全文扫描,想象一本没有目录的书,想找“订单超时”这个词,只能从第一页翻到最后一页,当日志量达到几十GB甚至TB级时,每次查询都是巨大的磁盘I/O消耗,响应时间以分钟甚至小时计。
结构化日志可以建字段索引,就像数据库对列建索引一样,针对 user_id、order_id、level 创建索引后,查询条件直接锁定目标数据块,跳过了大量无关数据,多数情况下,秒级响应是基本操作。
行业共识认为,在同等数据量下,结构化日志的查询速度比纯文本快一到两个数量级,这个差距会随数据规模增长进一步拉大。
实际场景中日志检索效率差距有多大
理论说完了,看实际对比,对于开发运维人员,最直接的体感来自故障排查。
定位线上问题时的操作路径对比
假设线上报了一个用户订单状态异常,用户ID是 1024。
在纯文本环境中,你通常这么做:
- 下载或远程搜索今天所有的订单日志文件
- 用
grep "1024" checkout.log逐个文件尝试 - 如果文件过大,
grep阻塞,可能先要用split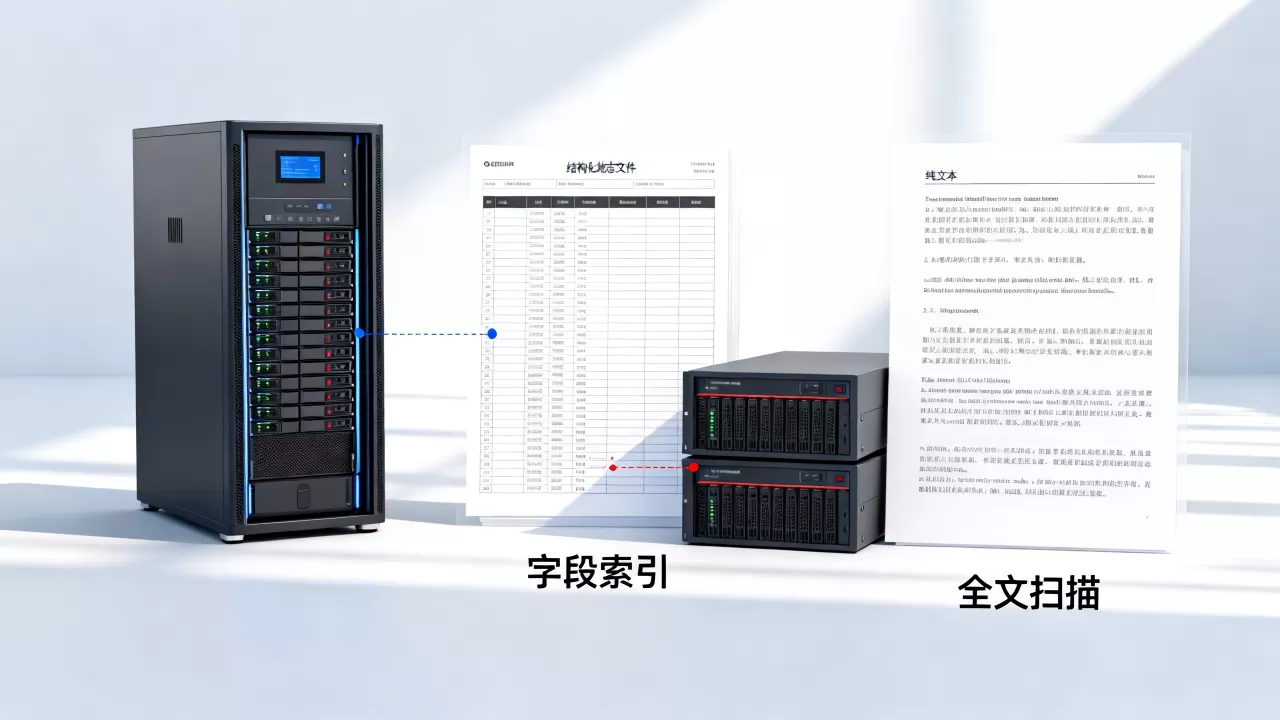
拆分文件
- 命中后发现关联的请求ID,又要用
grep去其他日志里查一遍
这个过程至少经过两三轮手工过滤,日志量越大,越接近大海捞针。
结构化环境里,操作路径是:
- 打开日志平台查询页面
- 在检索框输入
user_id:"1024",限定时间范围 - 系统根据索引扫描对应分片,直接返回完整上下文链路
查询语句更接近自然条件表达,没有任何歧义,这是日常排障中感知最明显的地方。
日志量级增长后的性能表现差异
很多团队面临这种情况:日志量不大时,纯文本用起来没毛病,一旦业务量增长,日志日增从几GB跳到几百GB时,问题集中爆发了。
纯文本方案的问题在于:
- 磁盘空间占用高,文本冗余信息太多
- 每次查询都是全量扫描,系统负载持续高企
- 无法按时间范围快速裁剪数据,因为时间戳没有独立索引
结构化方案通过分区和索引解决了这个问题,按天分片、按月归档,查询时只扫描目标分片,这套机制让日志平台在数据规模较大时依然保持可用性和查询性能。
日志结构化存储需要哪些工具支撑
不同规模团队的选择方向不同,这里做一个日志检索工具对比,帮你找到适合自己场景的落地方案。
中小团队快速落地的方案选型
如果你的团队没有专职SRE,日志量日增在100GB以内,业界主流选择是Elasticsearch(ES)加上Filebeat。
操作路径参考:
- 应用侧改造:把日志输出格式改成JSON,这一步通常用logback或log4j2的Layout配置即可完成
- 采集端配置:Filebeat读取JSON日志时自动解析字段,配置如下:
json.keys_under_root: true当然还可以用overwrite_keys开关覆盖文件自带字段名 - 服务端建索引:ES根据字段自动映射,无需手工建表
这套架构的好处是社区资料多、问题容易排查,很多团队从纯文本切换到这套方案的第一个月,排障时间就能缩短一半以上,这是相当普遍的经验数据。
数据规模较大场景下的选型建议
当日志量达到TB级,ES的存储成本会成为一个突出问题,近年来不少团队转向了Loki或ClickHouse方案。
Loki的特点是不对日志内容建全量索引,只索引标签(比如服务名、Pod名),查询时用LogQL表达式过滤,成本和复杂度相对低,ClickHouse则更适合复杂分析和聚合场景,物化视图能力让预聚合变得简单。
选型参考建议:
| 技术栈 | 适用场景 | 优势 | 劣势 |
|---|---|---|---|
| ELK全家桶 | 中小团队、需求灵活 | 生态成熟、查询语法丰富 | 资源消耗较大 |
| Loki | Kubernetes环境 | 存储成本较低、原生支持多租户 | 聚合分析能力相对弱 |
| ClickHouse | 日志时序分析需求复杂 | 查询响应速度表现出色、压缩率高 | 运维门槛较高 |
对于大多数业务团队,直接上ES是稳妥选择,因为这能覆盖绝大多数日志检索需求。
日志结构化存储的落地代价与性能考量
结构化存储不是没有成本,需要了解投入在哪里,才能做出合理判断。
应用改造负担与旧系统兼容
很多遗留系统使用的日志组件较老,不支持原生JSON输出,标准做法是引入logstash-logback-encoder之类的编码器,把日志事件转成JSON后交给grok等处理组件。
这里的代价主要在于开发改造时间,改造一个核心服务大约需要一到两天熟悉配置,踩过一遍字段映射的坑,但对于长期收益来说,这点投入值得,如果实在无法改造老系统,可以用Filebeat的pipeline在采集端做格式转换,将纯文本解析后重新组装成结构化字段,算是个折中路径。
存储膨胀与索引成本控制
JSON格式包含键名重复序列,存储空间比紧凑文本增加约三成是常见情况,怎么控制成本?
常用的控制手段有:
- 提高压缩率:ES使用best_compression压缩级别,日志数据一般能达到八到十倍的压缩比
- 关闭无需查询字段的索引:比如message字段只存不建索引,节约磁盘空间
- 冷热分层:将三十天前的数据转换为只读段,体积较大时迁移到成本更低的存储节点
综合考虑,存储膨胀问题可以通过多个维度得到有效控制,整体收益远大于成本压力。
结构化日志检索的常见误区和应对
不少人以为“只要变成JSON就万事大吉”,实际没那么简单。
字段类型映射不合理导致检索不准
日志字段在ES中映射为核心类型时容易混淆。user_id
这种长整型数字,如果按字符串处理,比较大小就不方便;IP字段如果默认精确匹配,处理范围查询时性能就会明显下降。
应对办法是提前在索引模板中指明字段类型,logstash的mutate插件也提供了类型转换能力,在pipeline阶段统一处理,避免业务侧输出类型不一致。
包含嵌套结构不易查询
系统日志中经常出现整个请求header或完整堆栈,用JSON格式输出会形成嵌套层级,查询时需要写较复杂的语法表达式,对不熟悉ES查询的用户不够友好。
比较有效的做法是分层处理:保证一级字段高归一化,高频查询字段完全扁平化,低频细节内容放嵌套结构里,查询时先过滤一级字段缩小范围,再逐步深入。
日志结构化不是银弹,但它从根本上解决了机器读取效率和检索精准度的问题,从纯文本到JSON是第一步,配好索引和管好字段类型是第二步,做好存储成本控制是第三步,顺着这个路径走下去,日志从“沉睡的资产”变成真正可快速调用的排障工具,这套投入不是成本,是运维效率的长期投资。
Q&A:日志结构化存储的查询操作细节
问:结构化日志查询一般用什么命令或者语句?
答:以ELK为例,查询条件用KQL语法表达,user_id: "1024" and level: "ERROR",需要范围查询时,可以用 @timestamp: [now-1d TO now] 做时间裁剪,对loki则用LogQL,{service="order-service"} |= "1024" 表示在指定服务标签中过滤包含该内容的日志行。
问:JSON格式和logfmt格式有什么区别?
答:二者都是字段明确的键值对,机器可读性相当,JSON支持嵌套对象,适合表达复杂数据结构,但体积略大;logfmt是 key=value 的压缩风格,体积更小、可读性稍好,但嵌套信息处理能力有限,中小团队用JSON起步不会有明显问题,偏重性能的团队倾向选择logfmt。
问:日志检索工具对比后,中小团队真的有必要上ES吗?
答:日志量日增在10GB以下的团队,直接用轻量方案也够用,比如Loki配合Grafana,查询体验直观且资源占用更低,日志量增长到几十GB并且多人查询频繁之后,ES的索引能力能有效应对复杂检索和聚合分析场景,对于出现明显查询性能瓶颈的团队,迁移到ES是值得做的投入,这通常也是日志平台演变过程中最常用到的路径。