分布式追踪里的span(跨度)代表一次具体的操作单元,父子关系本质是调用触发的层级关系,父span的结束时间必然晚于其所有子span。理解这对概念,是读懂调用链、定位性能瓶颈的起点。
分布式追踪里的span到底是什么
span在业内通常被称作“跨度”,它记录一次操作从开始到结束的全过程。 在微服务架构里,一次前端请求往往要穿越网关、订单服务、库存服务、支付服务等多个节点,每个节点处理期间做的每一步动作,都被拆成一个一个span,再用trace串联起来。
一次调用就是一个span
一个span的核心字段是固定的。traceId是整条链路的全局编号,spanId是当前操作的唯一编号,parentSpanId标记上一个节点是谁,除此之外,span还会记录操作名称、开始时间、结束时间、状态码以及若干自定义标签。
举个例子:你在外卖App下单,订单服务收到请求后,扣库存、生成支付单、发通知这三件事各自独立执行,它们会生成三个并列的span,这三个span的父节点是同一个“下单操作”span。
span跟日志有什么差别
普通日志只管打印“某时某刻发生了什么”,span则会告诉你“这次操作消耗了多少时间、关联了哪个上游调用、下游又调了谁”,业内专家指出,span的信息密度更高,因为它自带上下文,而日志只能靠人工搜索关键词去拼接。
分布式追踪里span的父子关系怎么理解
父子关系的判定标准很简单:谁触发了谁。 如果服务A的某个span在内部调用了服务B的接口,那服务B对应生成的span就是服务A这个span的子span,父span负责记录整体耗时,子span记录内部细节,多个子span还能并行存在。
父span和子span从时间线上怎么区分
时间线是最直观的证据,父span的起始时间早于子span,结束时间晚于所有子span,因为父亲必须等孩子全部干完活才能收尾。
可以这样记:父span是一段“包容性”时间区间,子span则全部落在父span的内部区间里,如果子span的耗时加起来小于父span的总体耗时,多出来的部分就是父span自身的业务逻辑或等待时间。
一个trace下的span父子关系怎么标识
标识靠的就是parentSpanId字段,整条链路的第一个span,parentSpanId为空,它就是根span,后续每个span创建时,会把调用方传过来的spanId写进自己的parentSpanId里。
用伪代码来表示这个过程:
- 服务A处理请求,生成span,id为A-1,parent为空
- 服务A要调用服务B,先创建一个子span B-1,parent=A-1
- 服务B收到请求,解析Header中的spanId,得到A-1,创建本地span C-1,parent=A-1
通过不断追溯parentSpanId,后端可以用一棵树还原整个调用过程。树的根节点就是根span,叶子节点是最细粒度的操作。
远程调用场景下父子关系怎么传递
跨服务的父子关系不能靠内存共享,只能靠网络传递,常见的做法是HTTP调用时在请求头写入三个字段:traceId、spanId、baggage,服务端收到请求后,用传入的spanId作为parentSpanId来创建新span。
近年来的技术趋势是采用W3C Trace Context标准,统一约定traceparent头部的格式,减少多语言SDK之间的兼容成本,国内主流开源框架SkyWalking、Jaeger以及云厂商的APM产品都已经兼容这一标准。
span父子关系在排查问题中能派上什么用场
没有父子关系,调用链就只是一堆零散的时间片段,有了父子关系,才能按层级还原全貌。 实际排查问题时,这套关系能帮你快速回答三个问题:慢在哪、为什么慢、谁拖累了谁。
看耗时分布定位瓶颈
在追踪系统里选中一次慢请求,展开span树,按耗时倒序排列各个span,最大的那个就是瓶颈所在,父span耗时正常、某个子span特别慢,说明问题出在子调用;父span很慢而所有子span都快,说明问题出在父span自身的逻辑上,比如加锁等待、数据库连接池耗尽。
识别串行调用与并行调用
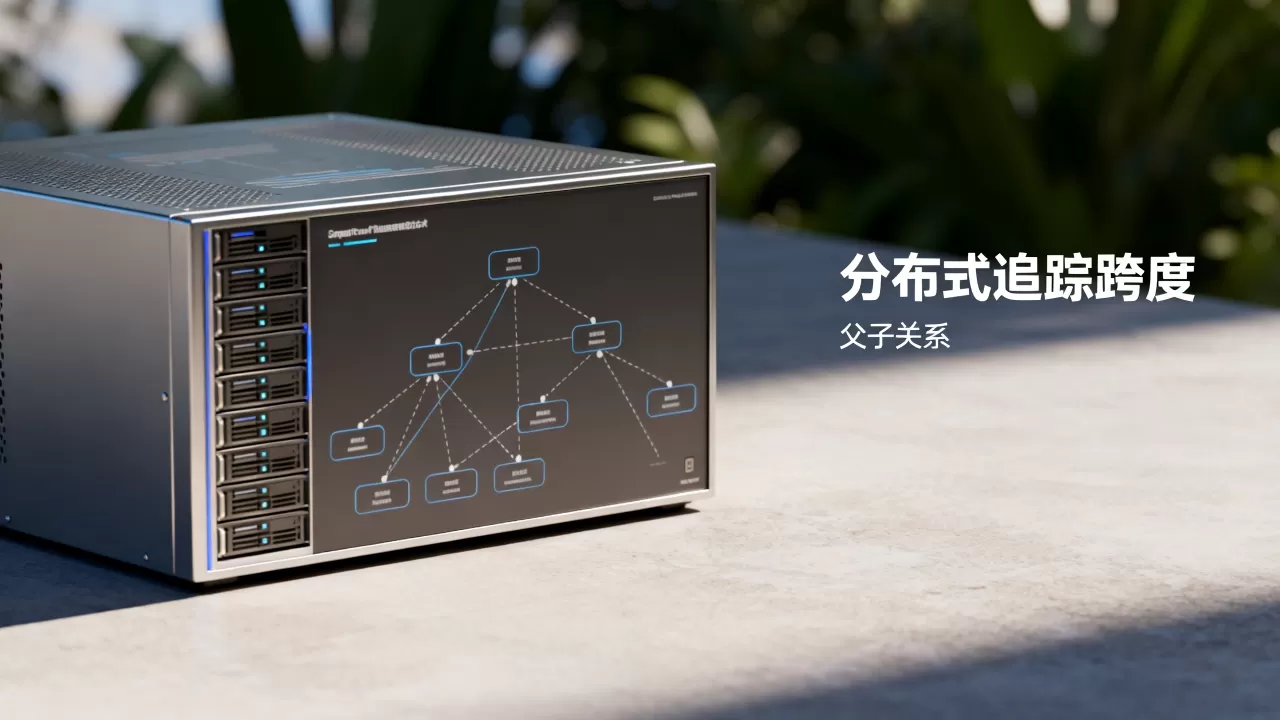
看span的层级和平铺关系可以一眼看出代码是串行还是并行:
- 多个span首尾相接、时间不重叠,说明是串行执行
- 多个span起点接近、时间区间互相重叠,说明是并行执行
- parentSpanId相同、spanId不同的多个span,代表同一批次的分支操作
如果业务要求并发但追踪图上呈现的是串行,说明代码里漏写了异步逻辑,这是性能优化的常见突破口。
匹配日志还原异常现场
把spanId加到业务日志里,打点时统一写入,出错时先在追踪系统找到异常span的id,再到日志平台按spanId搜索,就能看到这一跳前后的详细上下文,建议团队统一规范:每个span至少上报一个business.error标签和一个日志关联字段。
采样与开销对span父子关系的影响
链路追踪是有代价的,每生成一个span,就要做一次序列化、网络发送和存储写入,高并发场景下全量采集会让存储成本高得离谱,因此系统需要一套取舍策略。
常用采样策略对比
| 采样方式 | 工作原理 | 适合场景 |
|---|---|---|
| 头部采样 | 在入口处决定是否采集整条链 | 低流量、对完整性要求高的系统 |
| 尾部采样 | 先把span缓冲下来,分析完再决定保存哪些 | 需要保留慢请求和错误请求的场景 |
| 概率采样 | 按固定比例随机抽取链路 | 高流量、只做宏观统计的场景 |
需要特别留意的是,采样发生在入口时,整条链路会完整保留或完整丢弃,不会出现父子断裂的情况。 但尾部采样在不同节点异步上报时,可能出现父span已到达、子span还在缓冲中的短暂“孤儿”状态,多数追踪系统会设置延迟等待窗口来解决这个问题。
搭建一套能看span父子关系的追踪系统怎么选型
选型既要看项目技术栈,也要看团队的运维成本,这里列出几个常用选项做一个横向对比。
自研接入 vs 接入开源组件
如果团队Java生态为主,Apache SkyWalking是国内使用很广的选择,它通过Java Agent方式字节码注入,业务代码改动量很小,且原生支持子span的自动拆分,如果团队多语言异构,OpenTelemetry是行业标准的选择,提供了统一API和SDK,把span数据导出到Jaeger或Zipkin。
云厂商APM的落地成本
国内的云厂商APM产品普遍支持分布式链路追踪,在控制台可直接看到span的调用树和父子关系,无需自建存储和UI,价格模式大多是按数据量计费,小流量场景下有免费额度,大流量场景下费用会明显上升。若对数据落地方案有要求,或需要跨云部署,建议优先考虑自建开源方案。
有关span父子关系的几个常见疑问
一个span只能有一个父span吗
是的,span的模型是一棵树,每个子span只能有一个父span,但一个父span可以有很多子span,对应一次调用里拆出的多个并行子操作,若两条链路共享同一段存储操作,它们会分别记录各自的span,不会被复用到同一个父节点下。
span的父子关系会跨多个服务吗
会,这正是分布式追踪的核心价值。traceId跨服务传递,parentSpanId跨服务传递,但跨度本身存储在各自的服务节点上。 在UI上看到树状关系时,子span对应的服务节点可能就是另一台机器、另一个进程,甚至另一个数据中心的实例。
需要给每个方法都创建span吗
不建议过度拆分,span粒度太细会显著增加存储开销,也让追踪图变得冗长,行业共识是:每个跨网络调用创建一个子span,本地方法内部只用日志或tag记录分支细节即可。 这样既保留了关键的父子结构,又不会让数据量失控。
理解清楚span和它的父子关系后,读调用链就不再是看天书:找到根span,顺着parentSpanId往下钻,每一层的时间消耗和责任归属都能对上号,排查问题时,这份清晰的层级地图比任何监控面板都更接近真相。