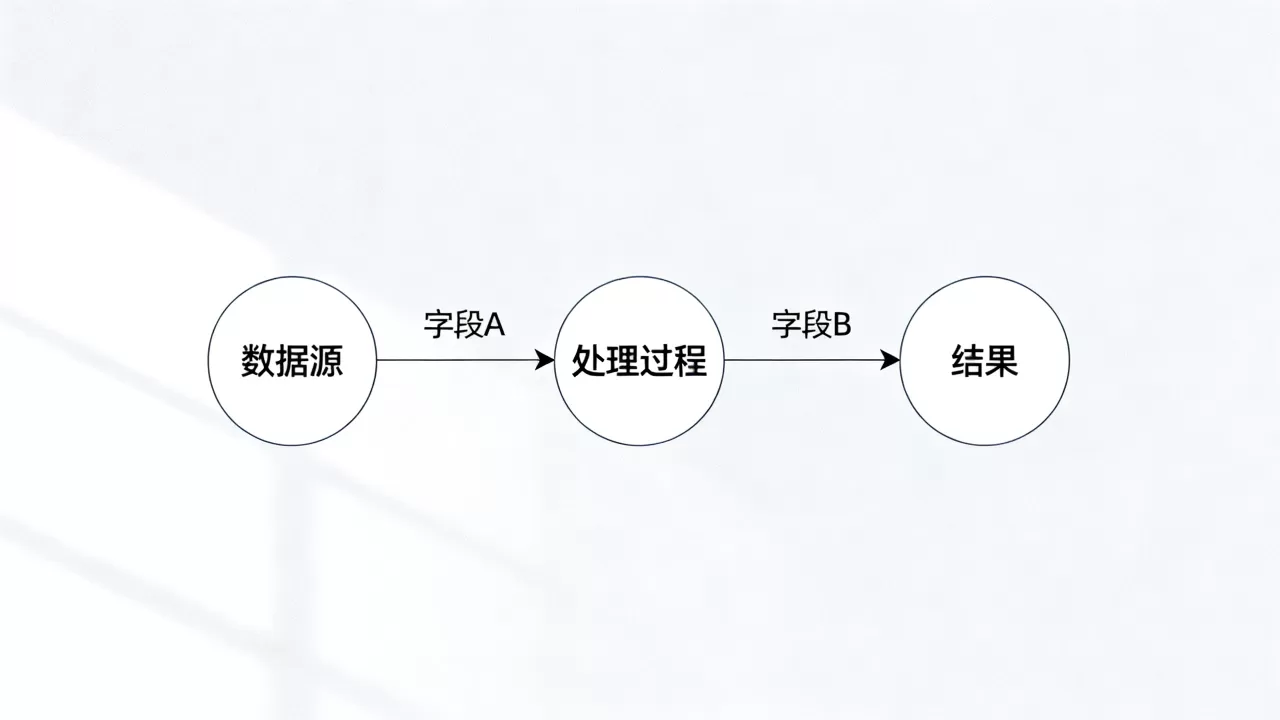
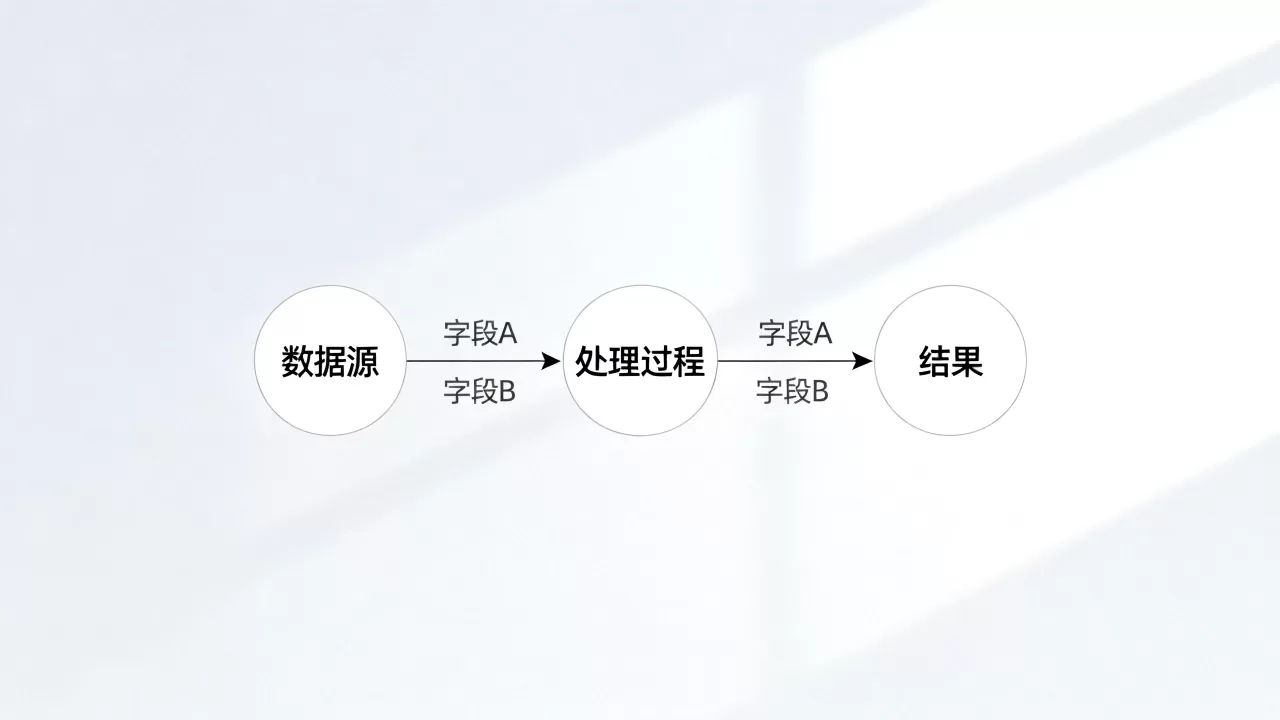
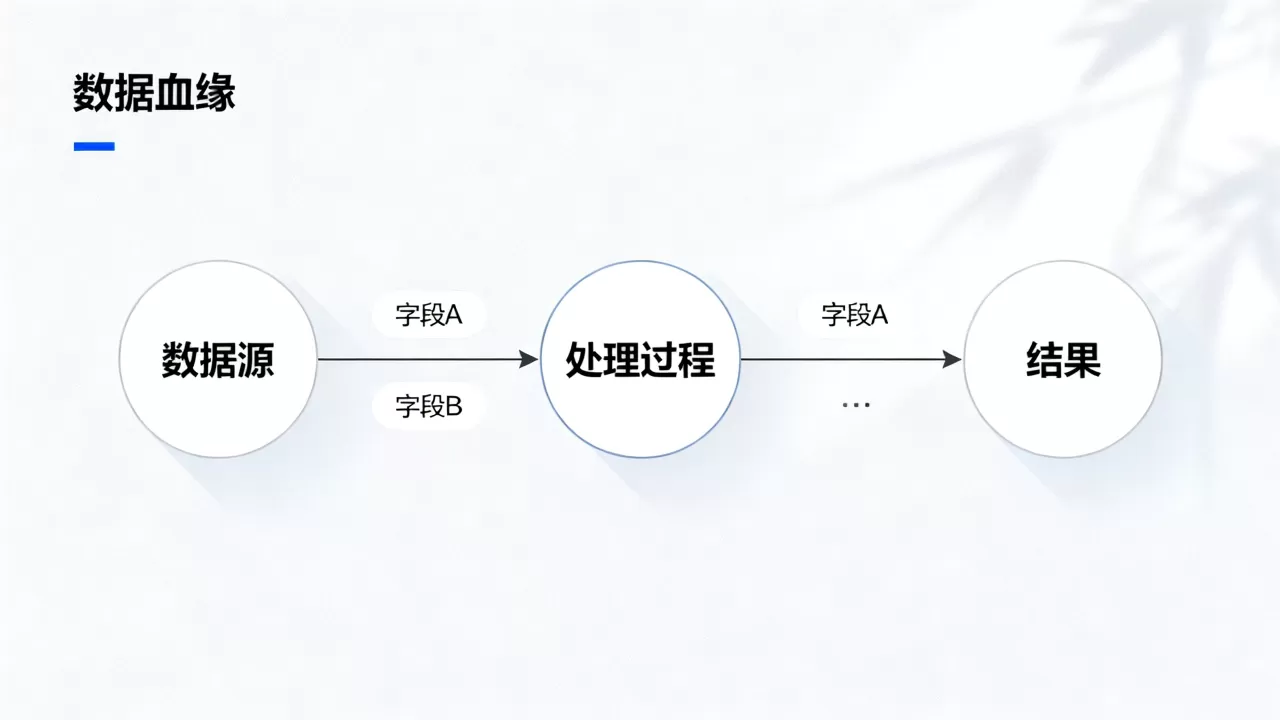
数据血缘记录了字段从源头到结果的完整流转路径,它就像给每个字段建了一份“履历表”,让数据从哪来、经过谁的手、最终流向哪里都能在分钟级内查清。 在数仓、数据中台或指标平台里,最怕遇到“这个字段怎么算的?上游改了会影响谁?”没有血缘,只能翻代码、问人、猜;有了血缘,直接查图。
数据血缘是什么?为什么它像数据的“行车记录仪”
数据血缘属于元数据管理范畴,描述数据从源系统到目标系统的转换关系,你可以把它理解成数据版的“食品溯源系统”:一瓶牛奶能查到牧场、加工厂、物流车,一个字段也该能查到源表、加工SQL、下游报表。
- 表级血缘:只记录表与表之间的依赖,比如ods_user表经过加工生成dwd_order表。
- 字段级血缘:下钻到列级别,记录user_id如何映射成buyer_id,以及关联、聚合、截断等具体转换逻辑。
- 字段级数据血缘追踪是数据治理走向精细化的关键一步,没有它,影响分析只能停留在“这张表下游有谁”,有了它,才能精确到“这个字段改了会崩掉哪几个指标”。
数据血缘怎么实现?从SQL解析到图数据库的完整路径
想把血缘搭起来,并不是买一套工具就完事,核心路径分三步:先让机器自动解析加工逻辑,再用人工补录兜底,最后存入图数据库对外提供查询。
自动解析SQL是第一步
大多数数据加工发生在SQL里,自动解析SQL是最高效的血缘采集方式,常用的解析器包括Apache Calcite、JSqlParser、Druid SQL Parser,以及基于Antlr自研的解析器。
在Hive场景下,可以开启执行后钩子:
set hive.exec.post.hooks=com.example.LineageHook;
Hook类会拿到本次执行的SQL文本和输入输出表,解析后把字段映射关系写入元数据库。
在Spark场景下,可以通过QueryExecutionListener捕获逻辑计划,提取Project、Join、Aggregate等算子的字段引用关系,解析完成后的输出统一为三元组:源表.字段 -> 目标表.字段 -> 转换类型。
手动补录与元数据采集结合
并非所有加工逻辑都写在标准SQL里,Flink作业、Java程序、Python脚本、Excel手工报表,这些都是自动解析的盲区,这时需要手动补录。
操作路径:在元数据平台里创建“血缘补录”入口,选择源字段、目标字段,填写转换表达式或业务说明,并指定责任人,手动补录的数据与自动解析结果合并时,通常以自动解析为准,手动标记为补充。
元数据采集还要覆盖数据库表结构、调度任务、指标定义、报表模型,只有把这些基础信息采全,血缘图才不会断链。
血缘图谱如何生成与展示
存储层推荐使用图数据库,比如Neo4j、NebulaGraph或JanusGraph,节点代表表、字段、任务、报表,边代表数据流向和加工关系。
以一个字段为例,向上游递归查询所有来源的Cypher语句大致为:
MATCH (f:Field {full_name:'dwd_order.buyer_id'})-[:DERIVED_FROM]->(src:Field)
RETURN src.full_name, src.table_name
前端可以用G6、D3.js或Cytoscape.js绘制力导向图,让用户点击节点展开上下游。
数据血缘和影响分析的区别:别把两个概念混为一谈
不少数据团队把血缘和影响分析当同义词用,实际上两者边界很清楚,数据血缘是静态的关系图谱,影响分析是基于这张图做的动态风险评估。
| 对比维度 | 数据血缘 | 影响分析 |
|---|---|---|
| 本质 | 关系记录 | 风险评估 |
| 触发时机 | 数据加工时生成 | 变更或故障时执行 |
| 输出物 | 链路图 | 影响清单 |
| 依赖条件 | 元数据采集质量 | 血缘完整度 |
举个例子:字段级血缘能告诉你,用户表的user_id经过三次JOIN、两次聚合,最终进入高管驾驶舱的“复购率”指标,影响分析则会在有人修改user_id类型时,自动列出会受影响的中间表、指标、报表和调度任务。
数据血缘在数据中台中的作用:从合规到提效
数据中台建设到一定阶段,数据血缘就成了绕不开的基础设施,它直接决定中台是“能看”还是“可管”。
- 治理侧:自动生成数据资产目录,统一指标口径,识别冗余字段和僵尸报表。
- 合规侧:个人信息保护法和GDPR要求企业能定位个人数据的存储位置和流转路径,没有血缘,响应一次数据主体查询请求可能要靠人工翻遍几十个系统。
- 提效侧:新人接手项目时,顺着血缘图半小时就能看懂整条链路;线上指标异常时,从结果字段向上追溯,能快速定位是哪个上游任务出了问题。
行业共识认为,缺乏字段级血缘的数据中台,在监管审计和内部治理中往往会陷入“人海战术”,难以规模化复用。
字段级数据血缘追踪实操:给数仓装上“探头”
如果你的团队想从零开始落地字段级血缘,可以按下面五个步骤走。
- 圈定范围:先覆盖核心数仓链路,比如ODS到DWD、DWS再到ADS,别一上来就追求全公司覆盖。
- 部署采集代理:使用DataHub或Atlas的ingestion框架,配置Hive Metastore地址、调度系统日志路径、数据库连接串。
source:
type: hive
config:
 metastore_uri: thrift://hive-metastore:9083
- 接入解析:把调度系统产生的SQL日志推送到解析服务,解析结果以JSON格式写入消息队列。
- 构建图谱:消费消息队列,将字段关系写入图数据库,同时保留表级血缘作为兜底。
- 对外服务:提供REST API,支持按字段名、表名、任务名查询上下游,前端嵌入血缘视图。
这套方案不依赖特定商业软件,开源组件就能跑通,团队有Java或Python工程能力即可维护。
数据血缘工具价格对比与选型建议
工具选型主要看预算、技术能力和信创要求,开源工具免费但需要自己维护,商业工具开箱即用但成本较高。
| 工具 | 类型 | 字段级血缘 | 部署模式 | 价格区间 |
|---|---|---|---|---|
| DataHub | 开源 | 支持(需配置) | 私有化 | 免费,自维护 |
| Apache Atlas | 开源 | 支持 | 私有化 | 免费,自维护 |
| Informatica EDC | 商业 | 强 | 私有化/云 | 按年订阅,较高 |
| 国产商业平台 | 商业 | 多数支持 | 私有化/云 | 数万元到数十万元/年 |
选型建议:技术团队强、预算有限,优先选DataHub或Atlas;需要原厂支持、有金融级合规要求,选商业工具;国内企业有信创要求,可重点考察国产商业平台。
数据血缘的价值不在图本身,而在于让每次数据变更、每个问题排查都有据可查,字段级血缘一旦建成,数据中台才能从“能看”升级为“可管”。
关于数据血缘怎么实现的常见问题
数据血缘怎么实现自动化采集?
主要通过SQL解析器和调度系统Hook自动捕获,Hive可配置post hook,Spark可注册QueryExecutionListener,Flink可通过自定义算子监听,解析结果写入元数据库,手动补录作为兜底。
数据血缘和影响分析的区别是什么?
数据血缘是静态的关系图谱,记录字段从源头到结果的流转路径;影响分析是基于血缘图谱的动态评估,回答“改了某个字段会影响到哪些下游”,血缘是基础,影响分析是应用。
数据血缘工具价格一般多少?
开源工具如DataHub、Atlas可免费使用,但需要自行部署和维护,商业工具通常按年订阅,根据节点数和功能模块,多数在数万元到数十万元区间,具体报价需联系厂商。