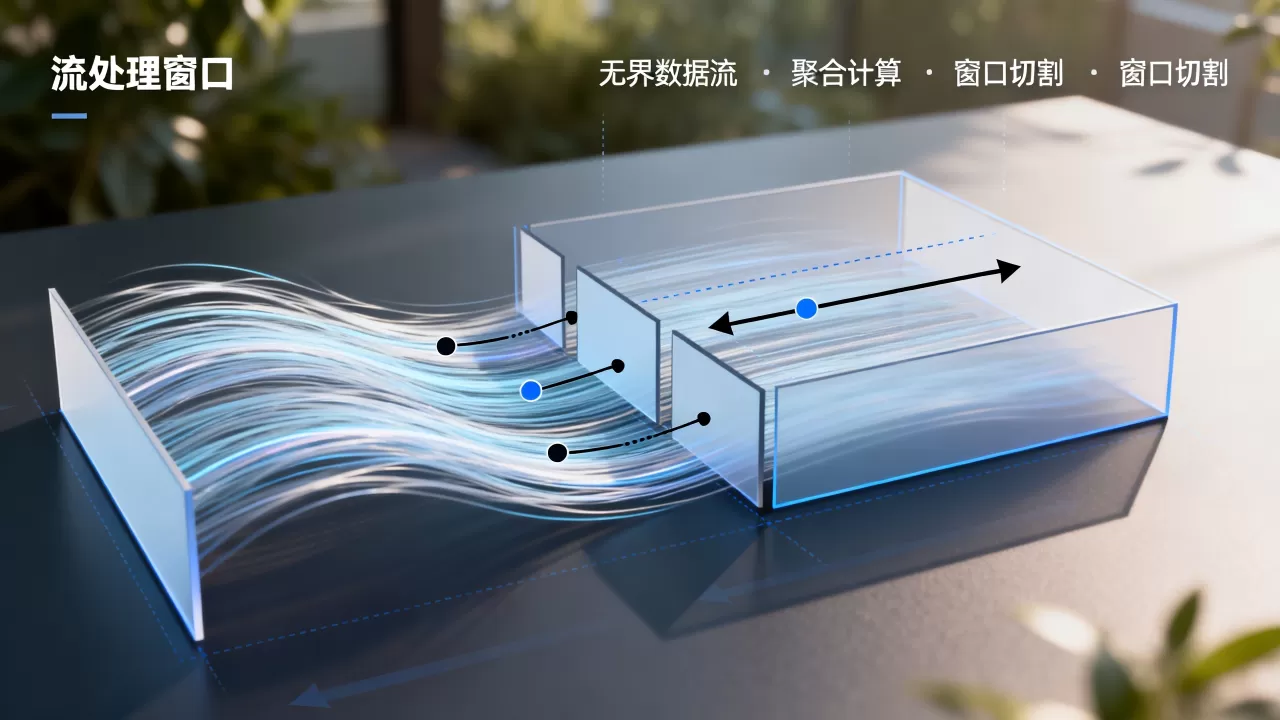
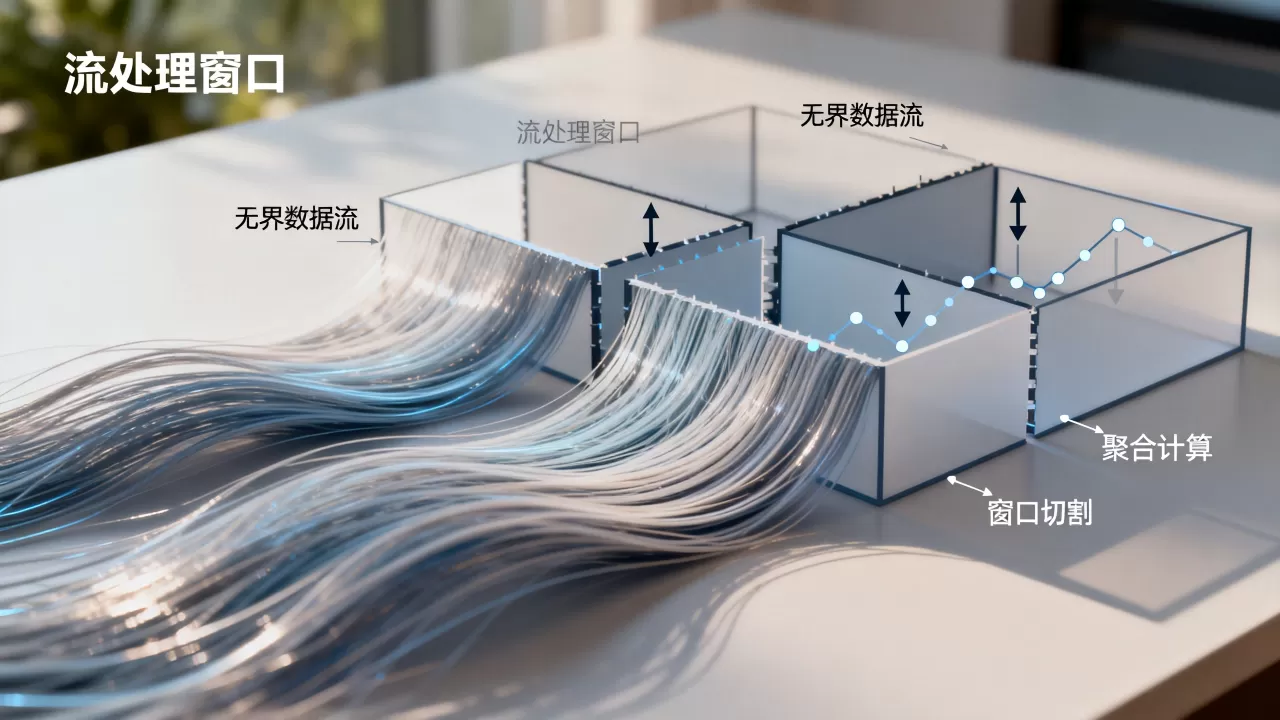
窗口机制把没有终点的事件流按时间长度或事件数量切成一段段有界数据,再对每段做聚合计算,这是实时流处理控制状态规模和拿到及时结果的核心手段。
流处理窗口机制怎么切分无界数据流
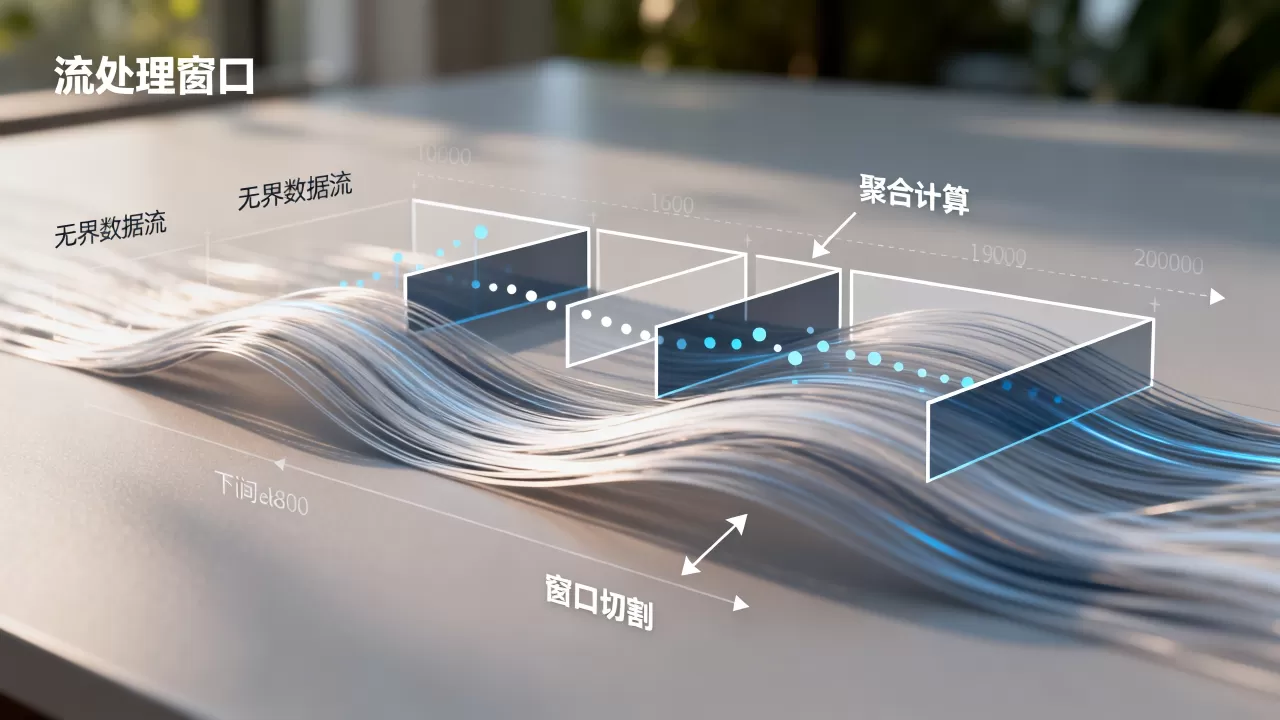
无界数据流没有终点,事件会一直产生,窗口的作用就是给这条无限流画上临时边界,窗口分配器负责切分,常见切分方式有三种:
- 按时间切分:每固定时间长度一段,比如每5分钟一个窗口。
- 按数量切分:每固定事件条数一段,比如每1000条事件一个窗口。
- 按会话切分:事件之间间隔超过阈值就切新窗口,比如用户停止操作30秒后关闭一段会话。
在Flink里操作路径很清晰:先定义流,再按业务键分组,再分配窗口,最后写聚合函数,下面是一段可运行的滚动窗口代码:
stream.keyBy(e -> e.getUserId())
      .window(TumblingEventTimeWindows.of(Time.minutes(5)))
      .sum("amount");
这段代码按用户ID分组,把事件流切成5分钟滚动窗口,再对每个窗口内的金额求和。
切分只是第一步,窗口什么时候触发计算同样关键,事件时间模式下,数据可能乱序到达,需要用水位线推进窗口关闭,水位线是一条特殊标记,告诉算子小于该时间的数据已经到齐,水位线越过窗口结束时间时,窗口触发聚合,随后状态被清理。
业内专家指出,窗口设计先要回答三个问题:按什么切、切多大、多久算一次,这三个答案决定延迟、吞吐和结果精度。
事件时间与水位线怎么配合
事件时间是最贴近业务真实发生时间的方式,但网络抖动、设备上报延迟都会导致乱序,水位线机制允许窗口等待一小段时间再关闭:
- 水位线等于当前最大事件时间减去允许乱序时间。
- 水位线是单调递增的。
- 窗口结束时间小于水位线时,窗口触发。
- 触发后迟到事件默认被丢弃,也可通过旁路输出单独处理。
滑动窗口和滚动窗口的区别与选型
滑动窗口和滚动窗口的区别,核心看长度和步长的关系,滚动窗口长度等于步长,数据不会重叠;滑动窗口长度大于步长,同一条数据会同时落在多个窗口里。
| 窗口类型 | 长度 | 步长 | 是否重叠 | 典型场景 |
|---|---|---|---|---|
| 滚动窗口 | 固定 | 等于长度 | 不重叠 | 固定周期报表 |
| 滑动窗口 | 固定 | 小于长度 | 重叠 | 实时大屏、趋势监控 |
| 会话窗口 | 可变 | 不固定 | 不重叠 | 用户行为分析 |
选型有个简单判断方法:实时监控要平滑曲线,用滑动窗口;按固定周期出报表,用滚动窗口;用户行为断断续续,用会话窗口。
为什么滑动窗口状态占用更大
因为滑动窗口有重叠,一条数据会参与多个窗口的计算,比如窗口长度15分钟、步长5分钟,一条数据会被3个窗口引用,窗口状态需要保留到最后一个引用窗口关闭才能清理,所以滑动窗口的状态占用和计算开销普遍高于滚动窗口,步长越小,重叠越深,状态越大。
Flink SQL 窗口聚合实战步骤
Flink SQL是上手窗口聚合最快的方式,先建表并声明事件时间和水位线:
CREATE TABLE bid_events (
  bidder_id STRING,
  bid_price DOUBLE,
  event_time TIMESTAMP(3),
  WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'bid_events',
  'format' = 'json'
);
这里水位线容忍5秒乱序,接着用滚动窗口SQL统计每个竞价方5分钟内出价总额:
SELECT
  bidder_id,
  TUMBLE_START(event_time, INTERVAL '5' MINUTE) AS win_start,
  SUM(bid_price) AS total_bid
FROM bid_events
GROUP BY bidder_id, TUMBLE(event_time, INTERVAL '5' MINUTE);
滑动窗口SQL用HOP函数,窗口1分钟,每10秒滑一次,适合看价格短时波动:
SELECT
  bidder_id,
  HOP_START(event_time, INTERVAL '1' MINUTE, INTERVAL '10' SECOND) AS win_start,
  AVG(bid_price) AS avg_price
FROM bid_events
GROUP BY bidder_id, HOP(event_time, INTERVAL '1' MINUTE, INTERVAL '10' SECOND);
会话窗口SQL用SESSION函数,超过30秒无事件,窗口关闭:
SELECT
  bidder_id,
  SESSION_START(event_time, INTERVAL '30' SECOND) AS session_start,
  COUNT() AS event_cnt
FROM bid_events
GROUP BY bidder_id, SESSION(event_time, INTERVAL '30' SECOND);
这些SQL可以直接在Flink SQL客户端跑,本地测试时把Kafka连接器换成print或datagen,先验证窗口边界是否符合预期。
实时竞价流量窗口聚合场景与价格监控
实时竞价里,广告请求和出价事件量很大,窗口把流量切成可管理的批次,广告系统常见需求是每5分钟统计每个广告位的曝光、点击、独立用户量,用滚动窗口做增量聚合,只保留中间结果,不保存明细:
- 曝光量:直接计数。
- 点击量:对点击标记求和。
- 独立用户:用近似去重函数,比如approx_count_distinct,大幅降低状态存储。
价格监控场景更细,生鲜平台看商品实时均价,判断短时波动是否需要调价,用滑动窗口,窗口10分钟,步长30秒,只计算窗口内均价、最高价、最低价,行业共识认为,滑动窗口在价格监控里比滚动窗口更合适,因为结果平滑,不会因窗口边界跳动产生毛刺。
增量聚合和全量聚合怎么选
增量聚合只保留中间结果,来一条数据更新一次状态,全量聚合把窗口内所有数据都存下来,窗口关闭时再统一计算,流处理窗口聚合默认走增量路线,状态占用小、输出快,只有需要窗口内全部明细才能算的指标,才考虑全量聚合,比如中位数、排序类指标。
北京实时流处理窗口应用怎么落地
北京地区实时公交是流处理窗口的典型落地场景,GPS数据从公交车上持续上报,字段包括线路ID、车辆ID、站点ID、时间戳,落地步骤可以拆成下面五步:
- 把GPS上报接入Kafka,按线路ID分区。
- 在Flink中按线路ID和车辆ID做keyBy。
- 分配5分钟滚动窗口,聚合车辆到站时间、车辆数。
- 把结果写入Redis,Key为线路加站点,Value为预计到站时间。
- 乘客端按站点查询Redis,拿到分钟级到站结果。
这个场景不需要精确到秒,5分钟窗口足够,窗口内车辆位置变化被压缩成一条到站预测,GPS信号在隧道、高楼遮挡下可能迟到,水位线可以设置30秒容忍,多数车辆到站时间可稳定在分钟级,适合用事件时间加水位线处理乱序。
无界流的聚合难题,本质就是“先切有界再算”,窗口不是限制,是给流计算加上节奏,选对切分方式,实时系统才能把状态控住、把结果及时交出来。
Q&A
流处理窗口机制怎么切分无界数据流?
窗口分配器按时间长度、事件数量或会话间隔把无限流切成有界块,事件时间模式下依赖水位线判断窗口关闭,水位线超过窗口结束时间就触发聚合。
Flink滑动窗口和滚动窗口哪个更适合实时大屏监控?
实时大屏更适合滑动窗口,窗口长度大于滑动步长时结果重叠,曲线更平滑,滚动窗口边界处容易跳变,适合固定周期报表。
会话窗口没有数据时怎么触发?
会话窗口在事件间隔超过设定的gap后触发,比如gap设30秒,最后一条事件后30秒无新事件,窗口关闭并输出聚合结果,如果持续有事件且间隔小于gap,窗口会一直合并,直到超过gap才关闭。