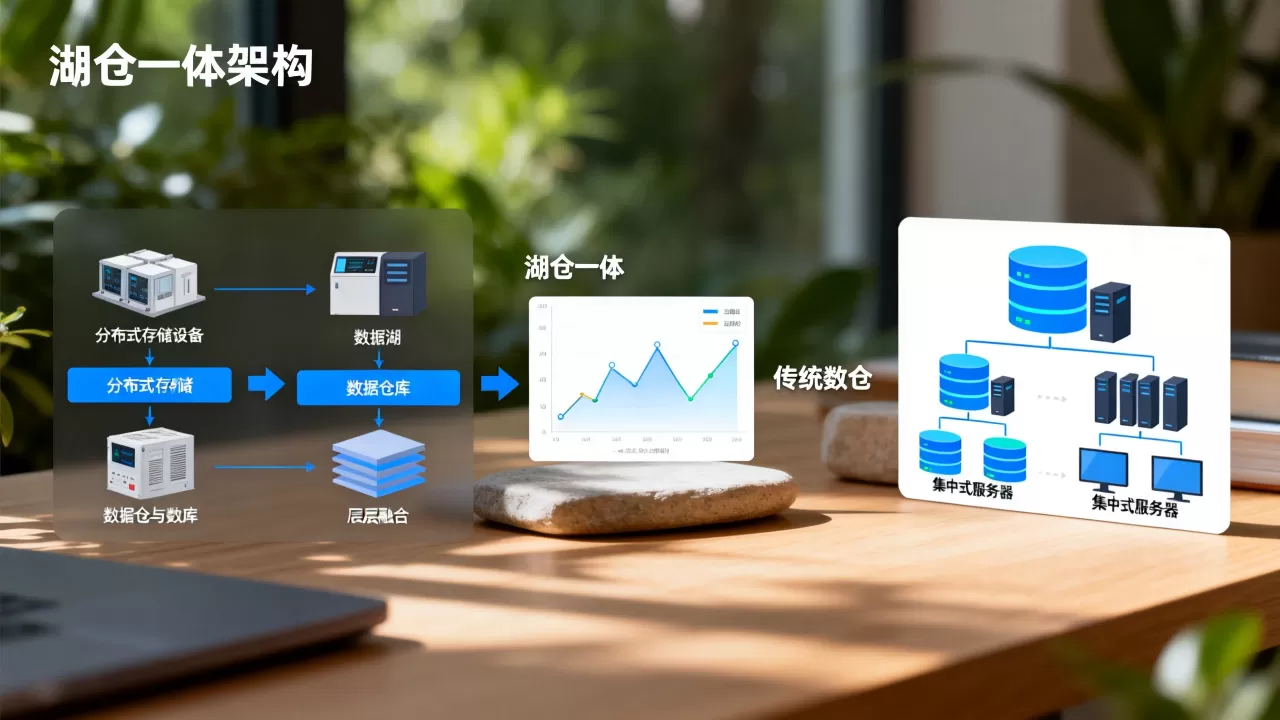
湖仓一体与传统数仓架构的差异,核心在于扩展性的路线不同:传统数仓以纵向扩展为主,扩容成本高且容易触碰架构天花板;湖仓一体基于存算分离与对象存储,天然支持横向弹性扩展,计算和存储可以独立伸缩。
湖仓一体和传统数仓的区别为什么集中在扩展性
很多技术决策者纠结湖仓一体和传统数仓的区别,其实最值得关注的不是功能清单,而是扩展性,功能差异可以通过工具补,扩展性不行,它是架构基因决定的。
传统数仓的扩展瓶颈藏在架构耦合里
传统数仓尤其是MPP一体机,存储和计算通常绑在同一套节点里,要增加计算能力,必须同时增加存储节点;要扩大存储,又不得不为多余的计算付费,这种耦合带来三个典型问题。
- 扩容需要数据重分布,大表迁移动辄数小时甚至数天。
- 硬件型号强绑定,买新节点可能因为旧型号停产而被迫整体升级。
- 弹性不足,夜间跑批和白天查询无法共享同一套资源池,只能按峰值配置资源。
举个例子,某企业用传统数仓跑日报,白天查询并发很低,夜间ETL任务却把CPU打到接近满载,想削峰填谷,架构上做不到,只能长期为峰值买单,这不是运维能力问题,是扩展性设计缺陷。
湖仓一体的扩展性来自存算分离底座
湖仓一体的底层存储通常是对象存储,比如S3、OSS、MinIO,计算引擎则通过开放表格式读取数据,存储和计算之间没有硬件绑定关系。
- 存储容量不够,直接扩容对象存储桶,不需要迁移已有数据。
- 计算资源紧张,新起一批计算节点,挂载同一份数据即可参与任务。
- 高峰结束后释放计算节点,存储保持不变,成本自然降下来。
业内专家指出,存算分离让湖仓一体在资源调度上获得了传统数仓难以实现的灵活性,这个灵活性的代价是元数据层和缓存层必须做扎实,否则扩展后性能会波动。
湖仓一体扩展性怎么样:从存储到计算的操作拆解
光说概念不够,落到实操层面才清楚,以下步骤以开源栈Spark + Iceberg + MinIO为例,展示湖仓一体扩展性的具体操作路径。
存储层扩容:对象存储的天然横向能力
对象存储扩容通常不需要停机,也不需要重分布数据,MinIO场景下,假设原有4个节点,现在要加到6个节点。
- 在新节点安装MinIO二进制文件,配置相同的访问密钥和区域。
- 将新节点IP加入现有集群的启动参数,执行
minio server http://node{1...6}/data。 - 集群会自动进行数据再平衡,旧数据逐步分布到新节点。
这种扩展方式对上层计算引擎完全透明,Spark作业不需要修改任何表路径,Iceberg元数据里的文件位置保持不变。
计算层扩缩容:以Spark + Iceberg为例的配置步骤
计算层扩展更直接,假设夜间跑批需要更多executor,白天查询需要减少占用,可以借助Spark的动态资源分配。
在spark-defaults.conf中设置:
spark.dynamicAllocation.enabled true
spark.dynamicAllocation.minExecutors 2
spark.dynamicAllocation.maxExecutors 50
spark.shuffle.service.enabled true
这样Spark会根据pending任务数量自动申请或释放executor,由于Iceberg表存储在对象存储上,新executor起来后直接从存储读文件,不需要等数据分发。
如果使用Kubernetes部署,还可以配置HPA,让Pod数量随CPU使用率自动伸缩。
元数据与权限扩展:不拖后腿的关键
扩展性不只是计算和存储,元数据服务同样要能扛住,Iceberg的catalog如果使用Hive Metastore,高并发下容易出现单点瓶颈。
- 将catalog切换为REST catalog,把元数据请求分散到多个服务实例。
- 对元数据存储使用分布式数据库,比如TiDB或CockroachDB。
- 权限校验下沉到对象存储层,减少每次查询对中央权限服务的依赖。
这些操作能避免扩容计算节点后,元数据服务反而成为新瓶颈。
湖仓一体价格与北京地域部署对扩展性的实际影响
不少团队关心湖仓一体价格,这直接影响扩展决策,开源湖仓一体本身软件免费,但部署形态不同,价格模型差异很大。
开源方案的成本结构
- 存储成本:对象存储按量付费,扩容即增加使用量,没有一次性硬件投入。
- 计算成本:按需启动集群,夜间跑批用竞价实例或Spot实例可以进一步拉低单价。
- 网络成本:跨可用区访问会产生流量费用,同地域内通常较低。
相比之下,传统数仓的授权费和硬件维保费用在扩容时往往会同步上涨,而且是一次性支出。
北京湖仓一体部署的多可用区扩展差异
以北京地域为例,对象存储服务通常支持跨可用区冗余,部署湖仓一体时,计算集群可以分布在多个可用区,但存储桶建议使用同地域冗余即可。
- 如果计算节点集中在一个可用区,存储桶选择同地域单可用区,读取延迟最低。
- 如果计算节点跨可用区部署,存储桶需要开启跨可用区复制,费用会上升。
- 扩展时优先增加同一可用区的计算节点,避免跨区数据拉取带来的额外延迟。
这种地域细节会直接影响扩展后的查询性能,很多团队扩容后感觉“变慢了”,其实不是湖仓一体架构不行,而是节点和存储桶的位置关系没配好。
常见扩展性故障排查与避坑
扩展性不是无限正向的,操作不当会踩坑,下面两个问题在实际项目中相当普遍。
小文件过多拖慢扩展后的查询
湖仓一体写数据时,如果每个批次都产生大量小文件,计算节点扩容后扫描开销会非线性上升,表现是加了节点后查询速度没有明显提升。
排查路径:
- 检查Iceberg表的
manifests数量,如果远大于数据文件总量的一定比例,说明小文件严重。 - 使用
spark.sql("CALL system.rewrite_data_files(table => 'db.table')")合并小文件。 - 调整写入策略,开启Iceberg的
write.distribution-mode=hash,减少小文件产生。
这个步骤每次扩容后都应该跑一遍,属于基础运维动作。
元数据服务成为瓶颈的表现与处理
当计算节点扩容到一定规模后,查询延迟突然增加,但CPU和存储负载都不高,多半是元数据服务扛不住了。
处理方式:
- 监控catalog服务的请求延迟和队列长度。
- 将元数据缓存到计算节点本地,减少重复拉取。
- 升级REST catalog实例数量,并在前面加一层负载均衡。
行业共识认为,湖仓一体的扩展性优势能否发挥出来,很大程度上取决于元数据层是否被单独优化,忽略元数据,只加计算节点,反而会放大瓶颈。
湖仓一体与传统数仓架构的差异主要体现在扩展性上吗
这个判断在多数场景下成立,传统数仓经过多年优化,在固定规模下性能可以非常稳定,但一旦业务数据量或并发出现数量级变化,扩展成本会快速上升,湖仓一体把存储和计算拆开,本质上就是为了让扩展从“大工程”变成“开关动作”。
数据仓库扩展性差怎么办
如果现有数据仓库扩展性差,不建议立刻推倒重来,可以先做存储计算分离改造,把冷数据迁移到对象存储,用开放表格式建一层逻辑表,再逐步把计算任务迁移到Spark或Trino,这样既保留原有数仓的查询能力,又为后续弹性扩展留出空间。
传统数据仓库扩展性为什么比湖仓一体弱
传统数据仓库的扩展性弱,根源在于存储和计算资源在设计上是绑定的,增加节点意味着同时增加存储和计算,而且数据需要在节点间重新分布,湖仓一体把数据放在对象存储里,计算节点可以随时挂载同一份数据,不需要迁移,因此扩展路径短得多,这是二者架构差异最直接的体现。
湖仓一体与传统数仓的差异,归根结底是扩展性上的代际差,传统数仓像固定体积的水池,扩容要重新砌墙;湖仓一体像接在公共水管上的容器,需要多少开多少,理解了这一点,选型时就不会被功能清单干扰,而是把架构弹性放在第一位。