流计算里的事件时间和处理时间,一个记录数据“真正发生”的时刻,一个记录系统“看到”数据的时刻;只要这两个时刻不一致,窗口、join、去重等结果就一定会出现偏差,偏差大小取决于数据乱序程度和延迟时长。
事件时间和处理时间的根本区别是什么
把两种时间语义比作财务单据最直观,事件时间像单据上的业务发生日期,处理时间像财务人员把单据录入系统的日期,即使录入晚几天,业务发生日期也不会改变,流计算中,事件时间由数据本身携带的字段表示,例如日志里的时间戳;处理时间则是Flink等引擎收到这条数据的墙钟时间。
字段来源不一样
- 事件时间:来自数据内部,需要提前定义,比如订单表里的
order_time。 - 处理时间:来自任务所在机器的系统时钟,不需要数据携带任何字段。
- 差异表现:同一批数据,换一台机器或任务重启,处理时间就会变。
为什么处理时间会让结果“看起来对但实际错”
处理时间最擅长制造假象,数据只要到了,就按到达顺序进入窗口,某用户在12:00下单,但日志延迟到12:05才到达,如果用滚动窗口按处理时间统计每分钟订单量,这单会被算进12:05,而不是12:00,看总量似乎差不多,实时大屏的曲线也很平滑,一旦业务方追问“12:00到底多少单”,结果就错了。
流计算事件时间处理时间哪个准
这个问题没有绝对答案,要看“准”的定义,从业务语义看,事件时间更接近真相;从系统开销看,处理时间更轻。
业务语义上事件时间更可信
订单、支付、风控、点击等场景里,用户行为发生时间才是业务真正关心的,业内专家指出,只要数据源自带可靠时间戳,优先用事件时间构建窗口,能避免网络抖动和反压带来的结果漂移。
工程落地中处理时间成本更低
处理时间不需要等待水位线,不需要处理乱序,窗口触发快,状态清理也简单,所以在实时计算平台价格敏感的日志统计分析中,仍有相当一部分作业使用处理时间,北京地区实时计算服务中的多数内部运营看板,也会在非核心指标上保留处理时间语义,以节省计算资源。
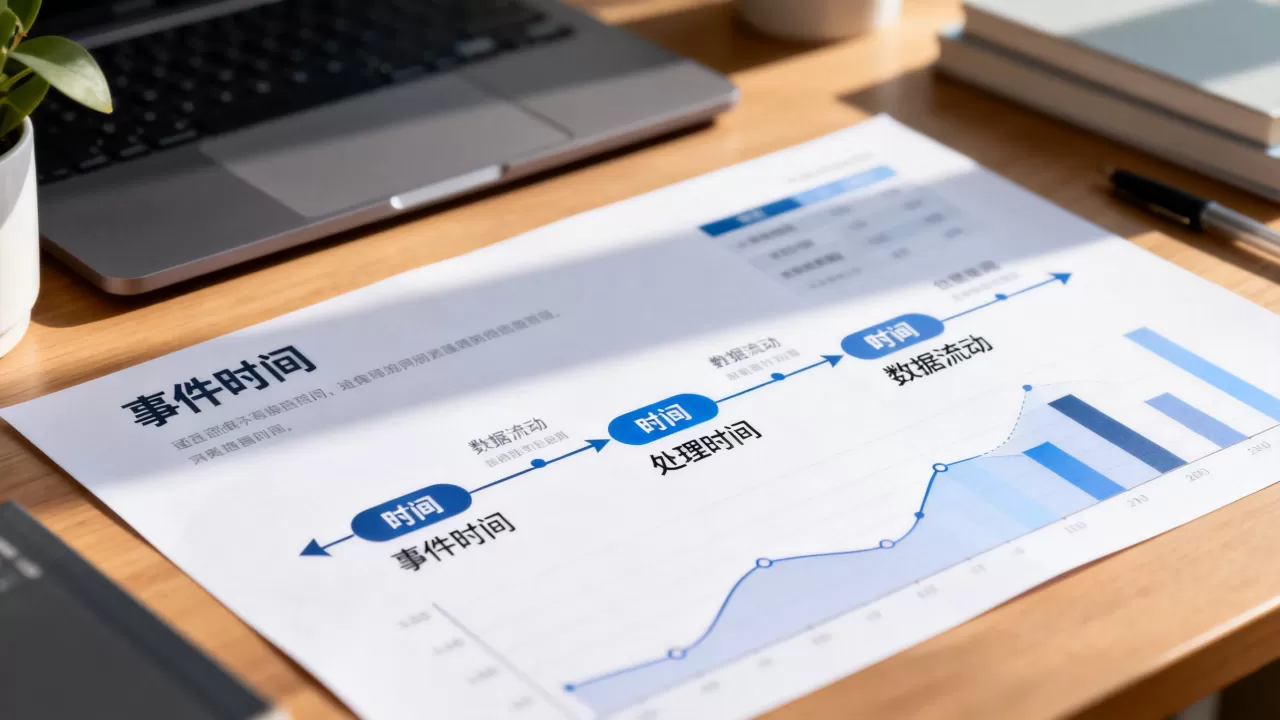
两者结果差异对比
| 对比项 | 事件时间 | 处理时间 |
|---|---|---|
| 计算依据 | 数据自带时间戳 | 系统接收时间 |
| 乱序容忍 | 可通过水位线等待 | 完全无感知 |
| 结果可复现性 | 较强 | 较弱 |
| 窗口触发延迟 | 可能更慢 | 更快 |
| 额外资源开销 | 较高 | 较低 |
行业共识认为,只要业务允许秒级或分钟级结果回退,就应该向事件时间靠拢。
实时计算为什么会出现数据延迟
数据延迟不是故障,而是分布式系统的常态,网络抖动、上游背压、日志采集积压、客户端时钟偏移都会导致数据晚到,事件时间正是为了应对这种“晚到”,而处理时间则假装它不存在。
乱序数据的典型来源
- 移动端弱网下先发送的请求后到达。
- Kafka多分区并行消费导致同一业务时间的数据被打散。
- 数据库CDC链路中,大事务提交后才一起下发。
- 服务器时钟不同步,部分数据时间戳本身偏移。
操作路径:怎么用事件时间接住延迟数据
在Flink中,通常需要三步:
- 定义时间特征为事件时间,例如使用
TimeCharacteristic.EventTime。 - 从数据中提取时间戳,实现
TimestampAssigner,指定哪个字段是业务时间。 - 设置水位线策略,例如使用
WatermarkStrategy.forBoundedOutOfOrderness,允许30秒乱序。
这样作业会等待水位线推进,迟到的数据只要在允许范围内,仍会进入对应窗口。
水位线是怎么把延迟量化出来的
水位线可以理解为一个不断前进的“截止时间”,它告诉窗口:“所有早于这个时间的数据,我基本都等过了,可以关窗了。”如果水位线设置过短,迟到数据会被丢弃;设置过长,结果输出延迟变大。
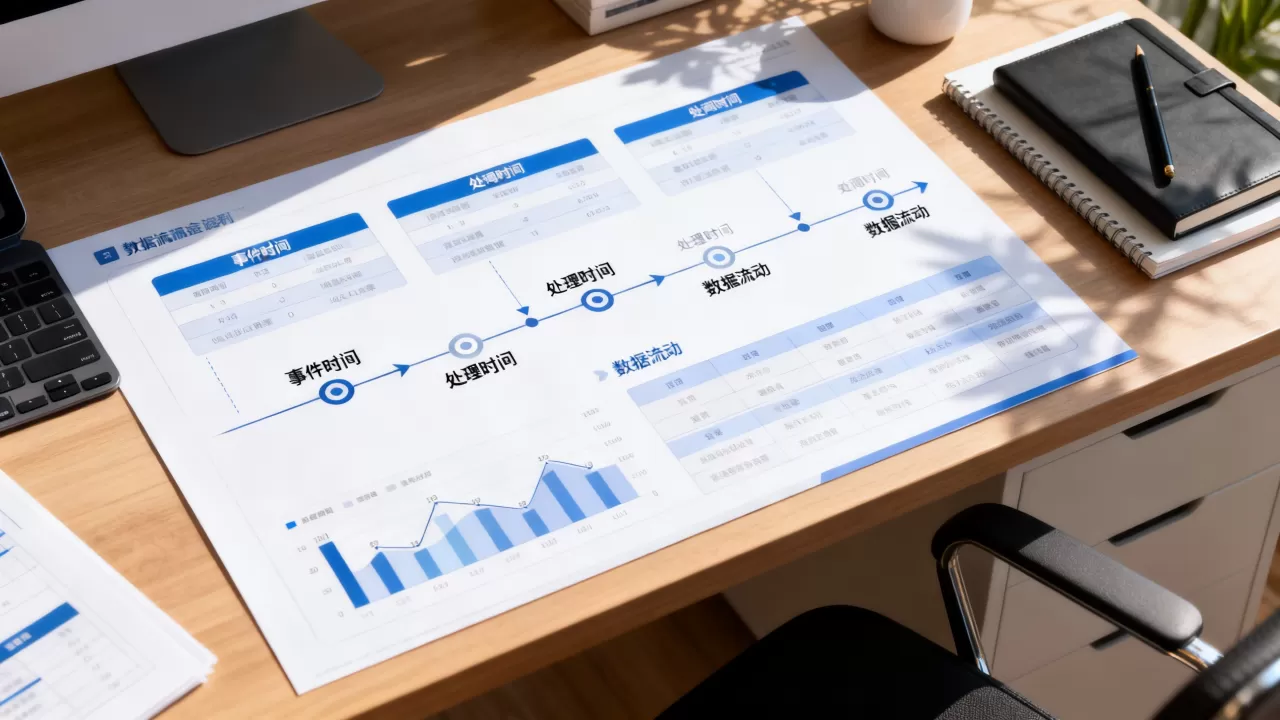
不同时间语义会让哪些计算结果产生偏差
乱序数据就像迟到的快递,处理时间按签收时间统计包裹量,事件时间按发货时间统计包裹量,两者在热销时段会画出完全不同的曲线。
滑动窗口下的错位聚合
以5分钟长度、1分钟滑动距离的窗口为例,某条数据事件时间为10:00:10,到达时间为10:06:20,处理时间会把它放入10:06窗口,事件时间会放入10:00-10:05窗口,滑动窗口不断重叠,一条错位数据可能污染多个统计结果。
双流join时偏差会被放大
订单流和支付流做间隔join时,如果使用处理时间,订单数据和支付数据分别按各自到达时间配对,一旦两条流延迟不同,原本同一笔交易的记录会落入完全不同的时间区间,事件时间通过各自携带的交易时间戳,才能把两边对齐。
去重和计数场景更隐蔽
按处理时间做实时UV统计,同一个用户短时间内触发多次事件,可能被分到两个相邻窗口,事件时间下,这些事件仍会被归到用户真实操作那一刻,偏差不会告警,但会持续拉低数据质量。
| 数据场景 | 事件时间 | 处理时间 | 结果差异 |
|---|---|---|---|
| 订单12:00产生,12:05到达 | 计入12:00窗口 | 计入12:05窗口 | 每分钟订单量错位 |
| 5分钟滑动窗口 | 进入10:00-10:05 | 进入10:05-10:10 | 同一数据污染多个窗口 |
| 双流join | 按交易时间对齐 | 按各自到达时间对齐 | 同一笔交易join不上 |
怎么选择事件时间还是处理时间
选择不是非黑即白,更像在精度、成本和实时性之间做平衡。
先看业务能不能接受结果回退
交易对账、风控拦截、支付成功统计必须用事件时间,内部运营看板、粗略点击量统计可以用处理时间,判断标准很简单:如果一分钟后修正之前的数据,业务方能接受吗?不能接受,就选事件时间。
再看资源预算和实时计算平台价格
事件时间作业通常有更多状态、更长TTL、更复杂的水位线逻辑,计算资源消耗会比处理时间高,云上实时计算平台价格多按CU数量和运行时长计费,事件时间作业的CU使用量往往更高,预算有限时,可以先对非核心链路保留处理时间,核心链路切换到事件时间,分阶段迁移。
实际操作建议
- 新项目从一开始就定义统一的事件时间字段。
- 使用
allowedLateness处理水位线之后到的小部分迟到数据。 - 对超时数据输出到侧输出流,避免静默丢弃。
- 持续监控“事件时间-处理时间”的延迟分布,调整水位线。
- 北京地区实时计算服务中的多数生产集群会把水位线延迟设置在10秒到60秒之间,具体值取决于上游乱序程度。
事件时间和处理时间的偏差,本质上是对“什么时候发生”和“什么时候知道”两种时间观的混淆,流计算中只要数据迟到、乱序、跨分区存在,处理时间就会悄悄改写业务事实,想让大屏、指标、策略经得起追问,事件时间是默认选择;想快速上线且资源敏感,处理时间可以用于粗粒度和非核心场景,关键不是消灭偏差,而是让偏差被看见、被度量、被业务接受。
事件时间与处理时间常见问题
事件时间和处理时间区别是什么?
事件时间由数据本身的时间戳决定,处理时间由任务所在机器接收数据时的系统时间决定,事件时间可以复现业务发生顺序,处理时间只能反映系统消费顺序。
实时计算为什么会出现数据延迟?
网络波动、Kafka多分区消费、上游日志积压、客户端时钟不同步都会造成数据延迟,延迟会让处理时间窗口错位,因此实时计算需要水位线等待迟到数据。
流计算事件时间处理时间哪个准?
从业务语义看,事件时间更准;从资源开销看,处理时间更省,准不准取决于业务能否容忍结果统计在错误的时间窗内,金融风控等场景即使增加实时计算平台价格成本,也必须采用事件时间语义。