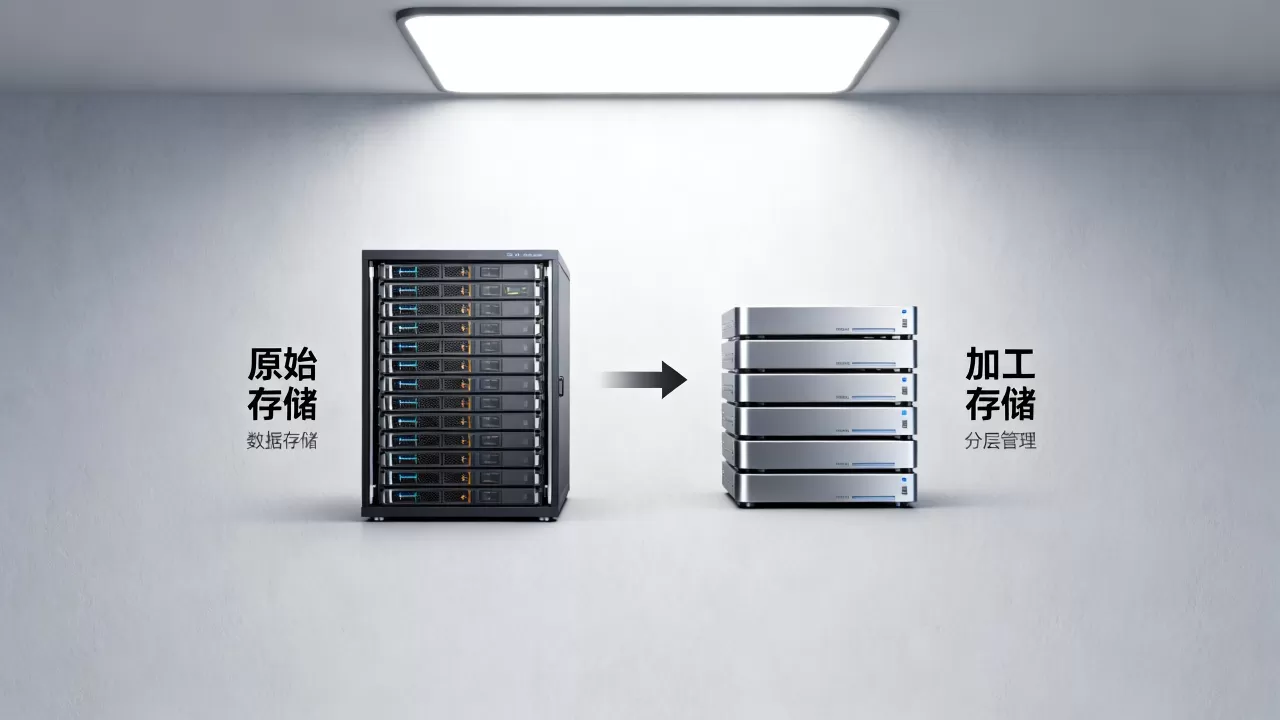
数据湖原始存储与加工存储必须分开管理,这是避免下游数据污染、保住数据血缘可信度的最低成本手段。 混在一起省下的那点目录规划时间,会在后续每次重算、审计、故障排查时加倍还回来。
数据湖原始层和加工层为什么要分开?先看一次典型的污染链路
数据湖不像传统数仓有严格的 schema 约束,原始数据进湖时往往带着重复、缺失、格式错乱甚至测试数据,如果这些数据直接进入加工层,下游的 BI 报表、推荐模型、风控规则都会跟着遭殃。
- 原始层数据来源多:埋点日志、数据库 binlog、第三方 API 推送、手工上传文件。
- 加工层数据要可用:去重、补齐、标准化、关联维表。
- 混用的常见后果:原始表被 ETL 任务反复覆盖,导致重算时源数据已经变了,结果对不上。
一个电商大促场景下的真实坑:压测流量混进点击日志,如果采集直接写入加工层,运营大屏的转化率当晚就会虚高,等发现时,加工层已经被污染,只能回滚整个分区,甚至重跑全量任务。
行业共识认为,数据湖分层管理不是架构洁癖,而是数据治理的基本动作,原始层只追加、不修改;加工层允许覆盖、重算,但必须有明确的写入边界。
数据湖原始数据区污染怎么解决?目录、权限、生命周期三步走
解决污染不是靠喊口号,而是靠三件事:目录规划、权限隔离、生命周期策略。
第一步:把目录边界变成物理边界
在对象存储或 HDFS 上,至少要有这四个区域:
raw/:原始数据区,保持数据原样,按日期/来源分区。staging/:临时中转区,数据质量校验通过前先放这里。processed/:加工数据区,存放清洗、标准化后的数据。curated/:业务就绪区,面向具体分析场景的聚合宽表。
操作路径示例(以 S3 兼容存储为例):
s3://datalake/raw/events/2026/01/01/
s3://datalake/staging/events/2026/01/01/
s3://datalake/processed/events/2026/01/01/
s3://datalake/curated/events/2026/01/01/
原始层和加工层一旦在路径上分开,后续的权限、备份、生命周期策略才有附着点。
第二步:用权限隔离防止“手滑写入”
多数数据湖污染不是恶意攻击,而是权限太宽导致误操作,具体做法:
- 采集账号只授予
raw/和staging/的写入权限,不给processed/任何写权限。 - ETL 服务角色可以读
raw/,但只能写processed/,不能反向写raw/。 - 数据分析师只读
curated/和部分processed/,默认无raw/访问权限。 - 使用 AWS Lake Formation 或 Apache Ranger 做库表级授权,而不是只靠存储桶策略。
一条可验证的命令:在 HDFS 上给原始层目录设置只追加权限,禁止删除和重命名。
hdfs dfs -chmod 1777 /datalake/raw/events
1777 权限位中的 sticky bit 可以防止非所有者删除文件,适合原始数据区的只进不出策略。
第三步:给原始层和加工层设置不同的生命周期
原始层数据通常只增不减,加工层数据需要频繁读取和重算,两者保留周期和存储类型必须分开。
| 区域 | 存储类型 | 典型保留周期 | 访问频率 | 删除策略 |
|---|---|---|---|---|
| raw/ | 冷归档/低频 | 按合规要求,一般 6 个月以上 | 低 | 仅允许归档后删除 |
| staging/ | 标准/低频 | 3-7 天 | 中 | 校验通过后清理 |
| processed/ | 标准/低频 | 30-90 天,按分区覆盖 | 高 | 按分区 TTL 删除 |
| curated/ | 标准/高频 | 按业务需求长期保留 | 高 | 人工审批后下线 |
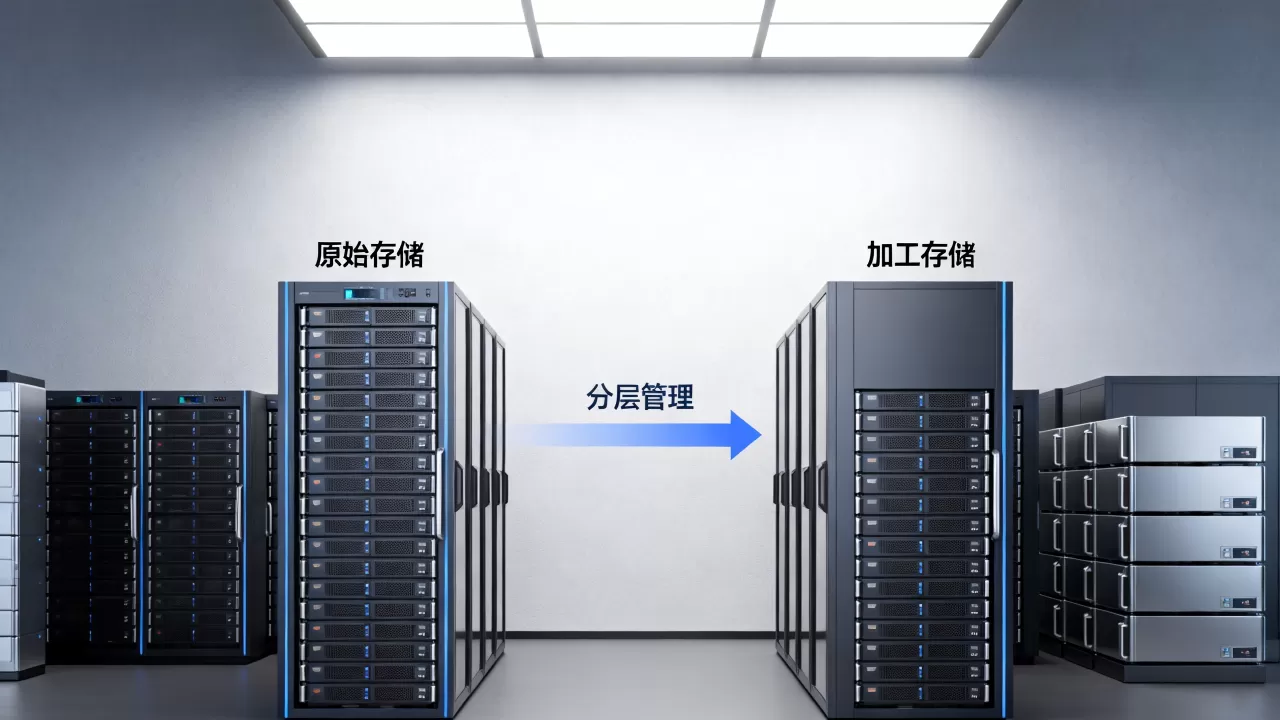
原始数据区和加工数据区的生命周期策略如果混在一起,要么原始数据被过早清理,要么加工数据占着标准存储白白烧钱。
数据湖分层存储成本优化方案:分开管理不一定要多花钱
不少企业担心分开管理会增加存储成本,分开管理才能做精细化的成本控制,原始层访问频率低,完全可以走冷归档;加工层需要频繁读写,保留标准或低频存储,混在一起时,为了加工层性能,整个湖都按标准存储付费,反而更贵。
- 原始层用对象存储的生命周期规则,30 天后自动转低频,90 天后转归档。
- 加工层按分区粒度设置 TTL,过期分区自动删除,避免无限膨胀。
- 临时中转区
staging/设置 3 天过期,杜绝“临时文件永久化”。
一条典型的 S3 生命周期 XML 片段(示意):
<Rule>
  <Filter>
    <Prefix>raw/</Prefix>
  </Filter>
  <Status>Enabled</Status>
  <Transition>
    <Days>30</Days>
    <StorageClass>STANDARD_IA</StorageClass>
  </Transition>
  <Transition>
    <Days>90</Days>
    <StorageClass>GLACIER</StorageClass>
  </Transition>
</Rule>
这个规则只作用于 raw/ 前缀,不会影响 processed/ 的存储策略。
上海企业数据湖建设方案中的分层落地:合规与效率平衡
海为代表的一线城市,金融、零售、制造企业对数据湖的合规要求更高,原始凭证类数据必须留存,加工数据要支持审计追溯,分开管理能同时满足这两头。
- 合规侧:原始层保留入湖时的原始文件哈希值,加工层保存转换逻辑版本号,审计时能回溯“这份报表从哪批原始数据来”。
- 效率侧:数据分析团队只接触
curated/
,不用在原始堆里翻找,查询性能也更稳定。
- 地域实践:上海企业数据湖建设方案中,通常会把
raw/放在同城备份的对象存储桶,processed/放在计算集群就近的标准存储,既满足数据安全要求,又控制网络延迟。
业内专家指出,数据湖原始层与加工层的分离程度,直接决定了一家企业的数据资产能走多远,混在一起的管理方式,最终都会在数据质量事故中被迫补课。
数据湖原始存储与加工存储分开管理,不是增加架构复杂度,而是把复杂度放在该放的地方。 用目录、权限、生命周期三把锁把污染挡在加工层之外,远比重建数据湖便宜。
Q&A:数据湖原始存储与加工存储分开管理常见问题
数据湖原始层和加工层可以放在同一个存储桶吗?
技术上可以,但不建议,同一个存储桶内必须用不同的前缀目录严格隔离,并且通过桶策略限制不同前缀的读写权限,如果权限策略做不到前缀级隔离,还是拆成两个桶更稳妥,绝大多数生产环境选择“一个湖一个桶,内部多级前缀”的方式,配合 IAM 策略做权限边界。
数据湖原始数据区污染已经发生,怎么应急处理?
先停止所有向加工层写入的任务,锁定污染分区,然后从原始层重新抽取未被污染的数据,覆盖加工层对应分区,如果原始层本身也被污染,需要回溯上游采集日志,找到污染开始时间点,删除该时间点之后的原始分区并重新采集,整个过程必须记录在数据质量平台中,避免二次污染。
数据湖原始层与加工层分开管理会增加多少成本?
分开管理本身不增加存储总量,只是把数据放在不同存储类型和生命周期策略下,多数情况下,原始层转冷归档后,整体存储成本反而会下降,增加的成本主要是前期目录规划和权限配置的人力投入,这部分投入与一次严重数据污染事故的恢复成本相比几乎可以忽略。