通用服务器完全能胜任轻量推理任务,但前提是明确“轻量”的边界,别拿它跟专用GPU硬碰硬。多数情况下,80%以上的常规推理场景,通用服务器不仅跑得动,而且性价比更高,只是需要你在配置、框架和并发策略上多花点心思。
通用服务器和专用推理机的真实差距在哪
很多人一听到“推理”就下意识想到GPU,觉得没有显卡就干不了AI的活儿,这种认知对纯推理场景来说,多少有点被训练任务带偏了。
推理和训练是两码事
训练是“喂数据、调参数”,吃的是并行算力,GPU的几千个核心在矩阵运算上有天然统治力,推理是“用训练好的模型回答问题”,吃的是延迟、吞吐量和内存带宽,计算量比训练小好几个量级,通用服务器的CPU完全可以扛下来,差别只在快和慢。
通用服务器到底擅长什么
业内专家指出,一台配置合理的通用服务器,在轻量推理场景下的表现往往被低估,它的强项集中在三个维度:
- 模型体积小:百MB以内的模型,比如BERT-base、ResNet-50、蒸馏后的T5,CPU推理速度可以达到毫秒级响应。
- 并发要求适中:每秒几十到几百次请求,通用服务器配合多核并行完全可以应付。
- 延迟容忍度高:如果你的业务允许200-500毫秒的响应时间,通用服务器的性价比直接碾压GPU服务器。
通用服务器能跑推理模型吗?答案是肯定的,关键在于你别拿它去跑那些动辄几十GB的大语言模型,那是自己给自己找不痛快。
什么场景下通用服务器是更聪明的选择
判断标准很简单:你的模型用CPU跑一次推理需要多久,如果单次推理在100毫秒以内,通用服务器就是最优解;如果超过1秒,才需要考虑GPU加速。
轻量推理任务具体指哪些活儿
- 文本分类与情感分析:电商评论打标、舆情监控,这类任务模型普遍小巧,CPU推理毫无压力。
- 图像分类与目标检测:工业质检中的缺陷识别、安防场景的人脸检测,用轻量级网络(YOLO-tiny、MobileNet)在CPU上也能跑出不错的帧率。
- 推荐系统与Embedding检索:向量召回、粗排阶段的计算,本质上是矩阵乘法和相似度计算,通用服务器跑起来很顺手。
- 语音识别的前端处理:VAD、降噪等轻量任务,CPU完全能实时处理。
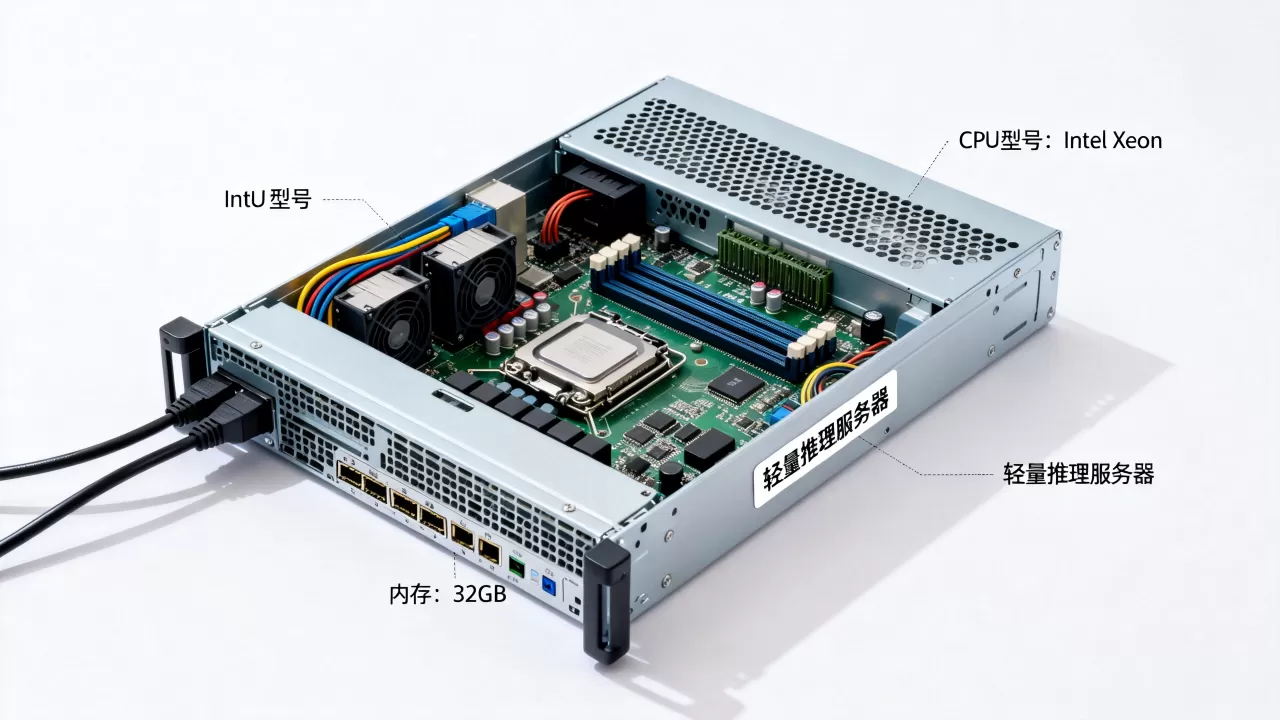
不推荐用通用服务器的硬指标
当模型参数量超过10亿,或者单次推理耗时超过2秒,又或者你追求的是高并发下的极低延迟(P99小于50毫秒),这时候建议老老实实上GPU服务器。
行业共识认为,推理场景的算力需求呈金字塔结构:真正需要GPU的重型任务只占20%左右,剩下的80%轻量场景,通用服务器+优化工具链才是高性价比路线。
轻量推理任务用什么服务器配置才能不踩坑
配置选不好,再好的CPU也白搭,通用服务器跑推理,瓶颈往往不在CPU核心数,而在内存带宽和指令集支持。
硬件选择的关键参数
| 硬件 | 推荐配置 | 理由 |
|---|---|---|
| CPU | Intel Xeon Silver 4314 或 AMD EPYC 7443 | 单核性能决定推理延迟,全核性能决定吞吐量 |
| 内存 | 至少32GB,推荐64GB DDR4 ECC | 模型权重要常驻内存,内存容量不够会频繁换页 |
| 硬盘 | NVMe SSD 1TB起步 | 模型加载速度快,避免每次冷启动等半天 |
| 网络 | 千兆网卡起步 | 推理服务的瓶颈往往在IO上,网络别省 |
部署时的性能优化五连招
通用服务器跑深度学习推理,不优化就白白浪费一半性能,以下几个操作,每一条都能带来肉眼可见的提升:
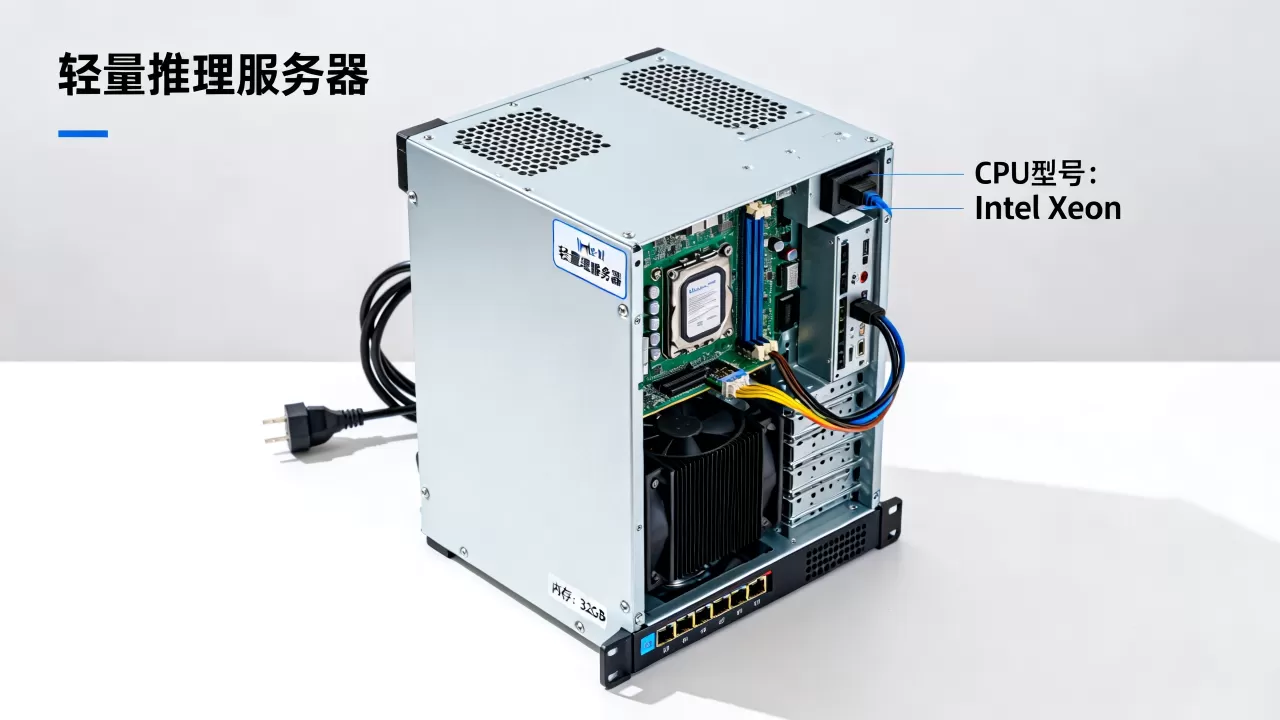
- 开启AVX-512指令集:现代Intel CPU的AVX-512能把矩阵运算速度拉高数倍,前提是你的推理框架编译时启用了它。
- 使用Intel OpenVINO或ONNX Runtime:这两个工具能把模型做层融合和算子优化,实测推理速度能提升2-5倍。
- 设置CPU亲和性:用
taskset命令把推理进程绑定到固定物理核心,避免上下文切换带来的抖动。 - 开启NUMA感知:大内存服务器上,内存访问跨Node会变慢,在BIOS和系统层面配置NUMA绑定后,性能提升约10%-15%。
- 模型量化到INT8:用校准集把FP32的权重转成INT8,精度损失通常在1%以内,但显存占用和计算量直接砍半,CPU推理速度翻倍。
实际部署一个BERT分类模型的完整流程
用Python的FastAPI加ONNX Runtime,在通用服务器上部署文本分类模型,操作路径非常清晰:
# 安装依赖
pip install fastapi onnxruntime uvicorn transformers
# 导出ONNX格式(提前做一次即可)
python -m transformers.onnx --model=bert-base-chinese onnx/
# 启动服务
uvicorn app:app --host 0.0.0.0 --port 8080 --workers 4
每个worker进程独立加载模型,4个worker就相当于4个并行的推理引擎,配合前端负载均衡,每秒处理200个请求很轻松。
通用服务器和GPU服务器怎么选才不会多花冤枉钱
价格因素在选型中权重极大,尤其是中小团队,每一分钱都要花在刀刃上。
成本对比一目了然
购机成本上,一台带两块中端GPU的服务器(比如RTX 4090双卡)至少需要6万元,而一台双路至强的通用服务器大约2万元出头。价格差距3-5倍。
营运成本方面,GPU服务器功耗普遍在800W以上,通用服务器控制在350W左右,一年电费差距按保守估计也有3000元朝上。
什么场景下通用服务器反而更稳
GPU服务器确实快,但不代表所有业务都适合迁移过去,以下情况,通用服务器反而是更好的选择:
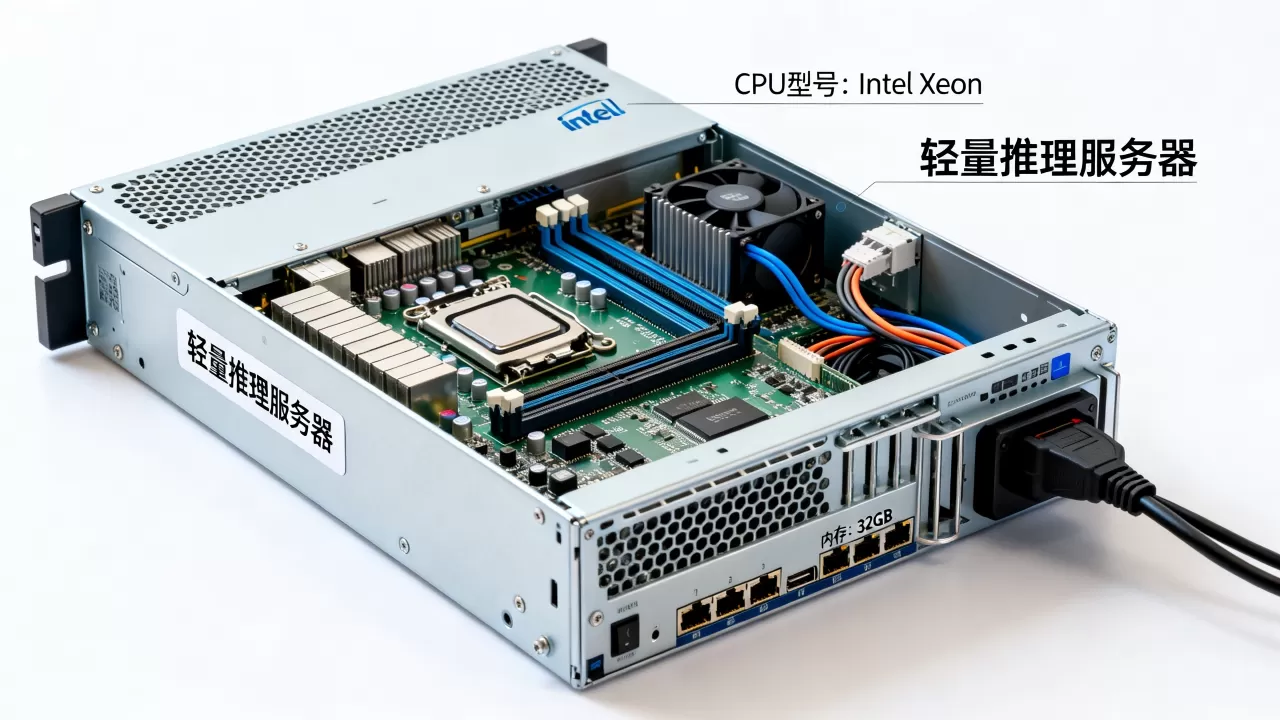
- 业务处于验证期:不确定模型上线后的调用量,先用通用服务器验证效果,等流量上来了再扩容,避免一开始就背上GPU的沉没成本。
- 模型迭代频繁:GPU服务器上的CUDA环境经常因为驱动、库版本冲突搞得焦头烂额,通用服务器的CPU环境几乎零兼容性烦恼。
- 算力需求波谷明显:白天高峰晚上闲置的场景,GPU的空闲成本太高,通用服务器即使闲置,损耗也小得多。
轻量推理的服务器选型,通用服务器在2万价位段的综合表现,比同价位的GPU方案靠谱得多这是一个看到真金白银电费账单后,很多团队都会认同的结论。
通用服务器跑推理任务常见问题解答
通用服务器的推理速度能赶上GPU吗?
差距是客观存在的,以ResNet-50为例,GPU单次推理约5毫秒,通用服务器约40-60毫秒,差了10倍左右,但如果你的业务是异步处理或允许批量排队,这个差距完全可以用并发手段抹平,真正需要PK的是单位成本的吞吐量,而不是单纯的单次延迟。
通用服务器最多能支持多大参数的模型?
稳定运行的上限大约是10亿参数,超过这个规模,CPU推理的延迟会突破秒级,响应体感明显变差,如果你跑的是7B、13B的大语言模型,需要配合量化技术,用llama.cpp这类CPU推理框架可以勉强运行,但只适合内部调试,不适合对外提供实时服务,通用服务器能跑推理模型吗?对百亿参数以上的回答是“能跑但不推荐”。
用通用服务器做推理服务的稳定性有保障吗
CPU设备比GPU更稳定,这是硬件特性决定的,GPU在高负载下的热节流和驱动崩溃问题,在CPU上几乎不会出现,配合Linux系统的systemd服务管理和supervisor进程守护,通用服务器的推理服务可以做到99.9%的可用性,只要做好模型的内存常驻和优雅退出机制,CPU推理服务比GPU方案更省心。