音视频直播转码下沉到边缘节点后,中心侧不再承担视频转码算力,只保留调度与分发职责,这能把回源带宽和首屏延迟明显压下来,但前提是边缘节点具备统一的任务下发、状态上报和故障切换机制。
边缘转码和中心转码哪个好:先拆开直播链路看瓶颈
直播链路里最容易被忽略的其实是转码位置,传统做法是主播把流推到中心机房,中心集群统一转出多路不同码率,再分发到CDN,这套链路在业务量小的时候很稳,但流量一大,问题就冒出来。
中心集中转码的链路为什么越来越吃力
- 主播推流到中心节点,经常跨省甚至跨国,RTT高,首屏和互动延迟很难压下去
- 转码集群集中在少数几个机房,晚高峰任务排队,转码等待时间变长
- 多码率输出会把中心机房的上行带宽吃满,回源成本变成一笔长期大账
- 中心集群一旦故障,影响面是全局的,所有直播间都会受牵连
业内专家指出,中心集中转码的核心矛盾在于:算力和带宽都向一个点集中,而直播观众和主播天然是分散的,这个矛盾没办法通过单纯加大中心机房规模来彻底解决。
转码下沉到边缘后中心只负责调度与分发,链路怎么变
边缘转码的思路很简单:把转码任务从中心搬到离主播更近的边缘节点,主播推流到附近边缘机房,边缘节点完成转码,转出来的多路流直接从边缘分发,或者回中心统一调度,中心不再碰视频数据,只做三件事:
- 决定哪个边缘节点接任务
- 把转码模板下发到边缘
- 把流索引和播放地址告诉观众
原来需要跨省回传多路转码流的带宽,现在只需要回传一路原始流或轻量信令,这个变化对延迟和成本的影响是实打实的。
一张表看懂差异
| 维度 | 中心集中转码 | 边缘转码下沉 |
|---|---|---|
| 转码位置 | 中心机房 | 靠近主播的边缘节点 |
| 回源带宽 | 多路转码流回传,压力大 | 一路原始流或信令,大幅减少 |
| 首屏延迟 | 跨省回传后再转码,偏高 | 就近转码,更低 |
| 中心压力 | 算力、带宽、状态全压在一处 | 只做调度与分发,压力分散 |
| 扩容方式 | 中心机房堆服务器,周期长 | 边缘节点横向增加,更灵活 |
| 故障影响 | 全局性 | 局部性,可快速切换 |
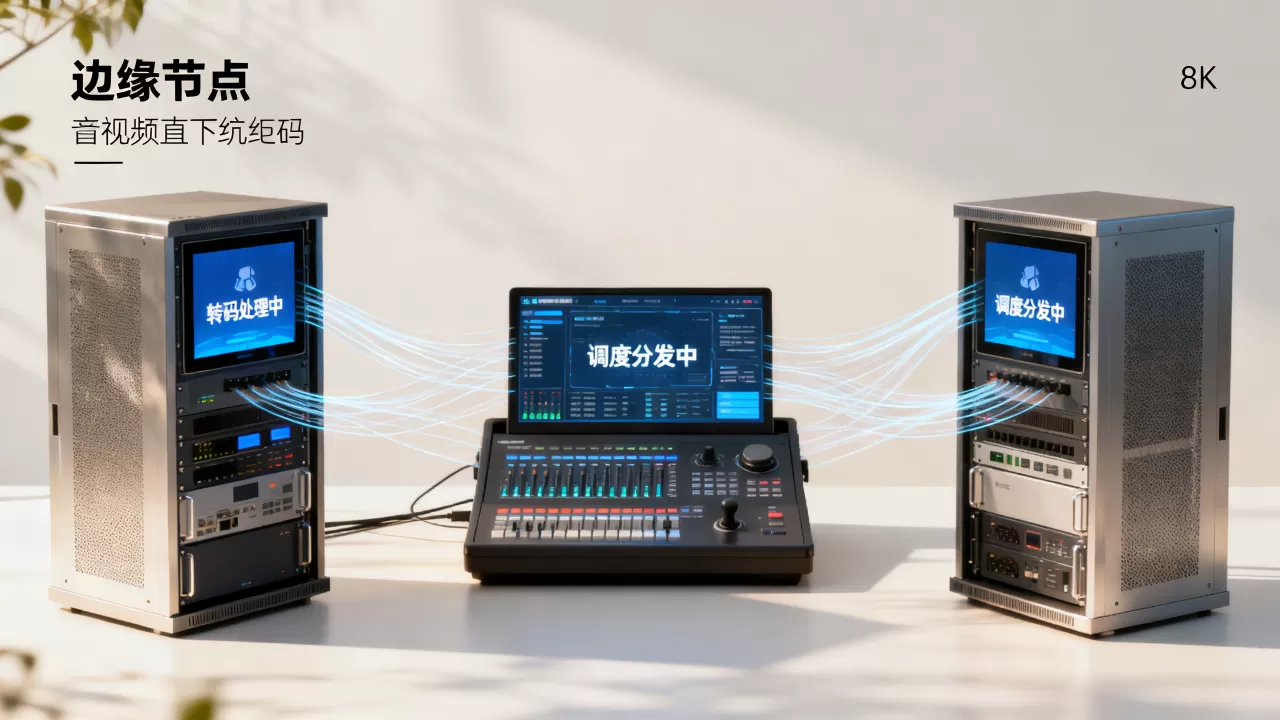
直播转码边缘节点部署方案:从选点到上线
部署方案不能只停留在架构图,真正落地时,边缘节点的选点、硬件选型、调度系统对接,每一项都会影响最终效果。
北京直播边缘节点怎么选:先看覆盖和运营商
如果目标观众大量集中在北京,边缘节点选在北京确实合理,但选北京节点不能只看地理距离,几个实操指标都要过一遍:
- 覆盖用户群:主力观众在北京及周边,优先选北京边缘机房,避免回源到外地
- 运营商互联:北京机房如果只有单线,跨运营商访问会明显变慢,BGP多线是基本要求
- 机柜电力:边缘转码常跑GPU服务器,功耗高,机房电力配额要先确认
- 到中心云的专线质量:边缘和中心之间的调度、状态同步依赖稳定链路,专线丢包率要控制在很低的水平
- 现场运维能力:边缘节点分散,是否有24小时值守或远程带外管理,直接决定故障响应速度
边缘转码服务器价格怎么算:按并发路数而非单一硬件
很多团队一上来就问某一台服务器多少钱,实际上这样算容易跑偏,边缘转码服务器价格受多个变量影响:
- 编码格式:H.264转码成本相对低,H.265或AV1对算力要求高,同样硬件能并发处理的路线数会下降
- 输出路数:一路1080P原始流转三路输出,和只转一路标清,占用的编码资源完全不同
- GPU型号:不同代次的GPU,单卡能承载的转码路数差异很大,直接拉高单节点投入
- 部署模式:裸金属自建、容器化部署、边缘云租赁,价格结构完全不一样
- 核算方式:不要只盯着服务器单价,要算每路并发转码成本,再乘以业务峰值路数
行业共识认为,边缘转码的硬件选型应该按业务峰值并发路数反推,而不是按机房机柜位去填设备,这样不容易出现资源闲置或高峰不够用的情况。
转码下沉后中心只负责调度与分发的实际配置路径
这部分最关键的是调度侧和边缘侧怎么配合,没有统一调度,边缘转码就会变成一堆各自为战的节点。
调度侧要做的三件事
- 维护边缘节点资源池:记录每个节点的算力规格、当前任务数、可用带宽、健康状态
- 根据主播位置和观众分布选择最优边缘节点:主播在北京就优先调度到北京边缘节点,观众集中在上海可以后续通过CDN分发
- 下发转码模板:分辨率、码率、编码格式、水印参数、HLS切片时长等都要由中心统一下发,避免边缘配置漂移
一条可落地的操作流
- 中心调度服务注册所有边缘节点,边缘每30秒上报一次负载和心跳
- 主播推流到达边缘接入层,边缘上报流ID、来源IP和原始码率
- 中心根据流所在区域匹配转码模板,向目标边缘节点下发转码任务
- 边缘节点通过FFmpeg或专用转码服务执行转码任务
- 转码后的流按策略推到CDN,或者直接由边缘分发到观众
- 中心更新流播放地址和状态,播放端从调度接口获取最优边缘拉流地址
边缘节点上的转码命令示例
以常见的FFmpeg为例,边缘节点收到中心下发的转码模板后,实际执行命令类似这样:
ffmpeg -i rtmp://edge-input/live/stream01
  -c:v libx264 -preset veryfast -b:v 2500k -s 1280x720
  -c:a aac -b:a 128k
  -f flv rtmp://edge-output/live/stream01_720p
这条命令从边缘输入地址拉取原始流,输出一路720p转码流,码率、分辨率、编码格式都由中心模板参数替换,边缘节点只负责执行和上报状态。
直播转码下沉边缘成本对比:别只看设备采购
中心模式的钱花在哪
- 中心机房GPU服务器集中采购,一次性投入高
- 多码率回源消耗大量骨干带宽,带宽成本长期居高
- 高峰扩容需要提前数月规划,扩容周期长
- 中心机房电力和制冷成本集中,单点成本不低
边缘模式的钱花在哪
- 分散在各地的边缘服务器或边缘云租赁费用
- 边缘节点之间的调度系统建设和维护成本
- 多点运维带来的监控、告警和差旅投入
- 回源带宽明显减少,首屏延迟收益带来用户体验提升
很多团队在算直播转码下沉边缘成本对比时,只看设备采购价,忽略了带宽和运维这两块,实际上边缘模式下,回源带宽成本通常能省下相当大一块,但这部分节省被分散的运维投入抵消掉一部分,最终算下来,是否划算取决于流量规模和业务分布。
容易踩的坑:边缘异构与状态不同步
边缘节点转码能力不一致怎么办
- 统一转码服务镜像,用容器化方式屏蔽底层GPU和驱动差异
- 调度时按节点真实算力打分,不按标称规格分配任务
- 保留兜底策略:边缘转码失败或超时,自动回退到中心转码或备用边缘节点
中心只负责调度与分发后,状态一致性怎么保
这是很多人忽视的一个坑,中心不直接碰流,一旦边缘上报状态慢或丢失,调度就会变成盲操作,可行做法是:
- 转码任务状态机尽量简单:已下发、执行中、成功、失败
- 边缘节点每30秒上报一次任务心跳,超时任务主动重发或切换节点
- 观众端播放地址更新前,先确认新边缘流已经可拉,避免404
- 所有模板变更都要带版本号,边缘执行前先比对版本,防止旧模板反复覆盖
音视频直播转码下沉边缘与中心调度分发常见问题
边缘转码和中心转码哪个好?
没有绝对答案,对超大流量、对延迟敏感的直播,边缘转码优势明显;对并发不大、管理简单的业务,中心转码运维成本更低,核心看回源带宽成本和观众地域分布。
直播转码边缘节点部署方案里,如何避免单点故障?
每个区域至少两个边缘节点互备,调度侧配置主备关系,转码任务下发时同时通知备用节点,备用节点只拉流不转码或低负载运行,主节点故障后,调度侧把任务切到备用节点,播放地址更新滞后几秒,观众侧基本无感。
转码下沉后中心只负责调度与分发,直播卡顿问题怎么定位?
先查边缘节点转码任务状态,确认转码延迟是否正常;再查输出流到CDN或播放端的链路质量;最后看中心调度是否把观众调度到了不合理的边缘节点,按这个顺序排查,多数卡顿能定位到转码延迟或分发链路问题,而不是中心调度本身。
直播转码下沉边缘后,中心从苦力变成指挥,真正的技术难点落在边缘节点的统一调度和状态管理上,谁能把边缘算力管得细,谁就能在直播延迟和带宽成本上拿到实打实的优势。