ETL与ELT的根本分歧不是工具好坏,而是数据转换发生在数据入库前还是入库后这个阶段差异直接决定架构成本、实时能力和维护方式。 如果你还在纠结选哪套软件,先把转换阶段这件事拎清楚。
ETL和ELT的区别是什么:先看数据转换发生在哪个阶段
很多人问 ETL 和 ELT 的区别是什么,答案可以压缩成一句话:ETL 先把数据洗干净再放进仓库,ELT 先把原始数据丢进仓库再慢慢清洗,它们的名字只差一个字母顺序,但转换动作的位置完全不同。
- ETL 顺序:Extract → Transform → Load,转换发生在中间层,通常由独立 ETL 工具或脚本完成。
- ELT 顺序:Extract → Load → Transform,转换发生在目标仓库内部,借助数仓的计算引擎完成。
| 维度 | ETL | ELT |
|---|---|---|
| 转换发生阶段 | 加载前 | 加载后 |
| 原始数据保留 | 通常不保留 | 完整保留 |
| 计算压力 | 中间 ETL 服务器 | 目标数仓 |
| 实时性 | 链路长,延迟较高 | 写入快,转换异步 |
| 适用场景 | 传统数仓、固定报表 | 大数据量、探索分析 |
ETL:数据进仓库之前先做转换
传统 ETL 的工作流是:从 MySQL、Oracle、SAP 等源系统抽取数据,先落到一个临时区或中间服务器,执行清洗、去重、格式统一、聚合,再把成品数据写入目标数据仓库。
这样做的好处是目标仓库存放的都是规整数据,报表查询快,权限管理简单,数据质量在入库前就被卡过一道。
代价也很明显:
- 原始数据在转换过程中被过滤或覆盖,后期想重新分析未加工字段往往拿不回来。
- 转换层可能成为性能瓶颈,大数据量下需要单独部署高性能 ETL 服务器。
- 从抽取到入库的链路变长,实时场景下延迟被拉高。
ELT:数据先进仓库再转换
ELT 把原始数据直接加载到数据仓库或数据湖,转换步骤用 SQL、Spark、dbt 等工具在仓库内部执行,目标系统通常是云数仓,Snowflake、BigQuery、ClickHouse、Doris 这类具备较强计算能力的平台。
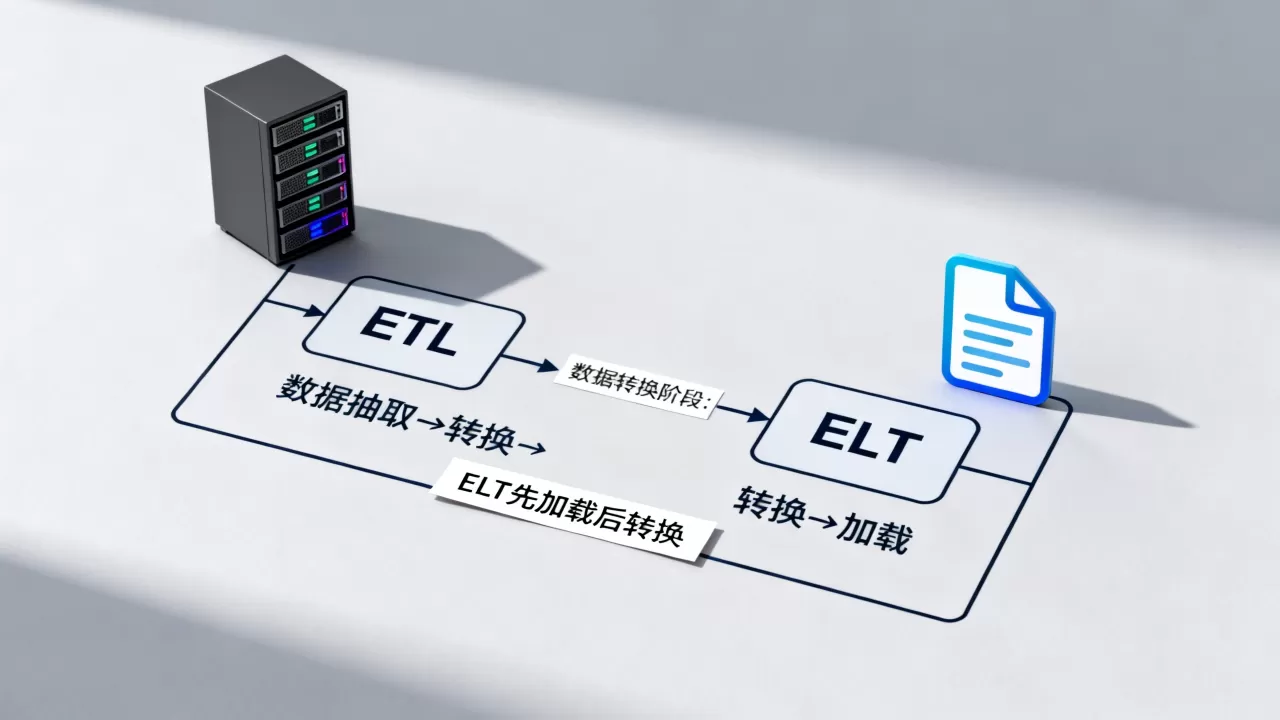
ELT 的核心变化不是省掉了转换,而是把转换从外部中间件搬到了仓库内部。
- 原始数据完整保留,后续分析口径可以随时调整。
- 转换逻辑用 SQL 表达,门槛低,修改和版本管理更方便。
- 数仓的分布式计算能力可以并行处理大规模数据,减少对单独 ETL 服务器的依赖。
数据仓库ETL工具价格差异,根源在转换放哪一层
聊到价格,很多人会直接搜数据仓库ETL工具价格,ETL 和 ELT 的成本结构差异,正是转换阶段不同造成的连锁反应。
- 传统 ETL 工具多按核心数、任务数或数据行数收费,要跑大批量转换,往往需要额外购买更高规格的服务器节点,授权费和硬件成本一起涨。
- ELT 模式下,转换消耗的是目标数仓的计算资源,按查询扫描数据量或计算时长计费,不用单独养一套 ETL 集群,但数仓的存储和计算费用会上升。
- 如果目标仓库已经是云数仓,ELT 通常省掉中间服务器成本;如果企业已有自建 ETL 平台,迁移到 ELT 的初期可能还要同时维护两套逻辑。
行业共识认为,云数据仓库的算力弹性让 ELT 在大数据量下总拥有成本更低,但这个结论不适用于所有团队,如果数据量小、转换规则固定,传统 ETL 工具的长期授权费反而更可控。
实时ETL场景下,转换阶段的选择直接决定延迟
在实时ETL场景下,ETL 和 ELT 的延迟差距会被放大,实时看板、风控、推荐系统都需要数据在秒级甚至亚秒级可见。
实时ETL的典型链路
- 数据源产生事件后,先进入 Kafka。
- 用 Flink 或 Spark Streaming 在中间层做清洗、过滤、字段映射。
- 清洗后的结果写入 Redis、ClickHouse 或 OLAP 库供查询。
这条链路里,转换发生在入库前,每一步都有处理耗时,源数据量一大,Flink 任务背压,延迟就会抖动。
实时ELT的常见做法
- 数据源直接写入 Kafka,再通过 Kafka Connector 把原始事件落入数据湖或数仓的 raw 表。
- 转换任务用物化视图或定期 SQL 调度完成,查询层读取已转换的 mart 表或直接查 raw 表。
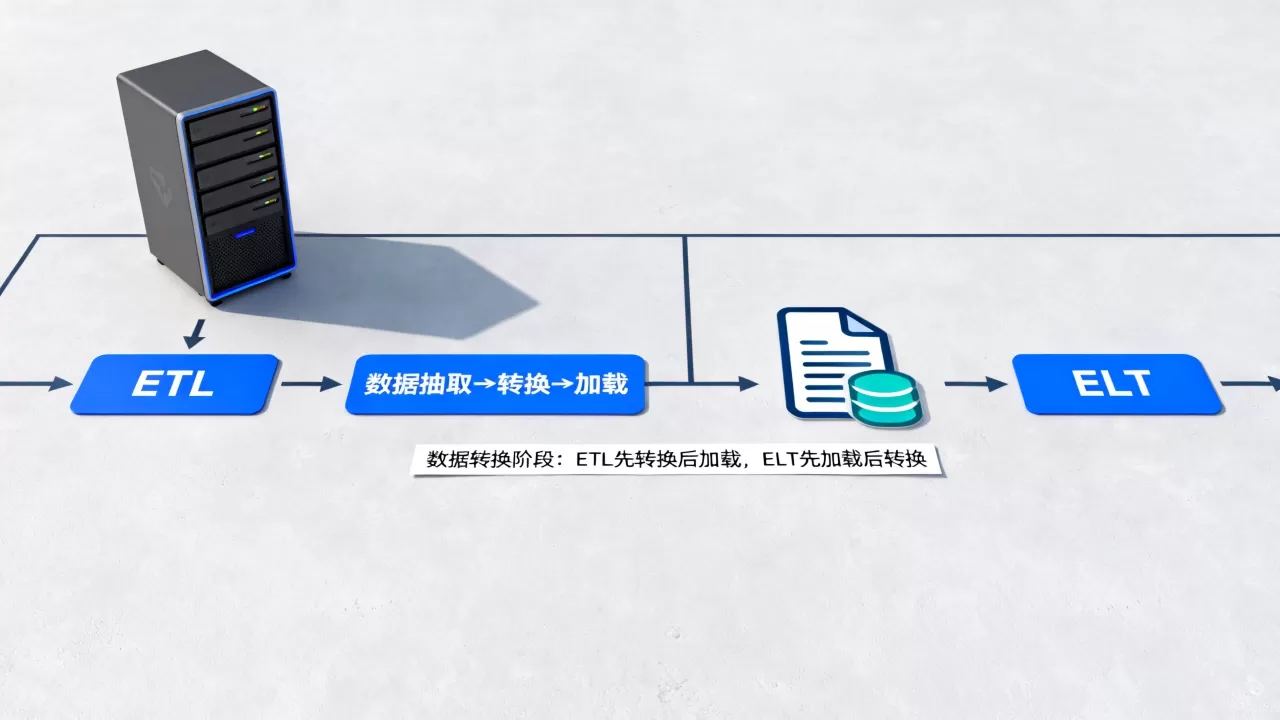
ELT 的优势在于原始数据先落地,实时写入链路更短,缺点是转换异步执行,业务第一次查询时可能遇到尚未转换完成的数据。
操作层面,实时 ELT 可以这样验证:
- 在 ClickHouse 建 raw 表,字段全部用 String 类型先接收。
- 用 Materialized View 做字段类型转换和聚合。
- 看板查询直接读物化视图,写入压力与转换压力解耦。
成都ETL实施公司选型时怎么看转换阶段
在成都这类新一线城市,ETL 实施公司接到项目时,通常不会一上来就推某个工具,有经验的团队会先判断甲方的目标仓库类型和数据规模。
- 如果客户是传统金融、政务或制造企业,数仓以 Oracle、Hive 或本地 GP 为主,转换阶段放在入库前更稳,合规审计链路也更清晰。
- 如果客户是互联网、电商或新零售,目标平台多为云数仓或实时分析型数据库,实施团队会倾向于 ELT,减少中间组件。
- 遇到数据量大但预算紧的项目,成都本地实施公司会优先用开源组件组合,Kafka + Flink + Doris,转换阶段放在 Doris 内部或 Flink 中转,按实际场景折中。
地域不是决定 ETL 与 ELT 选择的核心因素,但实施团队的本地化经验会影响他们对转换阶段的默认判断,部分成都团队熟悉离线数仓,会在初期习惯性沿用 ETL;接触云原生项目多的团队,则更愿意把转换下推到仓库。
ETL转ELT怎么做:从转换阶段迁移的实操路径
企业想从 ETL 切换到 ELT,最怕的不是写 SQL,而是整个数据转换阶段的迁移节奏把控不好,ETL转ELT怎么做,核心思路是:先保留 raw 层,再逐步把转换逻辑搬进仓库。
第一步:让原始数据先落地
新建一个 raw 库或 raw schema,源系统数据全量写入,不做任何清洗,字段类型可以先宽松,比如统一用 String 或 Text,避免加载失败。
示例 SQL:
CREATE TABLE raw.orders (
    order_id String,
    user_id String,
    amount String,
    created_at String
);
第二步:用 dbt 或 SQL 模型重建转换规则
把原来 ETL 工具里的清洗逻辑拆成 staging 层模型,每个模型只做一个动作:去重、类型转换、字段映射、聚合。
dbt run --select stg_orders
模型代码可以用 CAST、CASE WHEN、JOIN 把转换逻辑表达清楚。
第三步:业务查询先切到 raw 视图
在数据验证期,让报表或分析师先查 raw 层加视图,验证数据量和新口径是否一致,不要一次性切断旧 ETL 任务。
第四步:逐步下线旧转换任务
确认新模型产出的 mart 层结果与旧任务一致后,按主题域分批下线旧 ETL 任务,先下线非核心报表,再处理核心指标。
整个过程可能持续数周甚至数月,转换阶段的迁移本质上是把数据质量控制点从入库前移动到入库后,权限、血缘、监控都要跟着调整。
ETL与ELT的分歧点常见问题
ETL和ELT的区别是什么,一句话概括?
ETL 在数据进入仓库前完成转换,ELT 先把原始数据加载进仓库,再由仓库内部计算能力做转换,分歧点就在转换发生的阶段不同。
数据转换放在入库前还是入库后,对成本影响有多大?
入库前转换需要单独 ETL 服务器或商业工具授权,成本集中在中间层,入库后转换消耗数仓计算资源,省掉中间服务器,但数仓计算和存储费用会上升,小数据量、固定规则场景下 ETL 更省心;大数据量、多变口径场景下 ELT 更灵活。
ETL转ELT怎么做才能不影响现有报表?
先建 raw 层保留原始数据,再把旧转换逻辑用 SQL 或 dbt 在仓库内部重建,验证结果一致后按主题域分批切换,最后一个事实是:转换阶段一旦改变,后续的权限、血缘、监控设计都要重新梳理,这是迁移中容易被低估的部分。
ETL 与 ELT 的争论最后都会回到同一个问题:数据在什么时候被加工最合理,转换阶段的位置不是技术细节,而是数据架构的底盘,先把这个问题想清楚,工具和价格才有比较的基础。