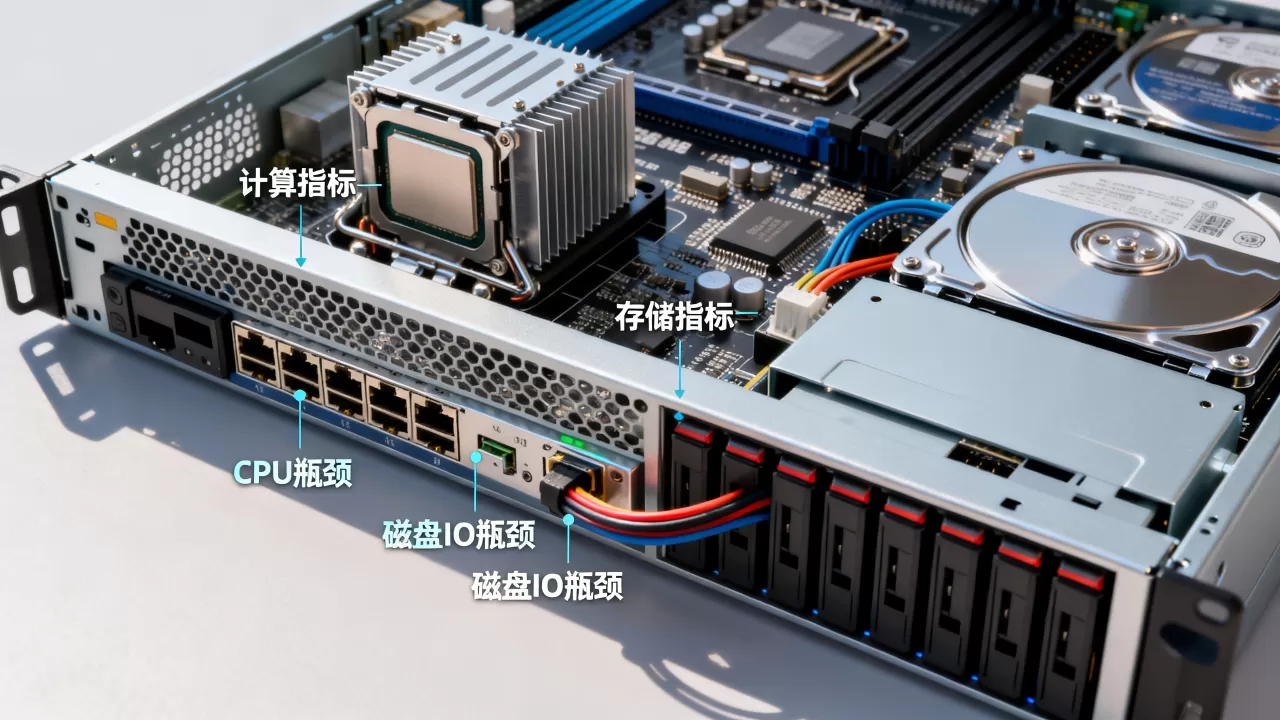
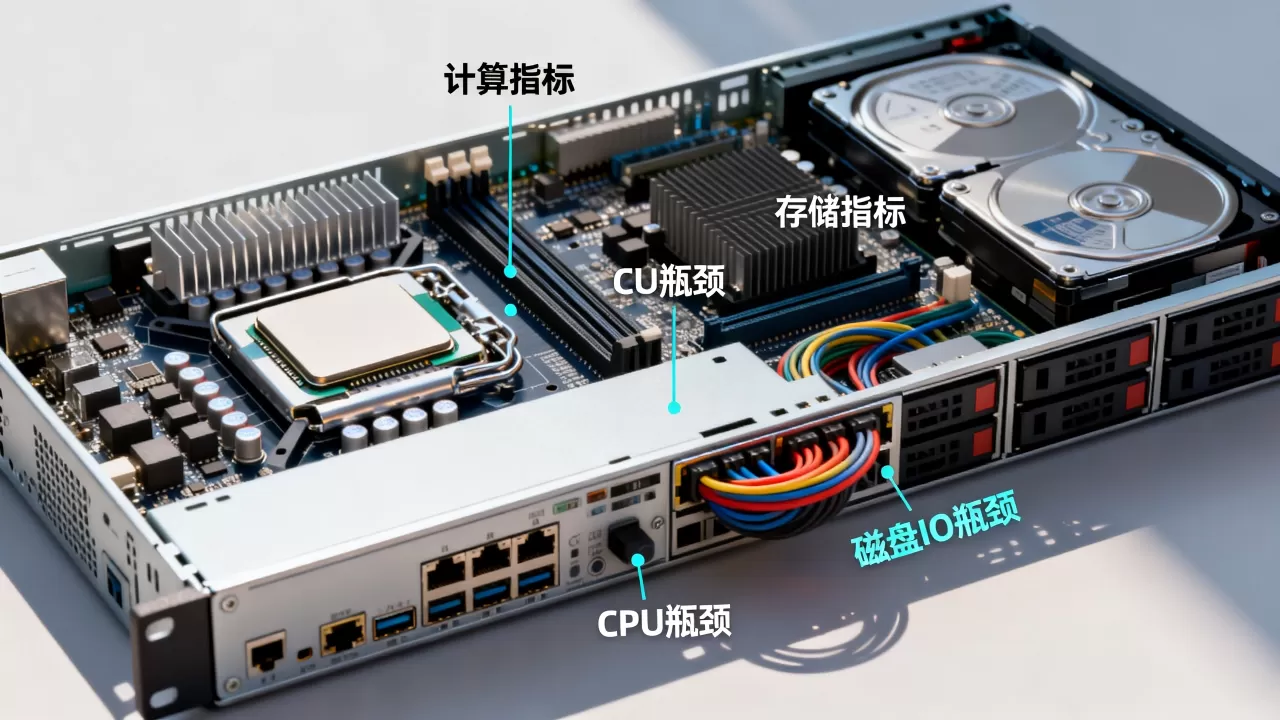
计算指标决定服务器“现在能不能跑”,存储指标决定“数据能不能留得住”,二者无法简单二选一;但排障时先查计算,容量规划和数据安全必须优先看存储。
服务器监控指标计算和存储哪个重要:先看故障表现
服务器监控里,计算和存储像一对性格相反的搭档,计算资源出问题,服务器立刻给你脸色看:网站打不开、命令卡住、CPU风扇狂转,存储资源出问题,往往先藏几天,等发现时备份失败、数据库事务堆积、文件系统只读,所以从“先救火”角度看,计算指标更容易触发告警;从“保命”角度看,存储指标一旦失控,后果更严重。
计算指标异常几乎都是即时爆雷
CPU使用率、负载平均值、运行队列长度、上下文切换次数,这些计算指标直接反映服务器处理请求的能力,多数情况下,计算资源耗尽的表现非常直观:
- 用户访问Web页面响应时间从毫秒级掉到秒级
- SSH登录后输入命令明显顿挫
- top命令里load average持续高于CPU核数
- vmstat输出里r列数值长期大于CPU核数
这类故障的排查路径也很固定,登录服务器先跑uptime看负载,再用top -c定位占用CPU最高的进程,配合mpstat -P ALL 1观察单核分布,如果是多线程应用,还要看pidstat -t统计线程级CPU消耗,大部分计算瓶颈通过扩容、限流、优化代码就能缓解。
存储指标是典型的温水煮青蛙
存储问题很少一开始就炸,磁盘I/O等待时间慢慢变长、剩余容量每天降一点、inode使用率悄悄爬到高位,等业务真正感知到,通常已经进入危险区间:
- 数据库commit时间从几十毫秒涨到几百毫秒
- 文件上传下载卡在最后阶段不动
- 执行
df -h发现某个挂载点使用率超过90% - 执行
iostat -x 1看到await持续超过20毫秒,%util接近100%
存储故障最难缠的地方在于恢复慢,计算资源不够,重启或扩容几分钟见效;磁盘满了、RAID降级、坏道扩散,可能需要停业务换盘重建,耗时以小时甚至天计算。数据不可用的代价远高于服务短暂变慢,这是存储指标不能轻视的根本原因。
不同服务器角色的计算与存储权重对比
不能脱离业务场景谈谁关键,同样一台物理机,跑数据库和跑静态文件服务,监控侧重点完全不同。
数据库服务器:存储指标优先派
数据库重度依赖磁盘I/O,事务日志落盘、缓存刷脏页、备份导出,每一环都在跟存储性能较劲。
- 重点盯iostat输出的
await、avgqu-sz、r_await、w_await - 关注文件系统的fsync延迟,MySQL可用
SHOW ENGINE INNODB STATUS查看 - 监控数据目录剩余空间和binlog增长速率
一个典型场景:电商大促期间,MySQL慢查询突然增多,先看CPU,可能只有30%使用率;再看磁盘,发现iostat -x里await飙到80毫秒,此时加CPU核数毫无意义,换成NVMe云盘或优化索引才解决问题,数据库场景下,存储指标的重要性经常压过计算指标。
计算密集型服务器:计算指标优先派
渲染农场、视频转码、AI训练节点、科学计算集群,这些服务器大部分时间CPU和GPU满载,磁盘只负责读写中间文件,监控重点自然落在:
- CPU使用率、用户态与内核态占比
- 内存带宽和交换分区使用情况
- GPU利用率、显存占用、温度
比如一台用于4K视频转码的服务器,业务方反馈任务跑得慢,登录后top显示CPU全部核心100%,iostat显示磁盘I/O利用率不到10%,这种情况直接升级CPU规格或增加转码节点即可,存储监控只需保证输出目录有足够剩余空间。
虚拟化宿主机:两者互为瓶颈
虚拟化环境里,CPU超卖和存储共享经常互相拖累。
- CPU steal time持续偏高,说明宿主机CPU被其他虚拟机抢占
- 存储datastore latency升高,所有虚拟机磁盘I/O同时受影响
- 内存ballooning和swap使用率也需要同步观察
行业共识认为,虚拟化环境的监控不能只看单台虚拟机,宿主机层的计算与存储指标必须成对分析,某一台虚拟机CPU高,可能只是自身负载问题;所有虚拟机存储延迟同时升高,大概率是共享存储阵列性能瓶颈。
服务器监控指标怎么设置才不花冤枉钱
很多运维团队一上来就采购商业APM,一年费用不低,其实基础监控用开源工具完全够用,先把免费命令和轻量级组件用透,再根据缺口补商业方案。
免费命令组合覆盖90%日常需求
- CPU:
top、uptime、mpstat、pidstat - 内存:
free -h、vmstat、smem - 磁盘容量:
df -h、df -i - 磁盘I/O:
iostat -x、iotop、pidstat -d - 网络:
ss -s、iftop、nload
把这些命令写成脚本,配合crontab每5分钟采集一次,落盘到文本或时序数据库,就能形成基本的监控闭环,中小规模环境下,这套方案几乎零成本,且足够发现多数故障苗头。
开源监控栈的性价比方案
Prometheus + node_exporter + Grafana是目前开源监控的主流组合,node_exporter自动暴露CPU、内存、磁盘、文件系统、网络等几百项指标,Prometheus负责抓取和告警,Grafana做可视化。
# 安装node_exporter后默认监听9100端口
wget https://github.com/prometheus/node_exporter/releases/download/v1.8.2/node_exporter-1.8.2.linux-amd64.tar.gz
tar xzf node_exporter-1.8.2.linux-amd64.tar.gz
./node_exporter &
验证采集是否正常:
curl http://localhost:9100/metrics | grep node_cpu_seconds_total
这套方案没有License费用,社区支持活跃,适合绝大多数企业,只有在需要业务级链路追踪、代码级性能剖析时,才需要考虑商业工具。
北京服务器监控指标配置的实操建议
如果服务器部署在北京的机房或云上,多一项网络质量监控,北京作为北方网络枢纽,跨地域访问路径复杂,机房内网延迟和公网丢包率会直接影响业务感知。
- 对北京服务器托管场景,建议在监控里加入
mtr或ping到核心上游的延迟记录 - 对云服务器,关注云监控提供的公网入/出带宽使用率和丢包率
- 内网监控可用
smokeping做长期延迟曲线
操作上,北京机房服务器如果跑面向全国的业务,要把不同运营商的线路质量纳入告警,一个实际做法是:在华南、华东各放一台轻量探针,每10分钟ping一次北京服务器,丢包或延迟突增就触发告警,这套做法不增加多少成本,但能提前发现线路抖动。
服务器存储监控指标有哪些必须纳入告警
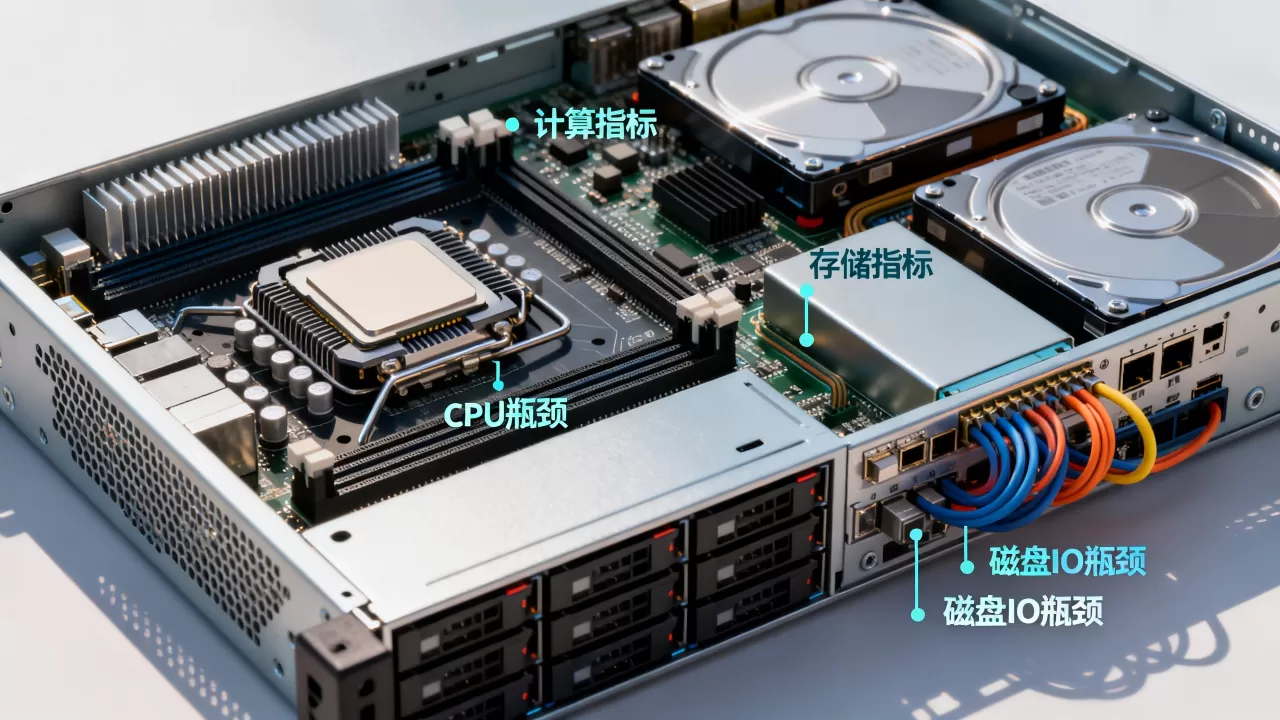
存储监控最容易犯的错误是只看剩余容量,不看性能和健康状态,容量满不是最危险的,磁盘悄悄坏道、RAID降级、inode耗尽同样致命。
容量与性能分开监控
容量类指标:
- 挂载点使用率:
df -h - inode使用率:
df -i - 大目录增长速率:
du -sh /var/log /data/
性能类指标:
iostat -x中的await、%util、avgqu-sz- 每秒读写次数IOPS和吞吐量
- 云盘burst余额或IOPS配额
容量告警阈值建议设在80%提醒、90%严重,inode使用率同样不能忽视,某些邮件服务器或小文件密集场景,磁盘剩余空间很大但inode耗尽,照样无法写入。
磁盘健康与硬件层监控
物理服务器建议开启SMART监控:
smartctl -a /dev/sda
重点看:
- Reallocated_Sector_Ct:重映射扇区数
- Current_Pending_Sector:待处理坏扇区
- Power_On_Hours:硬盘通电时间
RAID阵列要配合厂商工具,如LSI的storcli、HP的ssacli,监控阵列状态和单盘离线情况,云服务器则通过控制台云监控查看云盘寿命、IOPS使用率和吞吐量限制。
服务器监控指标计算与存储相关常见问题
服务器监控指标计算和存储哪个更重要?
没有绝对答案,取决于业务类型,数据库、文件存储类服务器优先盯存储指标;Web前端、计算渲染类服务器优先盯计算指标,但生产环境两条线都要有,因为计算瓶颈可能掩盖存储问题,存储故障也会表现为CPU等待升高。
服务器监控指标怎么设置告警阈值?
先采集一周基线数据,取高峰期的P95值作为参考,CPU使用率超过85%并持续5分钟发提醒,超过95%发严重告警,磁盘使用率超过80%发提醒,超过90%发严重,await超过20毫秒且持续3个采样周期发提醒,阈值不要一刀切,不同角色服务器用不同模板。
服务器存储监控指标有哪些常见误区?
最常见误区是只看df -h剩余空间,不看inode和I/O性能,第二个误区是认为云盘不会坏,忽略云盘寿命和burst余额,第三个误区是只监控文件系统,不监控底层RAID或物理盘SMART状态,这些误区都可能导致数据丢失或业务中断。