Lua虚拟机共享内存的线程安全,本质上靠“锁分区”与“无锁读”的组合拳实现,而不是给整个VM加一把大锁。多个线程共享同一个LuaState时,写操作必须串行化,读操作可以并行,这是目前业内主流的高性能方案。
为什么Lua天生不适合多线程直接共享
Lua从设计之初就是单线程模型,官方文档明确说明,一个lua_State同时只能被一个线程执行,这不是偷懒,而是因为Lua的运行时环境充满了全局可变状态。
- 全局表与注册表:所有全局变量、元表、包加载结果都挂在同一个注册表上,多线程同时读写会直接崩掉。
- 字符串内部化:Lua把字符串存在一个全局哈希表中,相同内容的字符串只保留一份,并发创建字符串会破坏哈希表结构。
- 垃圾回收器:Lua的GC是增量式的,但它扫描和标记对象时假设没有其他线程在改动对象图,一旦两个线程同时触发GC,内存管理直接失控。
- 调用栈与协程:每个lua_State有自己的栈,但协程调度依赖单线程的事件循环。
基于这些原因,业内专家指出,直接把一个lua_State丢给多线程用,轻则数据错乱,重则段错误崩溃,正确思路是“多State + 共享受限数据”,而不是“单State多线程”。
锁粒度拆分的共享内存模型
每个线程独立State,只共享特定数据区
这是目前游戏服务器和网关类项目最常用的做法,每个工作线程创建自己的lua_State,线程内完全无锁执行,需要共享的数据,单独开辟一块内存区域,用读写锁保护。
实际操作路径:
- 主线程初始化时创建N个lua_State,每个绑定到一个工作线程。
- 共享数据放入一个独立的C结构体,比如一个哈希表或者key-value存储。
- Lua侧通过userdata持有这个共享区的句柄。
- 写操作调用
lua_lock和lua_unlock,这两个宏Lua官方预留了接口,底层可以替换成自定义的互斥锁。 - 读操作使用rwlock的共享模式,多个线程可以同时读。
这种结构下,Lua虚拟机自身的状态完全隔离,不需要加锁,锁只保护共享数据区,粒度小,竞争少,性能损耗低。
写时复制与消息传递的变体
另一种常见做法是“无共享,靠传递”,每个State只操作自己的内存,跨线程通信通过一个无锁队列(比如DPDK风格的ring buffer)发送消息,接收方拿到消息后,在自己的State里反序列化并执行。
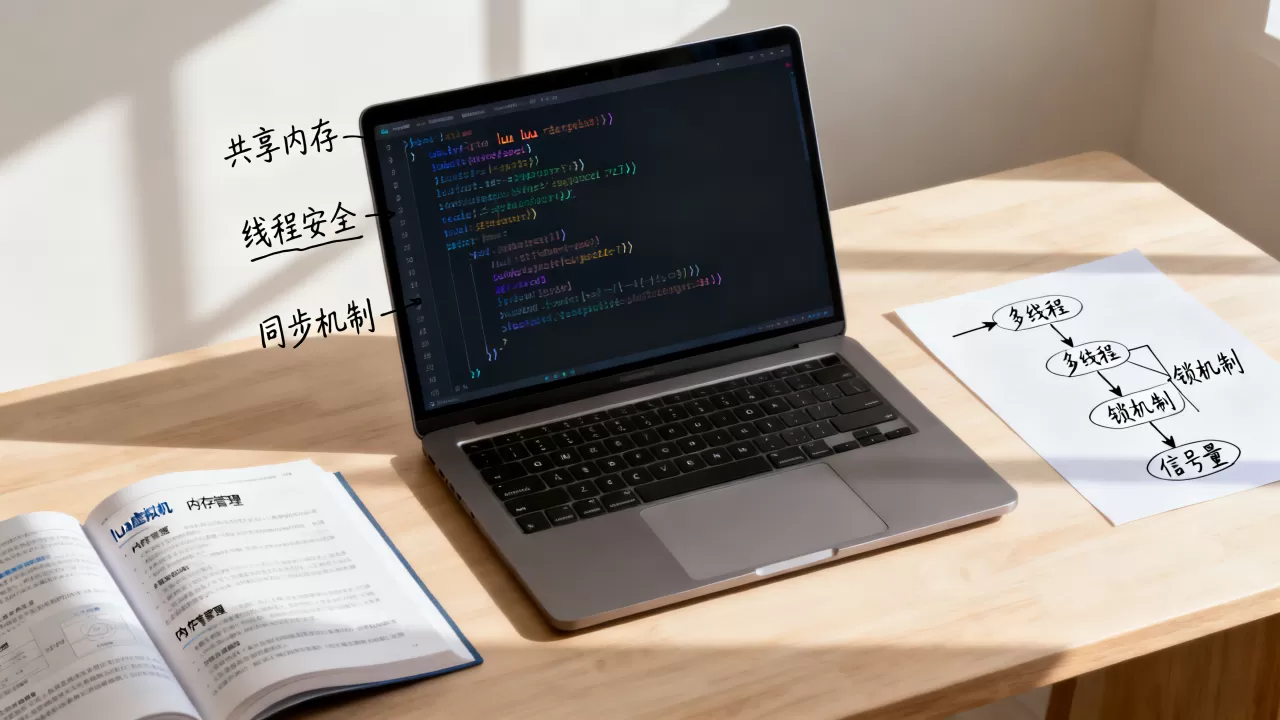
这种方式避免了显式锁,但要求数据在传递时做深拷贝,适合配置同步、任务分发这类低频写场景,如果共享数据量很大,拷贝开销会抵消锁的优势。
Lua原生锁接口的正确使用姿势
认识lua_lock与lua_unlock宏
Lua源码里预留了lua_lock(L)和lua_unlock(L)宏,默认是空实现,它们的作用范围是整个LuaState,包括GC、字符串表、栈操作。
如果你想给单一State加锁,可以这样改:
#define lua_lock(L)     pthread_mutex_lock(&(L)->ui.lock)
#define lua_unlock(L)   pthread_mutex_unlock(&(L)->ui.lock)
但请注意,这么做的代价是所有Lua操作全部串行化,即使是两个完全独立的协程,只要共享同一个State,任何读写都会被锁挡住,这相当于退回到了单线程性能,只是从“崩溃”变成了“慢”。
什么场景下值得给State加锁
- 只有一个State,但挂载了多个C插件线程,插件偶尔回调Lua。
- 需要保护Lua的
lua_newstate初始化过程,防止多个线程同时创建State时冲突。 - 调试或Profiling场景,需要暂停VM以读取栈信息。
多数情况下,这种全局锁方案只适合老代码改造,新项目不推荐。
开源框架的成熟实践
Redis的Lua脚本与单线程模型对比
Redis内置的Lua执行器是一个很好的反面教材,Redis本身是单线程事件循环,所以它执行Lua时完全不需要锁,但如果你在多线程环境中借鉴Redis思路,就要注意:Redis的Lua脚本不支持访问外部共享状态,所有数据都从Redis自身读取,这本质上是一种“隔离执行”策略,并非真正的共享内存。
OpenResty的lua_shared_dict
OpenResty的lua_shared_dict是业界更贴近“Lua共享内存线程安全”的实践,它基于Nginx的共享内存区域,底层使用自旋锁和红黑树,多个Worker进程(注意,这里是进程不是线程)可以安全地读写同一个dict。
它的关键设计是:每次操作只锁极短时间,且操作类型限制为set/get/incr等原子语义,不支持跨操作的事务,先读再写”需要自己用expire或add来做乐观锁,这一点值得所有自研方案借鉴锁越短,并发能力越强。
游戏服务器中的Lua虚拟机池
一些开源游戏服务器框架采用“VM池”方案,启动时创建固定数量的LuaState,比如CPU核心数的2倍,外部任务提交到任务队列,空闲的State领取任务并执行,共享数据通过Redis或自研内存库存储,Lua侧只缓存热点数据。
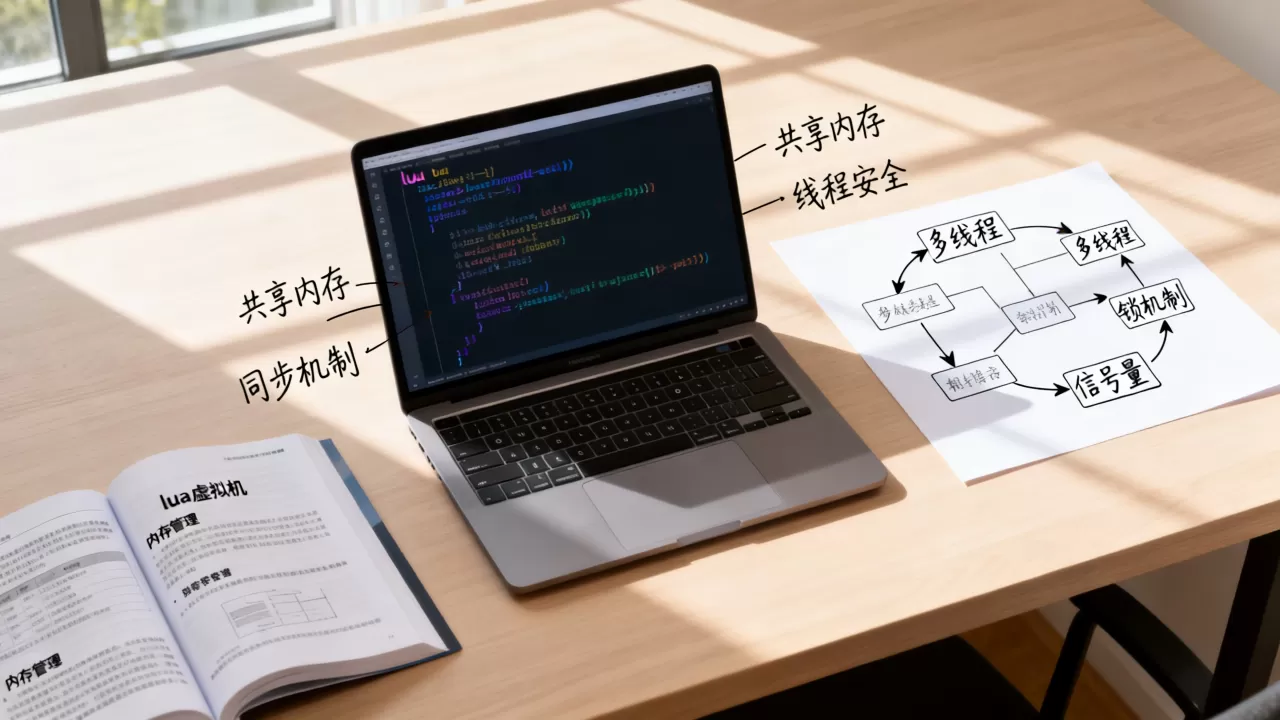
这种方式避开了锁竞争,但引入了数据一致性延迟,适合对实时性要求不高的MMORPG,不适合金融交易这类强一致场景。
实战:手写一个线程安全的Lua共享HashMap
下面给出一个最小可用的C实现思路,基于pthread rwlock。
数据结构:
typedef struct {
    lua_State L;
    pthread_rwlock_t rwlock;
    // 内部用一张Lua表存储数据
    int ref; // 引用共享表的registry key
} shared_map;
写操作接口:
static int smap_set(lua_State L) {
    shared_map m = lua_touserdata(L, 1);
    pthread_rwlock_wrlock(&m->rwlock);
    // 把key和value压入m->L的栈,执行lua_settable
    pthread_rwlock_unlock(&m->rwlock);
    return 0;
}
读操作接口:
static int smap_get(lua_State L) {
    shared_map m = lua_touserdata(L, 1);
    pthread_rwlock_rdlock(&m->rwlock);
    // 从m->L读取值,拷贝到当前L的栈
    pthread_rwlock_unlock(&m->rwlock);
    return 1;
}
注意,这里要求共享表始终挂在m->L上,而不是挂在调用方State上,每次读写都跨State压栈,CPU缓存命中率会低一些,但胜在安全,要提升性能,可以把热点数据做成只读cache,用原子指针切换快照。
性能数据与取舍对比
| 方案 | 锁粒度 | 并发读 | 并发写 | 适用场景 |
|---|---|---|---|---|
| 单State全局锁 | 整个VM | 无 | 无 | 旧代码改造、调试 |
| State隔离+共享区锁 | 共享数据区 | 支持 | 串行 | 游戏服务器、网关 |
| 无锁消息队列 | 无锁 | 支持 | 支持 | 配置同步、任务分发 |
| OpenResty shared_dict | 单条操作 | 支持 | 支持(微秒级锁) | WebAPI、限流计数 |
行业共识认为,性能瓶颈往往不在锁本身,而在跨State拷贝数据的频率,每次从共享区读数据,都需要把值从共享State的栈复制到当前线程State的栈,这涉及字符串或table的深拷贝,如果共享数据是简单的int或短字符串,代价可以忽略,如果是大table,建议改用序列化后传递。
常见坑与避坑指南
- 不要在GC回调里加锁,Lua的GC会遍历所有可达对象,如果在
__gc元方法里操作共享区,可能死锁或重复释放。 - 小心lua_State与线程绑定,一个线程结束时,要确保它持有的State没有被GC回收,否则其他线程通过共享表引用到这个State会崩溃。
- userdata的元表必须唯一,多线程共用一个元表没问题,但如果有线程修改了元表的方法,其他线程会立即感知到,给元表加只读保护。
- 避免在共享表里存function,Lua的function闭包依赖其定义时的State环境,跨State传递后无法调用,这个限制在OpenResty中同样存在,官方文档明确禁止。
Q&A:关于Lua虚拟机共享内存线程安全的常见疑问
只有一个LuaState时,怎么实现线程安全?
做不到完整线程安全,如果你只有一个State,却有多线程回调需求,建议用两步:第一步,其他线程把请求压入无锁队列;第二步,Lua主线程在自己的循环里主动消费队列,这保证所有Lua操作只在主线程发生,从根源避免竞争。
用lua_newthread创建的"线程"算线程安全吗?
不算。lua_newthread创建的是协程,它运行在同一操作系统线程内,共享同一个LuaState的全局表,协程挂起时,其他协程可以修改全局变量,这本身就有竞态条件,只是不会崩溃,因为同一个时刻只有一个协程在跑,真正的多线程并发,协程帮不上忙。
在共享内存里存二进制数据安全吗?
如果二进制数据是纯C缓冲区,不经过Lua字符串类型,安全,但一旦你用lua_pushlstring把它包装成Lua字符串,它就进入了字符串内部化表,多线程同时push相同内容的字符串会竞争哈希表,建议对于大块二进制,用userdata持有裸指针,手动管理生命周期。
检测共享区是否安全,有没有快速验证方法?
有,用线程消毒器(ThreadSanitizer)编译你的C扩展,然后跑一个多线程压力测试,制造并发读写冲突,如果代码有问题,TSan会直接报告数据竞争,精确到行号,注意,TSan需要配合-fsanitize=thread编译,且会明显拖慢运行速度,只适合测试环境。