虚拟机故障迁移想要做到业务不中断,核心在于提前构建高可用架构,用在线迁移(Live Migration)配合共享存储和自动化故障检测去消除单点故障,而不是等在故障发生后临时补位。
为什么故障迁移发生时业务会断?
很多人以为虚拟机迁移就是把文件复制到另一台宿主机上,这么想问题就大了,真正的业务不中断迁移需要处理内存状态、网络连接和存储IO的连续性,任何一环掉链子,业务就断给你看。
内存态才是迁移里最难啃的骨头
运行中的虚拟机在内存里有大量活跃数据,比如数据库连接池、用户会话、缓存队列,如果停机再迁移,相当于把所有业务瞬间掐断几秒钟,这在金融或电商场景中根本不可接受。
在线迁移用预拷贝算法反复同步内存脏页,直到剩余数据量降到阈值后瞬间切换,实际操作中,这套机制对网络延迟和带宽极敏感,千兆网络下大内存虚拟机迁移,每秒能同步的数据量直接决定切换窗口。
共享存储让磁盘不再是绊脚石
行业共识认为,本地存储是虚拟机迁移业务中断的第一大杀手,如果虚拟机磁盘在宿主机本地,迁移时就要先复制磁盘镜像,这个过程可能持续几分钟到几十分钟,业务不可能一直挂着。
换成SAN或分布式存储后,虚拟机磁盘本身就是全局可见的,迁移过程只需同步内存,磁盘切换不产生额外停机时间,OpenStack环境里NFS和Ceph用得最多,VMware环境则是VMFS和NFS主导。
网络层面:IP不能换,MAC不能变
迁移之后虚拟机的IP和MAC地址必须原样保留,否则TCP连接全部断裂,业务侧立刻感知到异常,Linux bridge和OVS都支持将虚拟机的虚拟网卡热插拔到新宿主机,VMware的vMotion还会执行ARP通告,让交换机把流量切到新位置。
高可用集群是实现业务不中断迁移的根基
单个迁移动作做得再快,也只是看着好看因为故障真发生时,你根本没有时间去手动点迁移按钮。真正支撑业务不中断的是故障自动感知和自动恢复机制。
心跳检测:靠多路径确认宿主机真死了
只靠一条心跳链路判断宿主机状态非常不靠谱,网线松动都可能引发误判,常见方案是用管理网络加存储网络双重心跳,配合ping网关、ping存储控制器来综合判断,以vSphere HA为例,隔离地址和心跳数据存储都在发挥作用,只有当多个探测源同时失联才认定主机故障。
故障转移:自动拉起虚拟机比迁移更可靠
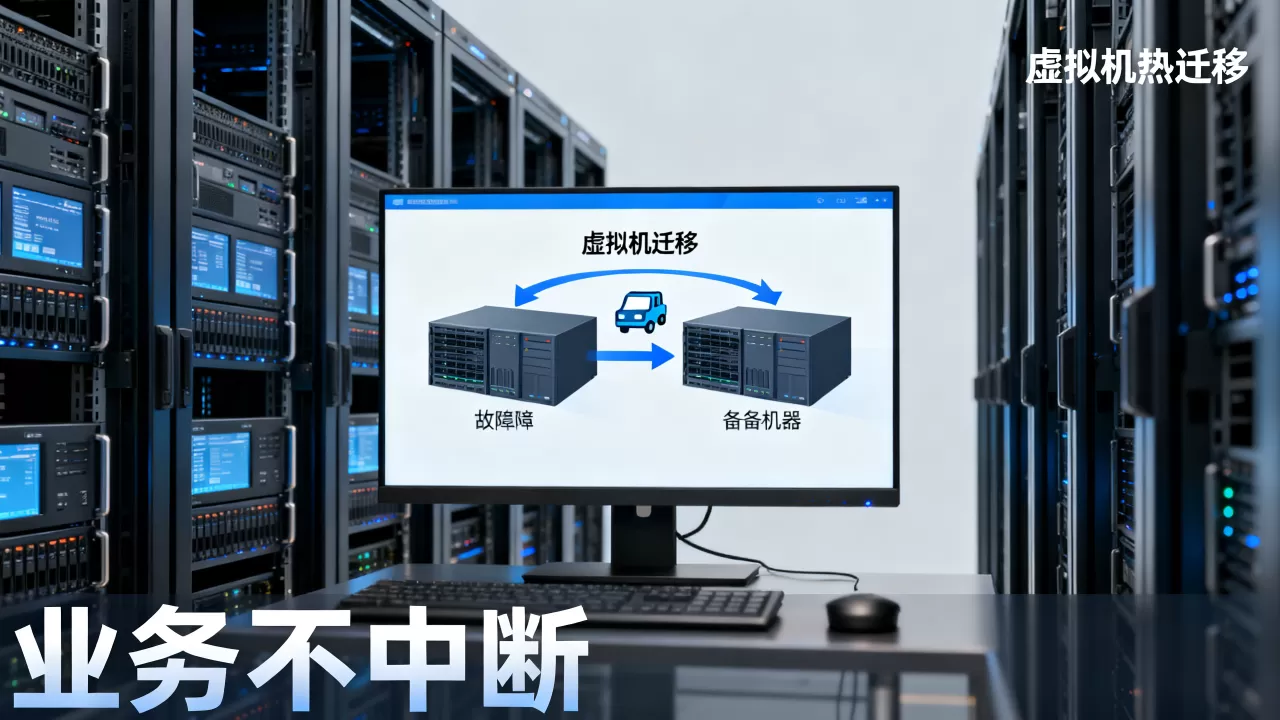
虚拟机故障迁移怎么不影响业务,很多人理解的答案其实是分场景的存储和网络正常时用vMotion或KVM的live migration;但宿主机直接宕机时,迁移根本无处下手,只能靠集群里的其他宿主机把虚拟机的磁盘锁定抢过来重启。
重启不是无缝切换,中大型数据库可能需要数分钟的时间来恢复,想压缩恢复时间,就得让虚拟机的操作系统支持应用级快速启动,或者叠加数据库层的双写机制来兜底,如果用Kubernetes托管业务,多副本多节点调度天然规避了这个痛点。
反亲和规则:别让鸡蛋待一个篮子
如果集群里所有虚拟机都在一台物理机上,迁移再多台也没有意义,组反亲和规则,让业务的不同实例分散到不同宿主机,云服务器故障切换的保险系数才会真正拉高。
热迁移实操:从准备到切换的完整路径
迁移前检查清单
这套清单适用于VMware和KVM两大技术栈,执行完再动手能规避大部分迁移中断风险:
- 确认源和目标宿主机CPU同厂商且同代次,否则可能触发CPU模式不支持
- 检查网络是够有独立迁移通道,迁移流量隔离在专用VLAN,避免挤占业务带宽
- 查看虚拟机的磁盘控制器类型是否被目标平台兼容
- 确认虚拟机内部没有未挂载的ISO镜像和软驱设备
- 检查共享存储有多余容量,预留数据写入空间
迁移中关注哪些指标
VMware里开启vMotion时,可以在任务栏看到内存复制进度条,传输速度通常在1-10Gbps之间,KVM环境用virsh migrate命令,加上--live参数即执行热迁移,建议用以下命令检查细节:
virsh migrate --live --verbose --timeout 120 vm_name qemu+ssh://target-host/system这个过程中CPU热削峰和内存脏页收敛速度是最关键的两个参考点,如果虚拟机的内存写入非常频繁,迁移永远不会收敛,最后的切换步骤只能强制拉停业务,这是你必须提前预料到的。
切换瞬间的业务验证
迁移完成后用
ping -t持续观察网络延时,如果切换瞬间出现超过1秒的延时波动,说明网络层面的切换有丢包;如果想进一步确认数据库连接是不是断了,在业务服务器上建立长连接持续读写,观察是否报错。
比迁移更硬核的方案:双活容灾与故障转移
对于核心业务,单靠虚拟化层级的热迁移并不够,因为热迁移解决的是宿主机层面的故障,但存储阵列故障、机房整体断网依然会造成大范围中断,现在越来越多企业引入双活数据中心架构。
双活架构的使用场景
同城双活适合数据库类和核心交易类业务,两台存储实时同步数据,两个中心同时对外提供服务,一中心故障瞬间切换流量,业务感知几乎为零,这种方案要求带宽、延迟和存储设备都有冗余级别,成本确实高,但每年停机损失超过百万的业务通常会选择它。
另一种变体是仅容灾去分布式,主备两中心数据实时同步但备用中心不承载业务流量,故障时用脚本切换IP或DNS,切换时间通常在3-5分钟,适合对成本敏感又不想停机的场景。
常见容灾方案对比
| 方案 | 恢复时间目标(RTO) | 数据丢失容忍度(RPO) | 成本量级 |
|---|---|---|---|
| 虚拟机热迁移 | 秒级 | 无损 | 中 |
| 高可用集群自动重启 | 分钟级 | 秒级 | 中 |
| 数据库镜像/同步复制 | 秒级 | 有限制 | 中高 |
| 同城双活 | 近乎为零 | 无损 | 高 |
综合考虑业务重要性、运维能力和预算,选对方案比单纯追求技术上限更重要,多数情况下,高可用集群加上热迁移已经覆盖了绝大多数宿主机故障场景,双活则适合对RTO要求极其严格的业务。
故障迁移时如何确保业务不中断:避坑要点
别忘了虚拟机的内存超分
物理机内存超分之后,所有虚拟机内存总和超过物理内存,日常运行没事,但一台宿主机宕机,其他虚拟机全部挤到剩余宿主上时,内存超分环境极容易触发新宿主机的拖慢甚至OOM,生产环境建议不要超分或控制超分比例在1.5倍以内
,预留故障转移缓冲。
存储常见瓶颈不可忽视
故障发生后,所有虚拟机要从同一份共享存储拉数据,存储队列会瞬间吃满,观察存储IO延迟指标,超过20毫秒就该警惕,在存储选型时优先看IOPS和带宽规格,而不只是容量,如果存储本身成为单点,故障迁移不但保证不了业务连续性,还会连带拖垮原本健康的宿主机。
业务层配合才是终极兜底
不管迁移做得多完美,总有上层依赖的意外,比如虚拟机网络正常了,但应用连接外部支付网关的通道断了,因此业务层也要有一层轻量级健康检查,能自动恢复半死状态的连接。最好的故障迁移是整个系统层面的协作,不是虚拟化平台独自完成的任务。
Q&A:虚拟机故障迁移相关常见疑问
热迁移是不是越快越好?
不是,热迁移速度太快意味着迁移流量消耗大量带宽,反而影响业务网络,实际规划中,迁移网络建议与业务网络分离,千兆以上独立网卡,根据虚拟机内存大小预留足够迁移窗口,vMotion通常能将停机时间控制在1秒以内,这个参数已经足够绝大多数业务的容忍范围。
无共享存储的时候能做到不停机迁移吗?
可以,但要额外耗时去复制磁盘数据,KVM的virsh migrate --live --copy-storage-all能实现无共享存储迁移,但完成时间明显拉长,如果虚拟机磁盘几百GB级别,不建议在高峰期操作,低峰期操作可以缩减风险,同时保持--auto-converge参数让CPU限速以加速收敛。
云服务器故障切换价格贵不贵主要体现在哪些方面?
云平台自带的迁移服务通常按磁盘空间和迁移次数计费,上海地域的云厂商价格在每GB几毛钱级别,但额外的高可用集群组件和跨可用区流量都会带来显著增量成本,自建虚拟化平台省去了按次计费,但硬件冗余和运维成本是硬性支出,对比来看,业务体量不大时托管云服务更划算;规模成型后自建集群更可控。
业务不中断不是靠运气,而是靠提前布局的架构支撑,在故障发生前就把存储、网络、计算资源冗余都安排妥当,故障发生时按预案自动化切换,业务连续性就不再是一个需要忐忑等待的未知数。