服务器获取数据库连接慢,最快的解决路径是先定位耗时阶段,再针对连接池、网络和数据库侧逐步调优,多数情况下不需要大改SQL就能恢复响应速度。
连接慢和SQL慢是两种完全不同的体验,连接慢发生在请求还没发到数据库时,表现为接口超时、页面转圈;SQL慢则是查询发出去了,数据库迟迟不吐结果,后面按排查顺序,从定位到优化逐步展开,每一步都有可以落地的操作。
先定位:连接慢到底卡在哪一环
怎么排查是数据库连接建立慢还是SQL执行慢
如果用的是JDBC,可以在连接串上开启慢日志,或者用连接池自带的指标监控,HikariCP的 metricRegistry 可以输出 getConnection 和 query 两个阶段的耗时,数据直接显示连接建立花了多少毫秒,SQL执行花了多少毫秒。
更简单的办法是看应用日志的时间戳。连接创建的日志和SQL执行开始日志之间的差值,就是握手和认证的时间,差值大,问题出在连接建立;差值小,问题在数据库处理能力。
- 应用日志里搜
Connection created和Statement executed。 - 数据库日志里搜
Access denied或认证相关的报错。 - 慢查询日志只能看到已经建立的连接,看不到握手阶段,所以定位阶段尽量以应用侧日志为主。
用命令拆解网络延迟和数据库响应
在应用服务器上执行 time mysql -h 数据库IP -P 3306 -u 用户名 -p -e "select 1",输出的 real 时间就是完整的建连加查询耗时,再执行一次复用连接的查询,两者差值约等于连接的建立耗时。
- ping数据库IP的延迟超过50ms,说明链路经过了较长距离,跨机房或跨地域访问的可能性大。
- telnet数据库IP 3306能通但响应慢,问题大概率在TCP握手或数据库认证。
- select 1本身就要几百毫秒,数据库CPU或IO已经吃紧,先把内核参数和慢查询放前面处理。
一个容易混淆的场景:连接池耗尽不等于连接慢
连接池耗尽的表现也是“获取连接超时”,但它和“建立连接慢”是两回事,连接池里所有连接都在忙,新的请求只能排队等别人释放,这时日志里会看到 Connection is not available, request timed out,要区分这两种情况,在连接池监控页面看活跃连接数即可:
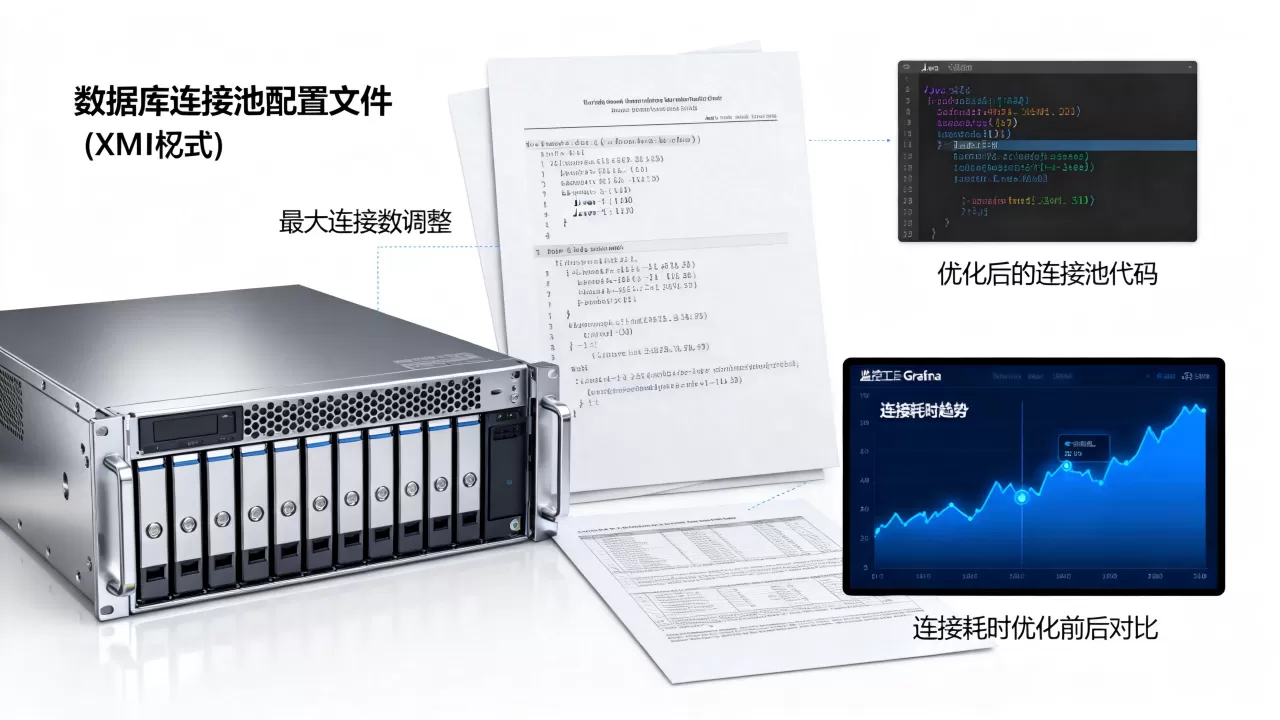
- 活跃连接数长时间等于最大连接数,说明池子被占满,需要排查连接泄露。
- 活跃连接数很低,但拿连接还是慢,说明建连链路本身有问题。
数据库连接池怎么调:从参数到选型
连接池大小怎么设置才算合理
行业共识认为,连接池大小不是越大越好,数据库对并发连接数有处理上限,连接太多会放大锁竞争和上下文切换的开销,HikariCP默认最大连接数10,这个值在低并发下够用,但如果用的是Druid或C3P0,默认配置往往偏保守,需要手动调节。
- 最小空闲连接数:设置为业务峰值并发数的20%到30%,保证突发流量进来时不需要临时建连。
- 最大连接数:可以按数据库CPU核数估算,经验参考值为
CPU核数×2+1,8核数据库从20开始尝试。 - 连接空闲超时:30到60秒比较合适,太短会导致频繁销毁重建,太长会堆积僵尸连接。
- 最大生命周期:建议不超过30分钟,避免数据库侧主动断开后应用还在用旧连接。
三个直接影响连接获取体验的参数
connection-timeout 是应用等待连接的最长时间,默认30秒,如果数据库响应本身要1秒,这个值可以适当调小到5秒,让异常请求快速失败,而不是一直阻塞线程。
idle-timeout 控制空闲连接的回收,很多场景下连接慢是因为连接在池子里已经失效,应用拿到的瞬间需要重新校验或重连,把空闲超时和数据库的 wait_timeout 对齐,可以避免拿到半死连接。
validation-query 决定取出连接时是否主动探测,HikariCP推荐用 select 1,Druid里对应 testWhileIdle,开启后虽然每次拿连接多一次轻量查询,但能有效避免拿到的连接不可用。
连接池选型对比:功能不同,速度有差
| 对比维度 | HikariCP | Druid |
|---|---|---|
| 连接获取速度 | 快,字节码层面优化明显 | 稍慢,但差距在毫秒级 |
| 监控能力 | 依赖Metrics输出 | 内置StatViewServlet,可视化强 |
| SQL防注入 | 无 | 有WallFilter |
| 适用场景 | 对延迟敏感的业务 | 需要可视化监控和SQL分析的业务 |
两者选型时,如果对连接获取速度敏感选HikariCP,需要监控和慢SQL统计选Druid,选型完成后,记得打开监控页面确认活跃连接数和等待时间,让后续调优有数据依据。
数据库侧和网络侧:跨机房部署的连接优化
跳过DNS解析,关掉拖慢握手的配置
MySQL在认证阶段会做反向DNS解析,如果客户端IP没有对应的PTR记录,这一步可能耗时1秒以上,在 my.cnf 的 [mysqld] 段加上 skip-name-resolve,可以跳过这个环节,但代价是账号只能用IP连接,不能用域名,修改后重启MySQL生效。
另一个容易忽略的参数是 back_log,当新连接瞬间涌入时,超过该值的连接会被挂起或拒绝,表现为连接缓慢失败,建议从默认的80调大到128或256,同时确认Linux的 net.core.somaxconn 不低于这个值,否则内核会截断队列。
TCP和内核参数怎么配合跨机房场景
应用和数据库分别部署在不同机房时,即便专线延迟只有几毫秒,TCP协议栈参数也可能让连接建立变慢,重点检查下面几项:
- 应用服务器
net.ipv4.tcp_fin_timeout默认60秒,调整到15秒,加速TIME_WAIT连接回收。 - 数据库服务器
net.core.somaxconn默认128,扛不住突发握手时调到1024。 - JDBC连接串里加
connectTimeout=3000和tcpKeepAlive=true,防止链路假死导致长时间等待。
连接慢的多数场景都集中在握手和认证阶段,业内专家指出,先处理这两步比盲目调大连接池更有效。
用连接代理减少地域延迟
多地域业务场景下,应用和数据库最好同机房部署,如果业务必须跨地域访问,可以在应用侧加一层数据库代理,比如ProxySQL或MyCat,代理复用了大量后端连接,应用只需要连本地的代理节点,把跨机房的长连接变成短链路,连接获取速度会有明显提升。
从成本角度看,自建代理需要额外维护,云数据库自带的代理层费用通常不高,但省去了连接管理的运维成本,对没有专职DBA的团队更划算。
慢查询和锁冲突:连接慢的隐藏元凶
连接拿得快,但SQL执行拖垮响应
连接池解决的是“拿连接”的速度,拿到连接之后,SQL本身执行慢会占满连接池的线程,后续请求拿不到连接,整体表现依然是“连接慢”。
排查方法很直接:开启慢查询日志,把执行时间超过1秒的SQL抓出来。
Rows_examined 和 Rows_sent 差距极大,说明查询没走索引或扫描范围过大,加索引后,再看连接池的活跃数量,多数情况下会明显回落。
锁等待让连接池的线程空转
show processlist 里出现大量 Waiting for lock 或 Lock wait timeout exceeded 时,说明事务没有及时提交,后续连接全部在排队等待,这时候盲目增大连接池,只会加剧锁竞争。
- 检查代码里的事务边界,不要在事务里调用外部接口或执行耗时的远程请求。
- 把
innodb_lock_wait_timeout从默认的50秒调到5秒以内,让异常事务快速释放锁。 - 大事务拆成小事务,单事务影响行数尽量控制在千行以内。
服务器获取数据库连接慢的常见问题解答
用Druid还是HikariCP,哪个连接更快?
HikariCP在字节码层面做了优化,连接分配和回收的开销更小,连接获取速度更快,Druid强在监控和SQL防注入,连接获取速度稍逊,但差异在几十毫秒级别,业务对连接延迟敏感选HikariCP,需要可视化监控和慢SQL统计选Druid,Druid的 StatViewServlet 可以显示当前活跃连接数和等待时间,这些数据能直接反映池子是否健康。
数据库连接池调大了反而更慢是为什么?
连接池调大后,数据库并发线程数同步增加,锁竞争和上下文切换的开销变大,当最大连接数超过数据库CPU核心数的两倍时,吞吐量不再明显上升,反而消耗更多CPU资源,连接获取延迟回升,连接池大小需要结合数据库吞吐和业务并发评估,不是越大越好。
本地连接快、服务器上连接慢,可能是什么原因?
本地连接快说明数据库本身处理能力正常,问题大概率在服务器网络链路或安全组规则,检查服务器到数据库的TCP延迟、防火墙是否对数据库端口做了限流,以及SELinux或iptables策略是否拦截了部分握手包,服务器上的连接池配置可能和本地不一致,打开连接池监控,确认 minimum-idle 是否匹配业务实际并发,服务器获取数据库连接慢,本质上是链路中某一环节出现了积压,先把耗时分布测出来,再按连接池、网络、数据库的顺序逐步调整,大多数问题都能在几分钟内定位到具体环节,如果调完这些参数仍然慢,把注意力转向慢SQL和锁竞争,那才是更深层的瓶颈。