虚拟机集群的高效管理与资源分配优化,核心答案就一句话:先按业务画像测算真实基线,再做计算与存储的池化复用,最后靠动态调度和监控闭环持续调优。
很多团队一上来就盯着硬件参数选型,结果集群搭完,CPU利用率常年躺平,内存却早早告急,问题不在硬件不够好,而在配置动作没有落在资源分配的逻辑上,下面这套方法,是我在多个生产环境里反复验证过的思路。
虚拟机集群配置方案怎么定才靠谱
配置方案的前提不是“买多大机器”,而是搞清楚业务到底需要多少资源,连需求都没量化,谈优化就是空转。
先给业务画像,再谈配置基线
动手配置前,至少花两周时间采集现有物理机或虚拟机的运行数据,重点关注四个维度:CPU平均使用率、内存占用峰值、磁盘读写延迟、网络吞吐量。
- 数据库类业务看重磁盘IOPS和内存命中率,CPU反而不是第一瓶颈
- Web前端业务看重网络连接数和CPU突发能力
- 大数据离线任务看重磁盘顺序读写与内存带宽
- 开发测试环境对延迟不敏感,但对隔离性要求高
把业务按这几类拆开,分别统计高峰时段和低峰时段的资源占用,多数情况下,日常平均负载只有峰值负载的40%左右,所以配置基线要参考高峰,而不是平均。
预留多少余量才算合理
余量留少了,遇到流量突变直接雪崩;留多了,资源闲置等于烧钱,行业共识认为,集群整体算力冗余控制在20%到30%比较健康。
举个例子:某个集群日常峰值需要80核CPU,那就规划到100核左右,剩下20核用于故障转移和突发流量,物理机的内存配置尽量按“峰值占用+缓存余量”来计算,而不是按业务申请量来买。
超分比例设置是资源分配优化里最容易出效果的一环
虚拟化的核心优势就是超分,CPU超分可以放宽,常见做法控制在四倍到八倍之间,具体看业务的CPU敏感度,内存超分则要谨慎,内存一旦超分触发了swap,性能直接跳水。
- 高并发交易系统:CPU超分不超过四倍,内存不做超分
- 常规企业应用:CPU超分六倍,内存超分1.5倍以内
- 开发测试环境:CPU超分八倍,内存超分两倍以内
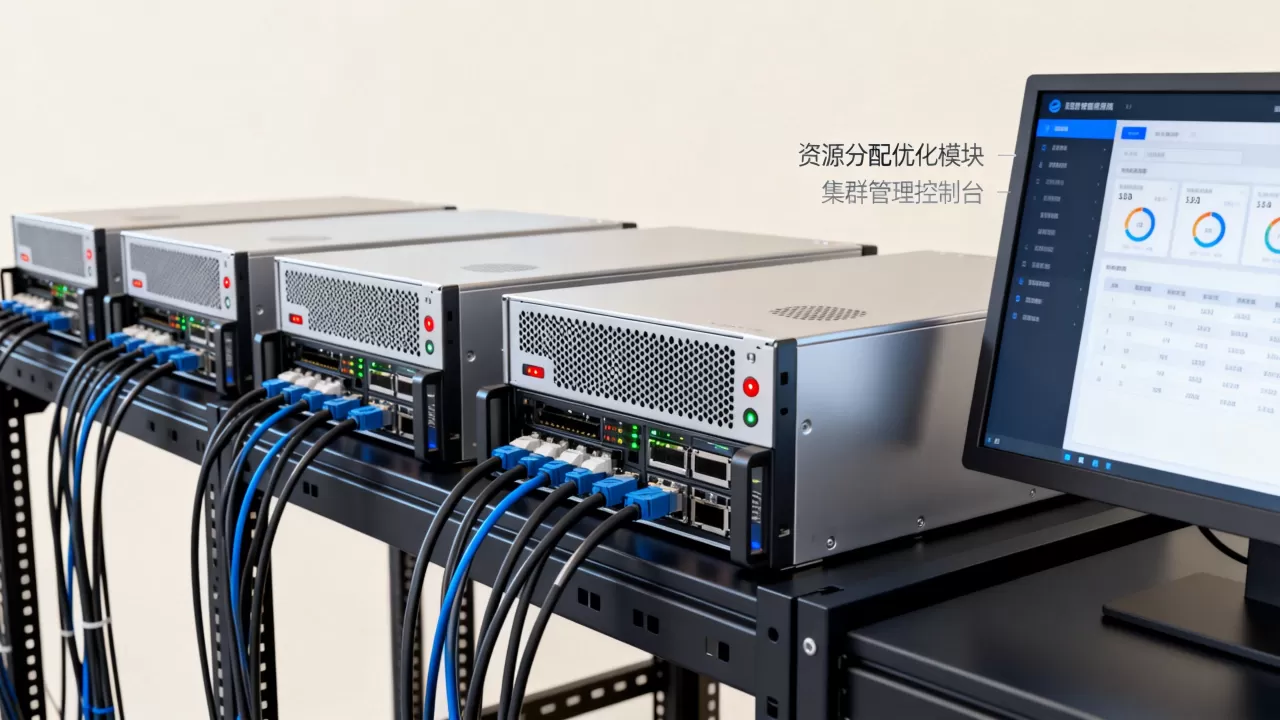
超分是手段,不是目的。 每一层超分都要配上监控报警,一旦物理机的内存换页率上升,立刻调整配额。
虚拟机集群资源分配优化从哪里入手
配置方案定好之后,真正的优化动作在于资源的动态流动与复用,静态分配只是起点,动态调度才是价值所在。
把零散资源池化,消灭孤岛
不少企业的集群是“部门各自为政”,一套物理机跑一个部门业务,导致资源无法互通,优化第一步,就是打破这个局面。
- 统一接入虚拟化平台,将CPU、内存、存储纳入统一资源池
- 不同部门之间设置资源配额,而不是物理隔离
- 高优先级业务可以借用低优先级业务的空闲资源
池化的意义在于复用。 开发环境的空闲算力,完全可以在夜间借给测试集群跑自动化脚本。
用动态迁移平衡物理机负载
当一台物理机的CPU使用率超过阈值(比如80%),而另一台只有20%时,就该触发在线迁移了。
vSphere环境可以开启DRS(分布式资源调度),自动把虚拟机从高负载物理机迁移到低负载节点,KVM和Proxmox环境则可以通过脚本实现类似效果,核心命令是:
virsh migrate --live <虚拟机名称> qemu+ssh://目标主机/system- 配合定时任务检查物理机负载,超过阈值自动执行迁移
为突发流量设计弹性伸缩
多数企业业务有明显的波峰波谷,以电商场景为例,大促期间流量可能是日常的数倍,与其全年为峰值买单,不如设计弹性伸缩策略。
- 提前定义好虚拟机模板,包含基础环境和业务代码
- 设置触发式扩容:CPU连续五分钟超过75%,自动克隆三台虚拟实例
- 流量回落后,自动缩容并释放空闲资源
伸缩频率高的时候,建议搭配自动化运维平台(如Ansible或SaltStack),不然手工操作在几十台虚拟机面前根本忙不过来。
生产环境虚拟机集群怎么配置存储与网络
计算资源分配清楚了,存储和网络往往成为新瓶颈,不少集群死机不是因为CPU不够,而是存储响应太慢把整个平台拖垮
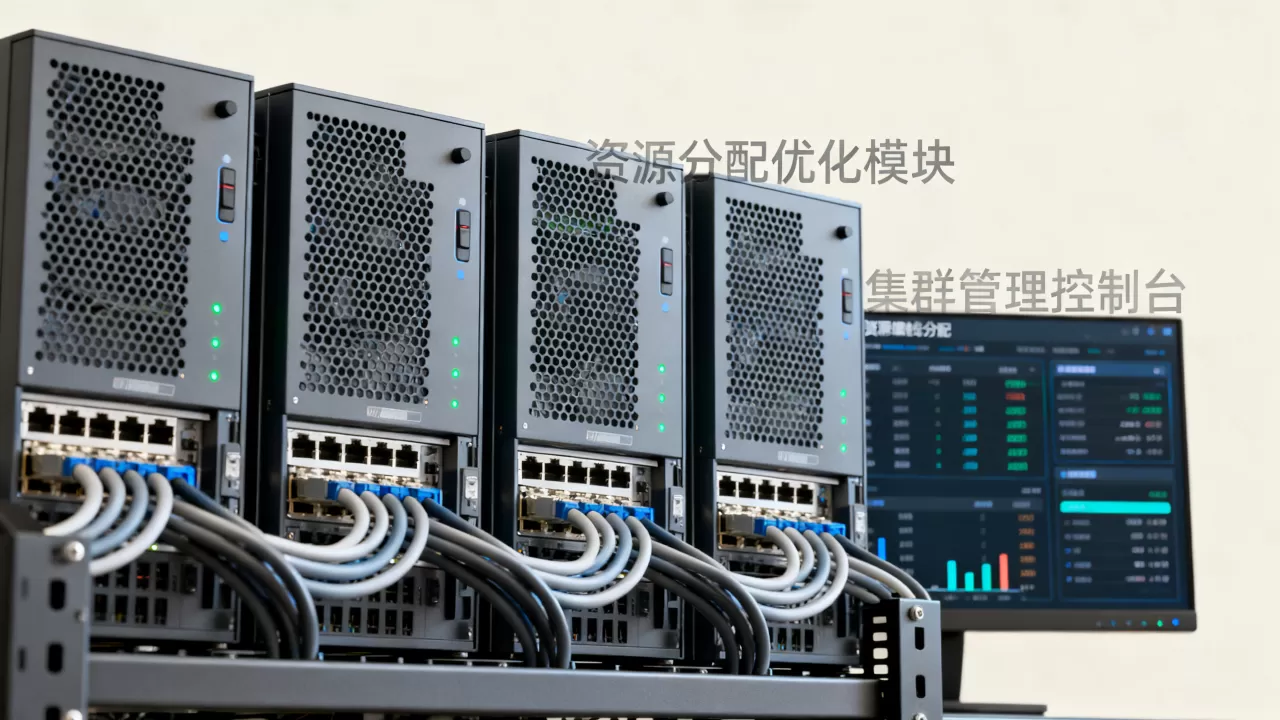
。
存储层要学会区分热数据与冷数据
集中式存储(如SAN)性能稳定但扩展成本高,分布式存储(如Ceph)扩展方便但延迟偏高,最稳妥的路子是分层存储:
- 高性能SSD池承载数据库和核心业务
- 普通SATA盘池承载备份、日志和开发环境
- 定时任务根据文件访问频率自动迁移冷热数据
延迟敏感型业务务必放在SSD池,存储网络也建议采用独立万兆链路或光纤通道,存储区域网络与业务网络混跑,一旦备份任务启动,业务响应时间就会明显恶化。
网络配置要细分流量类型
生产环境中,建议划分三个平面:管理网络、存储网络、业务网络,三个网络在物理层面或VLAN层面隔离。
- 管理网络跑虚拟机迁移和平台管理指令,带宽要求不高但稳定性要强
- 存储网络跑块存储和备份流量,延迟要低,避免拥塞
- 业务网络承载前端流量,需要弹性带宽
如果交换机支持,可以在业务网络启用流量整形策略,限制单个虚拟机的最大带宽,否则,一台虚拟机将占用全部磁盘带宽,集群里的其他业务都会卡顿。
虚拟机集群配置注意事项里,亲和与反亲和规则常被忽略
同一个业务的多台实例,尽量分散到不同物理机,避免一台物理机宕机导致整个业务不可用,反之,对延迟极其敏感的高性能计算应用,可以用亲和规则把特定虚拟机固定在某个CPU核上。
配置细节做到位,比堆硬件更能省钱。
虚拟机集群配置完成之后如何持续优化
集群上线只是开始,资源分配优化是长期循环,季度复盘必不可少。
监控数据要存储下来,复盘才有依据
配置完成后,建议把监控数据落入时间序列数据库,至少保留半年,没有历史数据,扩容分析就是拍脑袋。
- 记录每台物理机每月CPU峰值与平均值
- 记录每台虚拟机的资源使用排名,找出“只占资源不干活”的实例
- 记录存储容量增长趋势,推算出何时需要加磁盘
定期清理僵尸虚拟机
相当一部分企业的集群里,总有一些虚拟机创建后再没人登录,它们占着内存、耗着CPU,还不停产生告警日志,建议每季度做一次虚拟机认领活动:
- 导出所有虚拟机列表,标注创建时间和最后登录时间
- 超过180天无人登录的虚拟机,打上“待回收”标签
- 与业务方确认后,先关机观察两周,无异常再删除
回收一台僵尸虚拟机,相当于省下一台云主机一年的租赁预算。
容量趋势比瞬时数值更有指导意义
曲线比快照更诚实,某个集群的CPU使用率今天达到80%,未必是扩容信号,也许只是周期性任务叠加,看连续三个月的月度平均增长率,才能判断是真增长还是正常波动。
高效管理虚拟机集群,靠的是持续做配置基线修正、资源池化调度、监控回收闭环,配置方案定基础,动态调度做平衡,监控复盘保长效,这套循环跑起来,资源利用率自然会上去,成本也会降下来。
虚拟机集群配置成本怎么控制才不踩坑
答:成本大头不在硬件采购,而在资源浪费与停机损耗,一台物理机负载长期低于20%,它的折旧、电费、机房空间成本全在打水漂,把零散负载合并到更少的物理机上,提高单机密度,集群总拥有成本会明显下降,同时优先考虑标准化配置,避免每台物理机型号不同带来的运维成本上升。
虚拟机集群用什么虚拟化平台更合适
答:需要对比的是管理成熟度和团队技术栈,VMware vSphere适合大中型企业,动态调度和高可用功能最完善;KVM搭配Proxmox开源方案成本更低,社区资料丰富,适合已有Linux运维团队的环境。选型的关键不是“哪个最强”,而是“哪个自己能驾驭”,平台切换的迁移成本,往往比平台本身的价格更值得纳入决策。
如何判断集群需要扩容而不是继续调优
答:先看监控数据里的等待队列指标和延迟指标,如果CPU就绪队列持续升高、磁盘读写延迟大幅增长,说明物理资源确实耗尽,调优已经无法缓解,再结合容量趋势曲线观察三个月,每月增长持续超过10%,就应该启动扩容计划,扩容时可以优先考虑增加单台物理机的内存容量,再扩展CPU核数,避免盲目新增节点带来的集群通信开销。