不同显存规格的GPU服务器价差通常不是线性增加,而是从“几千元级月租差”拉到“数万元级月租差”,同代芯片下高显存版本整机采购价也常贵出数倍。 对租用者来说,24GB、48GB、80GB、141GB这些档位,表面看只是容量不同,背后却是HBM成本、带宽、互联能力和供给稀缺度一起定价,2026年做AI推理、微调还是训练,选错显存档位,预算可能多花一大截,也可能因为显存不足反复重跑。
GPU服务器显存大小对价格影响大吗?先看价差来源
显存不是孤立参数
显存容量当然重要,但它不是唯一变量,同一张GPU芯片,显存从24GB升到48GB,或者从80GB升到141GB,价格跳升往往来自多个层面:
- 显存类型:GDDR6、GDDR6X、HBM2e、HBM3、HBM3e,成本差距很大。
- 显存带宽:带宽越高,训练和推理吞吐越稳,价格也越高。
- 互联能力:NVLink、NVSwitch、PCIe版本,影响多卡扩展效率。
- 整机平台:CPU核心数、内存容量、NVMe硬盘、网卡规格都会跟着显存档位升级。
- 供给关系:高显存版本良率更低、封装更复杂,市场供给通常更紧。
据NVIDIA官方产品规格,H100常见显存为80GB HBM3,H200提升到141GB HBM3e,容量和带宽一起提升,是价格上探的重要基础。
同芯片不同显存,价差为何能翻倍
很多人以为“显存翻倍,价格翻倍”很夸张,实际在GPU服务器市场,这种情况并不少见,业内专家指出,大显存GPU的HBM良率和封装成本更高,高配版本出货比例也相对少。
以A100为例,40GB和80GB版本在云上就不是一个价位,H100 80GB与H200 141GB之间,月租差距更明显,到了192GB甚至更高显存的加速卡,单机整柜成本会直接进入另一个量级。
价差的三个量级
- 入门级:24GB显存,常见于推理卡、消费级卡,云月租通常在数千元级,整机采购几万元级。
- 专业级:48GB显存,适合中模型微调、渲染、科学计算,云月租常见数千到上万元,整机采购上到十万元级。
- 旗舰级
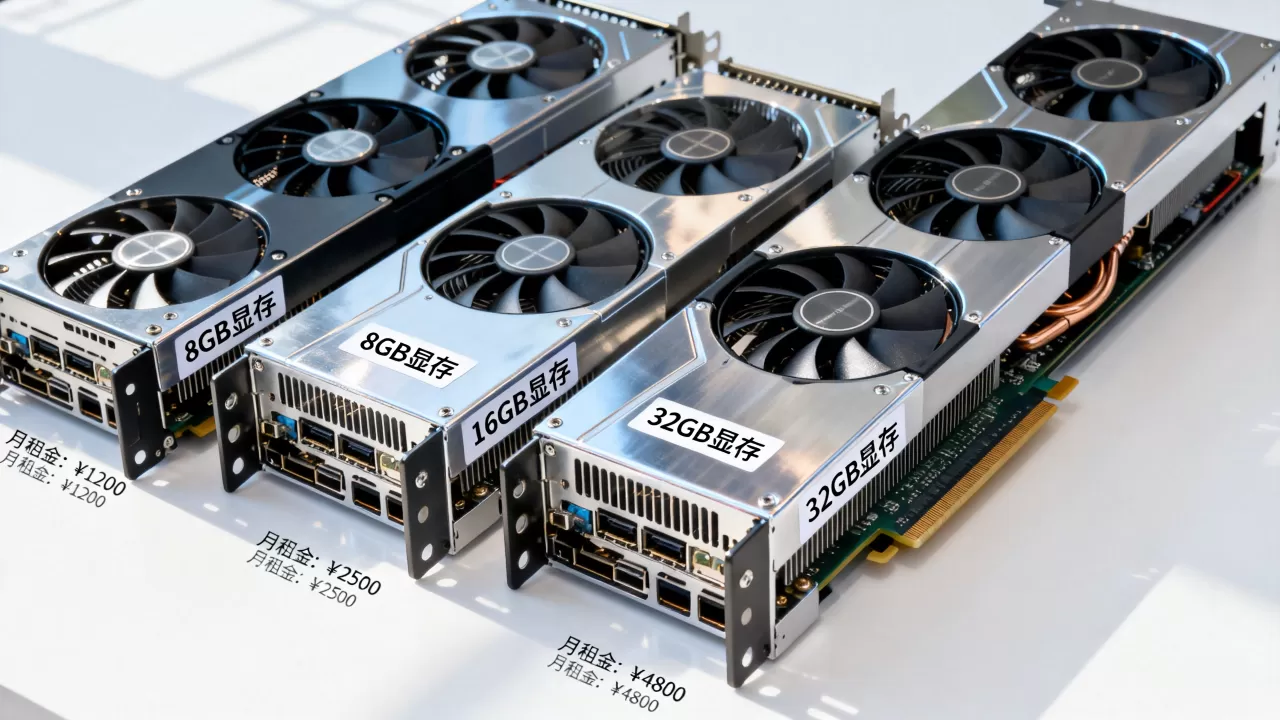
:80GB HBM显存,适合大模型训练,云月租上万元到数万元,整机采购数十万元级。
- 超大显存:141GB、192GB及以上,适合超大规模训练,云月租数万元甚至更高,整机采购更高。
这些数字不是固定报价,地域、租期、供需、合同折扣都会改变结果,但档位之间的价差方向很稳定:显存越大,价格越陡。
大显存GPU服务器租用一个月多少钱?按场景拆价差
推理场景:24GB与48GB的月租差
如果只是跑7B、13B量化模型,24GB显存往往够用,FP16下7B模型权重约14GB,加上KV Cache和框架开销,24GB能跑但余量不大,此时租24GB服务器,月租压力相对小。
如果要做多路并发、长上下文、视觉语言模型,48GB更稳,月租会明显上浮,但比直接上80GB便宜不少,对推理业务来说,显存够用比盲目追高更划算。
微调场景:48GB与80GB的价差
LoRA、QLoRA微调,24GB到48GB可以覆盖不少中小模型,全参微调7B模型,显存需求会快速上升,80GB级更稳妥,13B、30B全参微调,通常需要多卡80GB。
这里价差不只是单卡月租,多卡还要算CPU、内存、NVLink、存储和网络,一台8卡80GB服务器,月租可能是单卡24GB服务器的很多倍。
训练场景:80GB与141GB以上的价差
大模型预训练对显存容量和带宽极度敏感,行业共识认为,显存容量决定模型能否装入,带宽决定训练吞吐,70B模型FP16权重约140GB,单卡80GB装不下,需要多卡并行。
H200 141GB、MI300X 192GB这类卡,单卡就能减少并行切分复杂度,代价是月租高、整机贵、供给少,对训练团队来说,省下来的工程时间可能比租金更值钱。
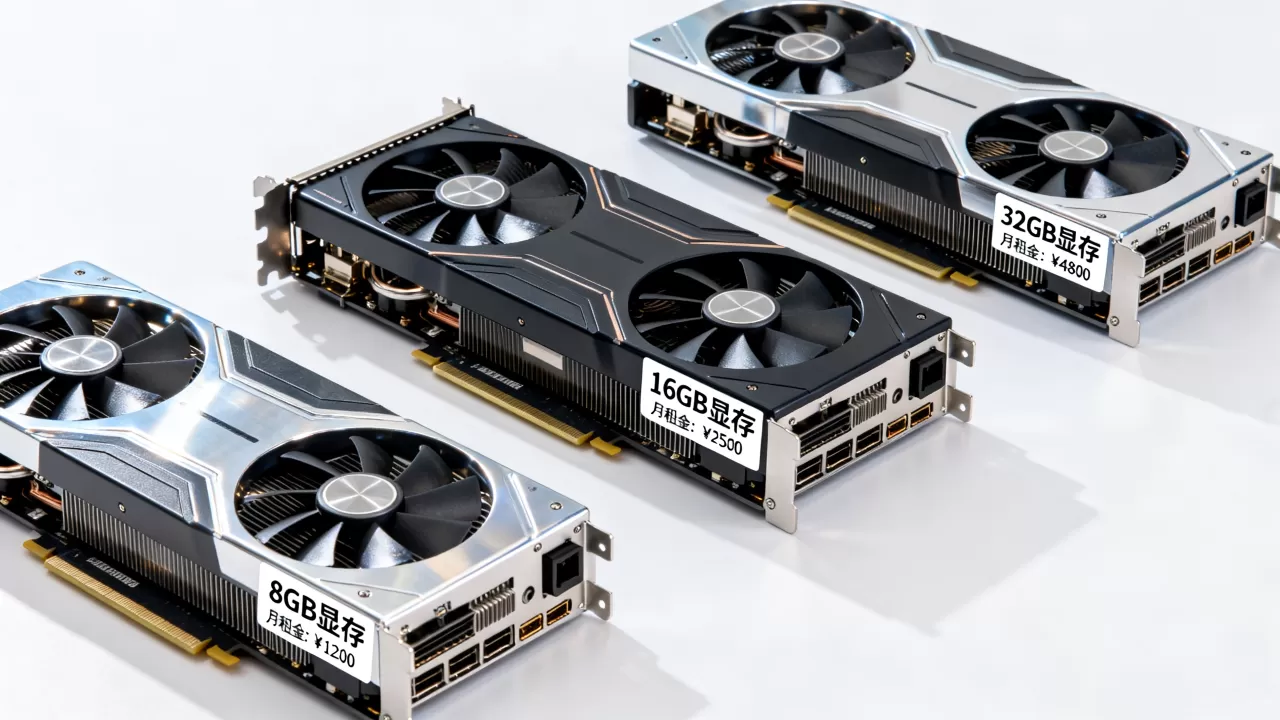
| 显存档位 | 常见卡型 | 典型用途 | 云月租相对档 | 整机采购相对档 |
|---|---|---|---|---|
| 24GB | RTX 4090、L4 | 推理、轻量微调 | 低 | 低 |
| 48GB | A6000、L40S | 中模型微调、渲染 | 中 | 中 |
| 80GB | A100、H100 | 大模型训练 | 高 | 高 |
| 141GB/192GB | H200、MI300X | 超大规模训练 | 很高 | 很高 |
国内GPU服务器租用价格对比:地域与计费如何放大差距
北京、上海与中西部节点的价格差异
北京GPU服务器租用价格、上海GPU服务器租用价格通常高于中西部节点,一线城市机房租金、电力、带宽和运维成本更高,西部算力枢纽有政策支持和能源优势,同显存规格的报价往往更友好。
据工信部相关算力政策,东数西算推动西部枢纽节点建设,电力、机柜成本相对较低,对延迟不敏感的训练任务,西部节点值得优先比较。
按量、包月、包年与竞价实例
同一张80GB卡,计费方式不同,实际月成本差别很大:
- 按量付费:适合短期测试,单价高,灵活。
- 包月:适合稳定业务,折扣通常比按量好。
- 包年:折扣更深,但占用预算,适合长期训练。
- 竞价实例:价格低,可能被回收,适合可断点续训任务。
高显存GPU的竞价价格波动更大,供需紧张时,低价实例可能很快消失。
隐性成本不能忽略
显存规格只是账单的一部分,下面这些也会拉开总价:
- 高性能NAS或对象存储费用。
- 公网带宽和内网互联费用。
- 快照、镜像、备份费用。
- 多机训练时的RoCE或InfiniBand网络。
- 运维和故障排查人力。
实操:如何查真实价差
想弄清不同显存规格的真实价差,可以按下面步骤做:
- 打开主流云厂商GPU实例页。
- 筛选同一代芯片,比如A100 40GB和80GB。
- 记录按量小时价、包月价、包年价。
- 把系统盘、数据盘、带宽加入总价。
- 用以下命令确认实际显存:
nvidia-smi --query-gpu=name,memory.total --format=csv
python -c "import torch; print(torch.cuda.get_device_properties(0).total_memory/10243)"
- 跑一个真实模型,观察显存占用和吞吐。
- 对比“够用档”和“富裕档”的总拥有成本。
训练大模型选多大显存GPU服务器划算?避开高价低效
显存需求估算
训练大模型选多大显存GPU服务器划算,核心是算清四类占用:
- 模型权重。
- 优化器状态。
- 梯度。
- 激活值和KV Cache。
7B模型FP16推理,24GB可尝试,7B全参微调,80GB级更稳,13B、30B全参微调,多卡80GB更常见,70B训练,通常需要多卡80GB或141GB以上。
不要只看显存
显存大不等于训练快,还要看:
- 显存带宽。
- 卡间互联带宽。
- CPU到GPU的数据供给。
- NVMe读取速度。
- 网络是否支持RDMA。
如果互联跟不上,多卡并行效率会下降,高价大显存卡也可能被慢存储拖住。
成本优化清单
- 先租后买,用真实任务验证显存档位。
- 优先混合精度、BF16或FP8。
- 用梯度检查点换显存。
- 用LoRA、QLoRA降低微调门槛。
- 开启断点续训,尝试抢占式实例。
- 把冷数据放对象存储,热数据放本地NVMe。
- 多机训练优先选高带宽内网。
不同显存规格的GPU服务器价差确实很大,但最贵的未必最适合。 先明确模型规模、并发量、训练方式和预算周期,再按显存档位比价,才能把租金花在真正影响效率的地方。
不同显存规格的GPU服务器价差常见问答
不同显存规格的GPU服务器价差有多大?
同代芯片下,24GB、48GB、80GB、141GB以上的月租通常呈阶梯式上升,低档到高档可能相差数倍,整机采购价差更明显,具体幅度受地域、租期、供需和品牌影响。
GPU服务器显存大小对价格影响大吗?
影响很大,但不是唯一因素,显存容量、显存类型、带宽、互联能力、整机平台和供给关系共同决定价格,HBM显存版本通常比GDDR版本贵得多。
大显存GPU服务器租用一个月多少钱?
没有统一价格,24GB档常见数千元级,48GB档常见数千到上万元,80GB HBM档常见上万元到数万元,141GB及以上更高,包年、竞价、西部节点和长期合同可能降低实际月成本。