在深圳租用算力时,集群方案和单机方案的核心差异在于资源调度粒度、网络互联能力、故障域隔离和计费模型;判断标准是看你的任务是否需要多节点并行、低延迟互联和弹性扩缩容。 如果单机多卡能装下模型且通信不跨机,单机往往更划算;如果模型参数或训练吞吐超过单机上限,集群才是唯一选择。
深圳租用算力集群方案和单机方案怎么选?先看任务类型
选集群还是单机,不是比谁“更高级”,而是比谁更贴合你的计算任务,深圳本地机房资源丰富,但不同方案的成本和运维复杂度差异很大。
从资源调度看:单机是整租,集群是切片
单机方案通常是一台物理服务器,里面插着多张GPU,比如8卡H800或8卡4090,你拿到的是整台机器的SSH权限,想怎么跑就怎么跑,集群方案则是多台物理机通过高速网络连在一起,由调度器统一管理,常见调度器有Slurm、Kubernetes、Ray,你提交任务后,调度器把任务拆到不同节点上。
- 单机:
nvidia-smi能看到所有卡,CUDA_VISIBLE_DEVICES直接控制用哪张。 - 集群:
sinfo或kubectl get nodes查看节点状态,任务通过sbatch或kubectl apply提交。 - 调度粒度:单机按卡或整机,集群按节点或卡时。
从网络互联看:集群靠RDMA,单机靠NVLink
单机内部多卡通信走NVLink或PCIe,NVLink带宽远高于普通以太网,集群跨节点通信必须走网络,主流是InfiniBand或RoCE,如果集群网络没配好,跨机通信会成为瓶颈。
- 检查单机互联:
nvidia-smi topo -m看GPU之间是NVLink还是PCIe。 - 检查集群网络:
ibstat看InfiniBand状态,ibv_devinfo看设备信息。 - 测试实际带宽:用
nccl-tests里的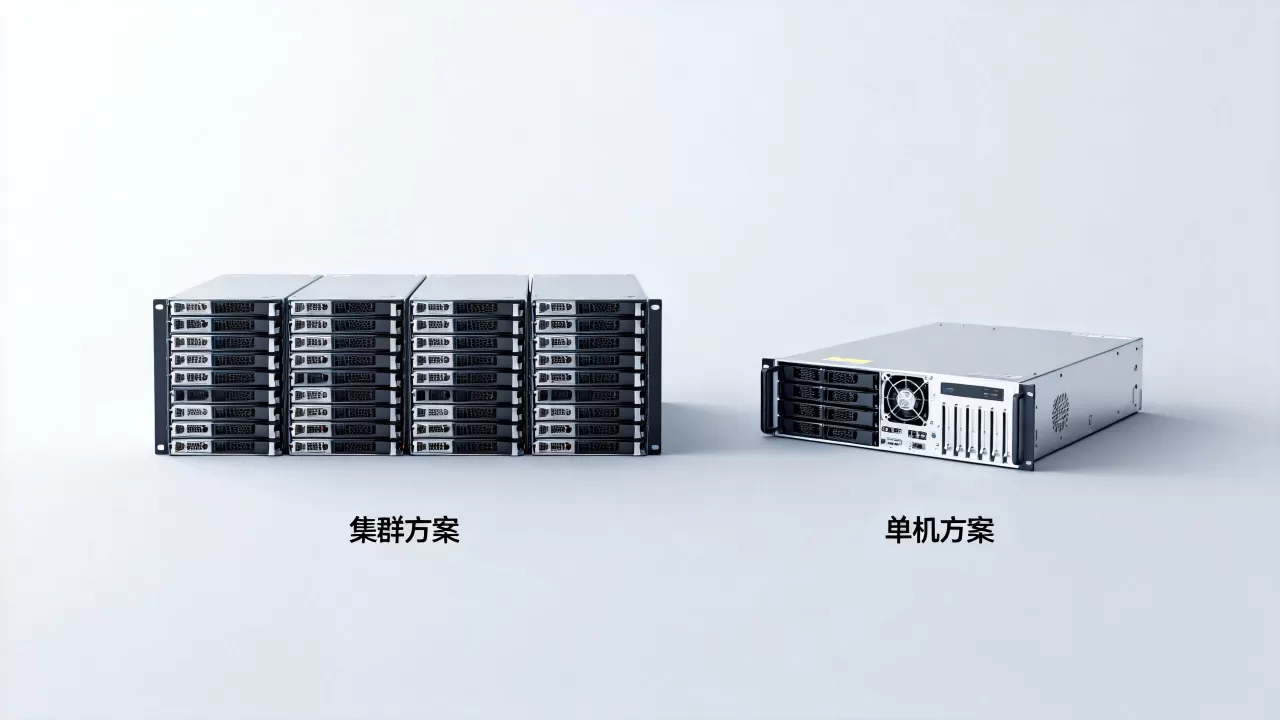
all_reduce_perf
从故障域看:单机一台挂全停,集群可隔离
单机方案没有冗余,一台机器宕机,上面的所有任务中断,集群方案可以把任务分散到不同节点,单节点故障只影响部分任务,但集群的故障排查更复杂,可能涉及网络、存储、调度器多个层面。
深圳租用算力单机方案适合哪些场景?
单机方案在深圳的中小团队里很常见,它开箱即用,不需要理解分布式训练框架的复杂配置,以下场景优先考虑单机。
- 模型推理与API服务:7B到70B模型,用vLLM或TGI单机多卡就能跑,延迟低,部署简单。
- 模型微调与LoRA训练:单机8卡显存足够覆盖多数微调任务,数据并行用
torchrun就能启动。 - 三维渲染与视频编解码:这类任务对跨节点通信不敏感,单机多卡并行效率高。
- 小规模科学计算:单机多核加多卡,用OpenMP加CUDA就能解决。
- 短期测试与原型验证:按小时租一台机器,跑完就释放,成本可控。
业内专家指出,深圳地区单机算力租用需求中,推理和微调占比相当大,这类任务对网络要求不高,单机方案性价比突出。
深圳租用算力集群方案价格和单机方案差多少?
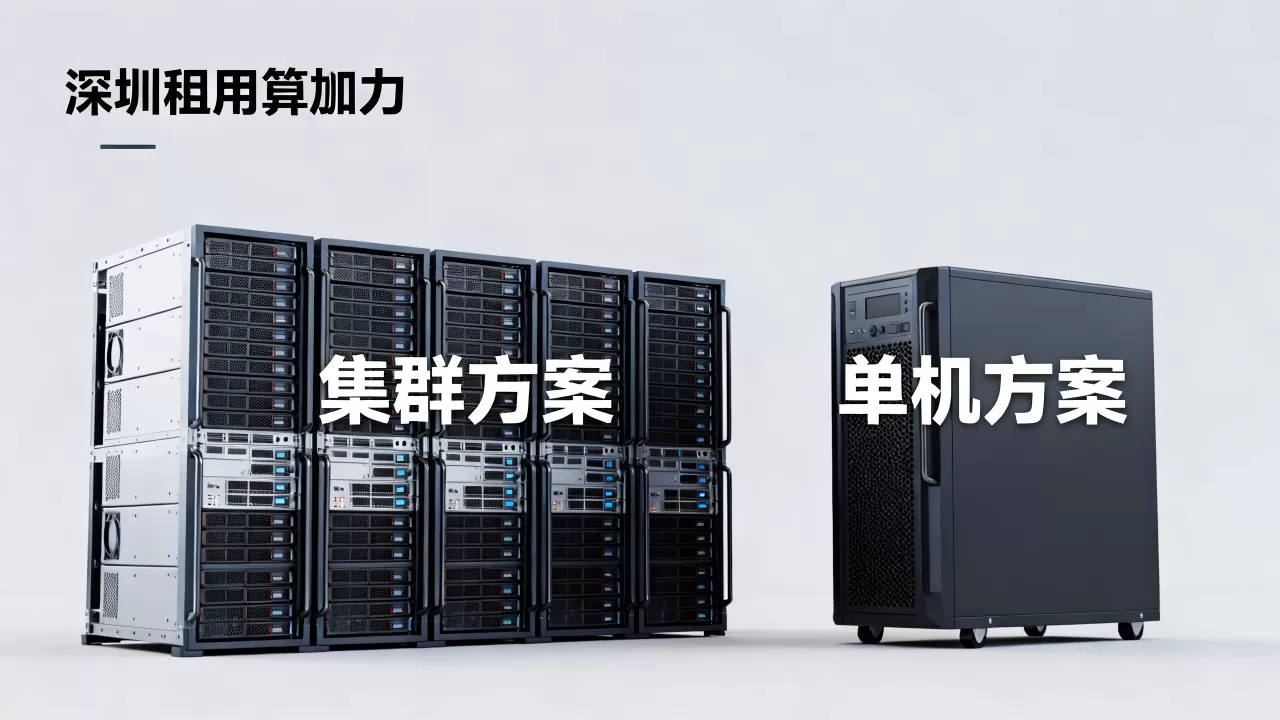
价格差异不能只看每卡时单价,集群方案有网络和存储的附加成本,单机方案则可能浪费闲置算力。
计费模型差异:按卡时 vs 按节点时
单机方案常按卡时计费,比如一张H800每小时多少钱,集群方案通常按节点时计费,一个节点8卡,你租一个节点就是8卡的价格,有些集群支持按卡时但要求最低节点数,比如至少2个节点起租。
- 单机:适合任务规模固定,用多少卡付多少卡。
- 集群:适合弹性扩缩,但最低消费门槛更高。
- 深圳本地机房:单机价格透明,集群价格需要确认是否包含IB网络和并行存储。
隐藏成本:集群的网络和存储开销
集群方案里,高速网络和共享存储不是免费的,InfiniBand交换机、RDMA网卡、并行文件系统都会摊到价格里,单机方案通常只包含本地NVMe,没有额外网络费。
| 对比维度 | 单机方案 | 集群方案 |
|---|---|---|
| 资源粒度 | 整机或单卡 | 多节点切片 |
| 网络 | 本地NVLink/PCIe | InfiniBand/RoCE |
| 扩展方式 | 垂直扩展,换更强卡 | 水平扩展,加节点 |
| 故障域 | 整机 | 节点或机架 |
| 适用任务 | 推理、微调、渲染 | 大模型训练、HPC |
| 计费 | 按卡时或整机 | 按节点时加网络溢价 |
| 运维复杂度 | 低 | 中高 |
深圳本地机房的地域价格特点
深圳机房土地和电力成本较高,但网络延迟低,适合对实时性要求高的业务,单机方案在深圳的供给量大,价格竞争充分,集群方案受限于高速网络设备,价格相对坚挺,如果预算有限,可以先租单机跑通流程,再按需扩容到集群。
深圳GPU算力租用集群与单机对比:五步判断法
别拍脑袋决定,按下面五步走,十分钟就能判断清楚。
- 算显存需求:把模型参数量、优化器状态、激活值加起来,如果单机最大显存能装下,优先单机,比如8卡H800有640GB显存,多数70B模型微调够用。
- 看并行策略:数据并行单机多卡就能做,张量并行和流水线并行必须跨节点,这时候集群是刚需。
- 测通信频率:跑一个
nccl-tests,如果AllReduce耗时占训练步长较大比例,跨机通信会拖慢速度,单机NVLink通常更快。 - 算总拥有成本:单机按卡时,集群按节点时加网络费,把任务总时长乘单价,再对比。
- 看扩展预期:业务如果半年内翻倍,集群的弹性扩缩容更省心,单机只能换机器或加机器,调度灵活性差。
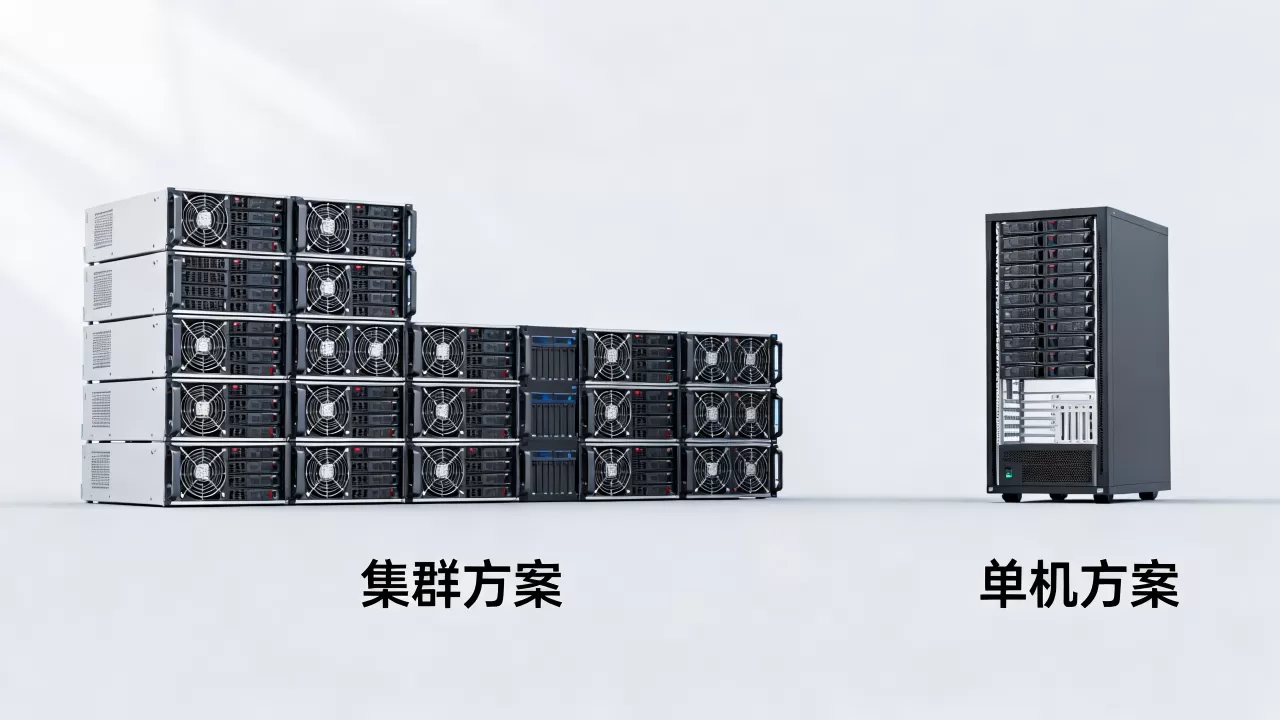
行业共识认为,判断集群和单机的分水岭是“通信计算比”,计算密集、通信稀疏的任务,集群能线性扩展,通信密集的任务,单机反而更稳。
Q&A:深圳租用算力集群和单机差异常见问题
Q1:深圳租用算力时,单机方案能跑大模型训练吗?
取决于模型规模和并行策略,如果模型能在单机多卡显存内放下,且用NVLink通信,单机可以跑,比如用torchrun --nproc_per_node=8启动数据并行,一旦模型超过单机显存上限,就必须用集群做张量并行或流水线并行。
Q2:集群方案一定比单机方案快吗?
不一定,集群跨节点通信走IB或RoCE,延迟高于单机NVLink,如果任务通信密集,集群可能比单机慢,只有当计算量远大于通信量时,集群才能体现扩展优势,建议先用nccl-tests测实际带宽,再决定。
Q3:深圳租用算力,集群和单机哪个更适合初创团队?
初创团队做推理、微调、渲染,单机方案成本低、上手快,按小时租用即可,做基础大模型训练需要集群,但可以按需租用,避免一次性采购,深圳本地机房支持灵活计费,短期项目用集群按节点时结算更实际,判断差异的核心始终是任务并行度和通信需求:单机适合“小而密”,集群适合“大而散”。