在成都租GPU服务器时,训练卡和推理卡的核心区别在于计算精度偏好与吞吐优化方向,选型应优先看业务是“反复调参”还是“持续对外服务”,如果主要做模型训练,选训练卡;如果模型已经训练好并需要对外提供接口,选推理卡。
先弄清训练卡和推理卡区别
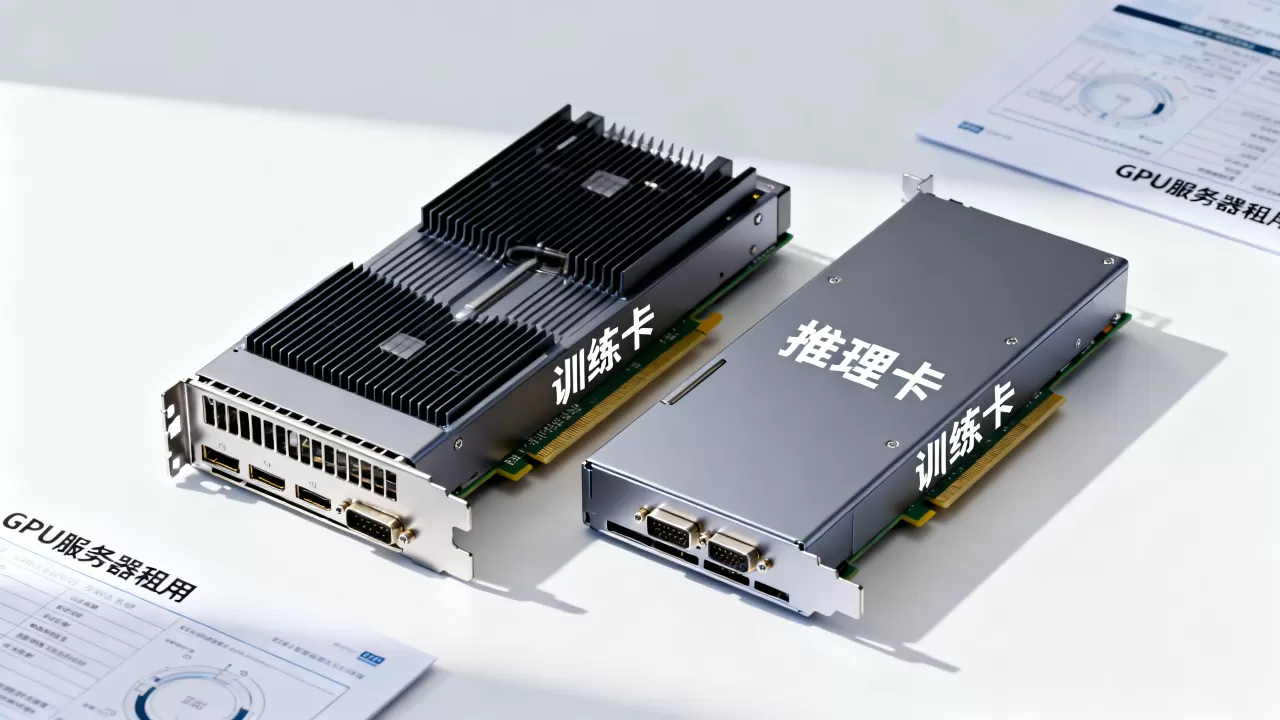
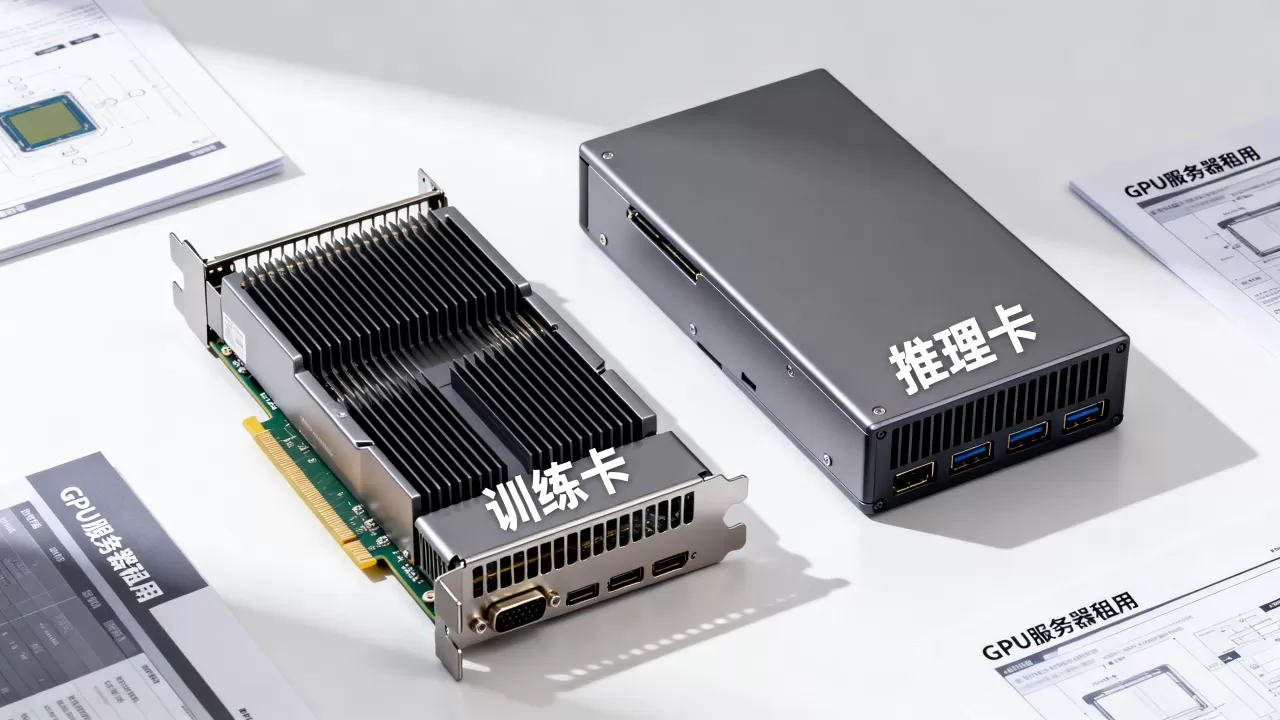
训练卡为长时间、高强度的张量计算设计,重点优化并行计算能力和高精度浮点运算,推理卡则针对单次前向传播做加速,重点优化低延迟、高吞吐和压缩后的模型算子,两者在芯片架构、显存策略和软件生态上都有明显偏向。
训练卡的核心特点
- 支持FP32、FP16、TF32等高精度格式,训练过程需要梯度回传,精度不够会导致模型不收敛。
- 显存容量普遍较大(如数万GB级配置中的80GB/张),为了吃下大批量和长序列数据。
- 算力密度高,多卡互联(如NVLink)带宽大,因为分布式训练卡间通信非常频繁。
- 软件库偏向深度学习框架(PyTorch、TensorFlow)的原生算子,持续优化训练循环。
推理卡的核心特点
- 支持INT8、FP8等低精度格式,模型导成TensorRT或ONNX后,精度损失可控,性能可大幅提升。
- 更关注单个请求的端到端延迟(P99),而不是把一批输入算完的总时间。
- 显存需求相对灵活,有些推理场景反而需要动态批处理(dynamic batching)能力。
- 对视频解码、语音特征提取等前后处理有专门的硬件单元,这在安防、音视频行业非常关键。
一张表看主要差异
| 对比维度 | 训练卡更占优 | 推理卡更占优 |
|---|---|---|
| 精度支持 | FP32/FP16/TF32 | INT8/FP8,少量支持FP16 |
| 并行模式 | 数据并行、张量并行 | 动态批处理、多路并发 |
| 关键指标 | TFLOPS(浮点算力) | 延迟、吞吐(QPS) |
| 显存策略 | 大显存、高带宽 | 显存占用优化、内存复用 |
| 持续负载 | 满载训练数天 | 7×24小时低空闲周期 |
| 典型场景 | 大模型微调、预训练 | 推荐系统、智能客服、图像检测 |
行业共识认为,大部分AI团队在早期会混用两类卡,训练用训练卡,部署用推理卡,但如果你只是做实验或跑一次性仿真,训练卡也能临时当推理卡用,只是性价比会低一些。
成都GPU服务器租用怎么选:看你的真实业务场景
选型时先回答三个问题:模型还在不在改?服务要不要长期在线?延迟有多敏感? 这三个问题的答案基本就决定了该租哪种卡。
跑大模型微调或预训练
这种场景是训练卡的“主场”,比如你在成都租一台8卡A800或H系列机器,跑LoRA微调或者全参数微调,此时需要的是持续数小时甚至数天的稳定算力,对单卡显存和卡间通信要求极高,租训练卡能避免因精度不足导致loss震荡,租推理卡反而会因为低精度优化不足,训练速度慢且容易出bug。
线上API服务,比如聊天机器人、OCR识别
模型已经训练好,需要对外打包成API,这种场景对延迟和并发量极度敏感,以文本生成为例,用户发出请求后,你要在几十到几百毫秒内返回内容,推理卡能做到批量并行处理多个请求,同时用模型压缩和缓存减少显存占用,如果拿训练卡来跑线上推理,算力虽然强,但单卡能承载的并发路数反而更少,单位成本会明显偏高。
视频分析、安防监控这种“边缘味”很重的业务
这类业务通常不是纯深度学习推理,还涉及视频流拉取、解码、抽帧、目标检测后处理,此时选带有视频编解码专用引擎的推理卡会更合适,租的时候要确认卡上有没有NVENC/NVDEC单元,不然还得额外租CPU资源做解码,浪费预算。
科研仿真、渲染、传统数值计算
如果你只用GPU做流体力学模拟、分子动力学或者渲染,不存在“推理”的说法,直接按训练卡租就好,因为这类软件(如GROMACS、LAMMPS、Blender)更看重双精度浮点能力和通用CUDA核心,推理卡的专用算子和你没关系。
成都GPU服务器租用价格差异与隐性成本
很多人只看单卡时租,但总成本 = 单卡价格 × 数量 × 时长 + 网络带宽 + 数据存储,训练卡和推理卡的租用价格差异本身并不大,真正的差距在于承载能力和电力消耗。
价格上的普遍规律
- 在成都当地机房,训练卡(如A100、H800、L40S)的月租价通常高于同代推理卡,因为芯片功耗和显存规格更高。
- 推理卡(如L20、T4、A10)价格相对友好,但单价低不代表总成本低,如果单片并发不足,你可能要租更多的卡,反而更贵。
- 不同机房带宽质量差距大,成都有些机房提供BGP多线,有些只能单线,带宽差异可能让总价差出20%以上,签约前一定问清楚峰值带宽、保底带宽、超额计费方式。
租用时长怎么定最划算
- 按小时租:适合跑临时训练任务、验证代码、调试环境,但要注意:停机时间是否计费、关机后数据是否保留。
- 包月租:适合稳定推理服务,大部分服务商会给7×24小时在线价格,月付折算到每小时通常比按小时便宜不少。
- 长租年付:适合确定要跑半年以上的项目,比如给客户做的定制模型训练,成都本地不少服务商对年付能给出
等价8-10个月
的优惠。
不可忽略的隐性成本
- 数据迁移和存储费用:训练集几百GB,从对象存储拖到GPU机器可能产生流量费。
- 备份费用:推理服务需要快照,快照占用存储也会单独计费。
- 技术支持成本:在成都本地租GPU,能上门处理硬件故障很重要,有些跨城市服务商只能远程,一旦显卡掉卡,等待时间就是钱。
综合考虑的话,性价比最高的方式往往是训练任务按周/按月租训练卡,推理任务包年租推理卡,这样可以把训练的资源波动和推理的稳定负载分开优化。
实操:在成都租GPU服务器时怎么配置与验收
不管最后选训练卡还是推理卡,租用流程里都应该有一套验收动作,下面这些步骤来自实测,能帮你避开很多坑。
第一步:列需求清单并和销售对齐发给服务商,他们才能准确报价:
- 业务类型:训练/推理/渲染
- 模型名称与参数量(比如7B、13B)
- 单卡显存要求(至少多少GB能装下模型)
- 并发路数或训练时长
- 是否需要多卡互联
- 带宽要求(上行/下行,公网IP个数)
第二步:远程连上机器后跑基础检测
用SSH登录后,依次执行:
nvidia-smi # 查卡型号、驱动状态、显存占用
确认系统能识别到全部GPU,并记录显存大小,然后跑一个简单的PyTorch矩阵乘法,确认CUDA和cuDNN版本匹配。
python -c "import torch; print(torch.cuda.is_available()); print(torch.cuda.get_device_name(0))"
第三步:压测“租的卡”而不是“宣传的卡”
很多服务商会给你“演示机”或“相邻配置”测试,但正式交付的可能是不同批次,签合同前要明确:
- 交付的GPU型号必须与报价单一致,包括显存版本(如80GB vs 48GB)
- 多卡机器要跑一次分布式通信测试,用
nccl-tests检查卡间带宽,避免出现卡间互联降级。 - 推理服务要测P99延迟,而不是平均延迟,用压测工具(如
wrk或locust)打满请求量,观察延迟曲线是否陡峭。
第四步:确认退租和续费规则
成都本地机房和云平台不一样,有些起步价就是1个月,有些支持按天,还要问清楚:
- 退租时是否需要将系统盘数据清除(避免数据泄露风险)
- 是否提供备份机或故障替换机,训练大模型中途显卡挂了,服务商有没有应急预案。
把这几步走完,你大概能判断这家服务商是否靠谱,也能避免为配置不符的“低配变高配”买单。
训练卡与推理卡混用时的注意事项
如果你预算有限,想在雪纳瑞这类成都本地服务商处租一台机器同时跑训练和推理,也有办法,但有几个坑必须提前知道。
显存隔离
一张GPU不能简单地切成两半同时跑训练和推理,使用MIG(Multi-Instance GPU)可以按比例划分,但训练任务和推理任务的显存需求都波动大,容易互相挤爆,更稳妥的做法是流量低峰训练,高峰推理,或者租两张卡,一卡专训、一卡专推。
驱动与CUDA版本冲突
训练卡驱动通常更新较频繁,推理卡上跑的TensorRT往往要求特定驱动版本,如果混用,先定推理服务的TensorRT版本,再选训练卡能兼容的CUDA版本,一般CUDA 12.0以上能覆盖大多数主流场景。
温度与机房条件
成都夏季高温时段,机房要是散热不够好,GPU容易降频,训练卡满载时发热量极大,机房PUE和单机柜功率上限要确认清楚,有些便宜机房单机柜只有6kW,插四张高性能卡就会触发过载保护。
Q&A:成都GPU服务器租用价格和选型疑问
问:成都GPU服务器租用价格为什么差异很大?
答:价格差异主要来自三个环节:芯片型号新旧、机房带宽质量、服务商运维团队规模,同一张A100,老机房和新机房月租能差出数千元,老机房的电力成本低但稳定性差,新机房带宽贵但延迟低,能提供快速换卡和技术支持的服务商,通常会在价格里包含服务费,租之前一定要拆分开问:裸机价格多少?带宽价格多少?含几次上门服务?
问:训练卡和推理卡能否通用?
答:通用但不划算,深度学习框架直接跑推理时,训练卡和推理卡没有本质区别,只要驱动和CUDA装好,但推理卡经过厂商的算子级优化后,同等价格下能承载的并发请求量往往是训练卡的1.5倍以上,反过来,用推理卡跑训练会因为低精度支持不足,导致模型精度下降或训练时间变长,所以长期项目建议各司其职,短期测试可以随便用。
问:怎么判断自己该租多少卡?
答:训练场景用一个公式估算:参数量(亿)除以每卡显存可用比例(约70%)得到单卡可训练最大模型规模,再用期望训练并行度除以单卡吞吐量,推理场景更简单,先打一次基准:看单卡能跑多少路并发、每秒处理多少请求,再用业务峰值QPS除以单卡QPS,向上取整得到卡数,如果算出来卡数大于16,建议先考虑优化模型或改用更小显存版本的配置,而不是盲目加卡。
租用GPU的核心逻辑不是“追新”,而是让算力消耗与业务类型对齐,在成都,训练选高精度、大显存的训练卡,推理选低延迟、高并发的推理卡,并把带宽、备件、续费规则都签进合同,你的预算才能真正花在刀刃上。