佛山GPU服务器租用和普通服务器的费用差距,主要来自GPU显卡本身的资产成本、电力散热开销和机柜资源的隐性占用,同规格下GPU服务器月租通常是普通服务器的数倍到十几倍,但两者并不是替代关系,而是服务不同负载的两类产品。下面把每一笔账拆开算清楚,帮你判断自己到底该租哪一种。
佛山GPU服务器和普通服务器费用区别,差的不只是那张显卡
很多人以为GPU服务器贵,就是贵在显卡,这个理解只对了一半,显卡是最大的一块,但真正把月租推高的,是显卡带出来的一整串连锁成本。
硬件账面:一张卡顶一台整机
普通服务器的主流配置,比如双路至强或EPYC、128GB内存、几块NVMe固态,整机采购价在一个相对可控的区间,而一张面向AI训练的加速卡,单卡采购价就可能超过整台普通服务器。
机房出租方是按资产折旧摊到月租里的,业内通行做法是按24到36个月折旧,再加上资金占用和毛利,这意味着显卡越贵,月租里"卡的成本"占比越重。
直接结果就是:
- 普通服务器:月租大头是CPU、内存、硬盘、机柜和带宽
- GPU服务器:月租大头是显卡折旧,其余部分反而是零头
电力与散热:被忽略的第二笔账
一张高功耗加速卡的整板功耗,通常在300W到700W区间,旗舰型号更高,8卡整机满载时,整机功耗轻松突破3kW到5kW。
普通服务器满载通常在400W到800W之间,差距在3到8倍。
这带来的连锁反应:
- 电费按功耗计,佛山工业电价虽相对友好,但功耗差摆在那
- 散热要跟得上,风冷机房对高密度GPU机型往往需要单独规划风道
- 部分高密度机型需要液冷或冷板方案,进一步抬高成本
行业共识认为,GPU服务器的电力与散热成本,通常占其总运营成本的两成到三成,而普通服务器这一比例要低得多。
机柜U数与承重:物理空间的隐性溢价
一台8卡GPU服务器多为4U到8U机架式,且重量大,对机柜承重和配电有要求,普通1U、2U服务器可以高密度堆叠,单柜能放的机器数量多。
同样一个42U机柜,放普通服务器可能装十几台甚至更多,放GPU服务器可能只装几台。
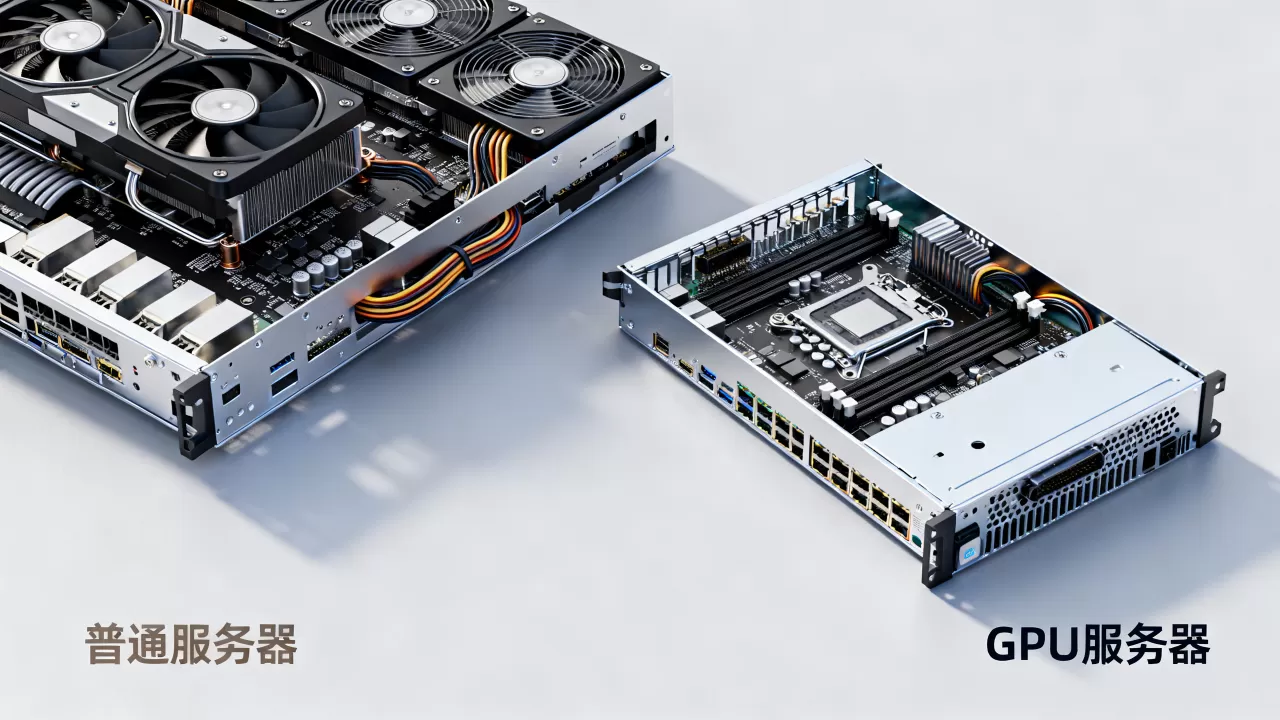
单位U的产出效率不同,机房自然要按不同单价计费。
佛山GPU服务器租用多少钱一个月,钱花在哪几个环节
这个问题没有统一答案,但报价的构成逻辑是清晰的,把它拆成四块,你就能自己估出区间。
影响报价的四个变量
显卡型号与数量
这是第一决定因素,上一代推理卡和当前主流训练卡,单卡月租能差好几倍,1卡、4卡、8卡的整机价格也不是线性叠加,因为8卡机型还要配更高规格的CPU、内存和电源。
显存容量与卡间互联
大显存卡能装下更大的模型,互联带宽高的卡在多卡并行时效率更好,这两项都会直接体现在报价上,做70B参数级别模型微调和做7B模型推理,需要的配置完全不是一个量级。
带宽与IP资源
GPU服务器常需要拉取数据集、上传模型权重,佛山本地机房到广州、深圳的网络时延低,多数场景够用,但如果要对外提供推理API服务,带宽和防御能力就是额外成本项,普通服务器对带宽的要求通常低一些。
是否含运维与镜像
纯裸金属出租、含基础运维、含CUDA环境预装和容器平台,价格是阶梯式的,省下来的自建时间也是成本。
一个直观的对比表
| 对比项 | 普通服务器 | GPU服务器 |
|---|---|---|
| 月租量级 | 低,百元到千元级 | 高,千元到数万元级 |
| 成本大头 | CPU、内存、机柜、带宽 | 显卡折旧、电力、散热 |
| 整机功耗 | 几百瓦 | 数千瓦 |
| 单柜可放数量 | 多 | 少 |
| 折旧周期 | 3到5年 | 2到3年 |
| 适用负载 | Web、数据库、存储、轻量计算 | 训练、推理、渲染、科学计算 |
需要说明的是,上表只是结构对比,具体数字随配置和市场波动很大,不要拿一张固定价目表套所有需求。
普通服务器租用在佛山为什么便宜,便宜在哪
普通服务器便宜,不是机房让利,而是它的成本结构本来就轻。
- 硬件单价低,折旧压力小
- 功耗低,电费和散热开销可控
- 体积小,单柜密度高,摊薄了机柜成本
- 技术成熟,运维标准化,人力成本低
- 二手和企业退役设备流通量大,进一步压低市场价
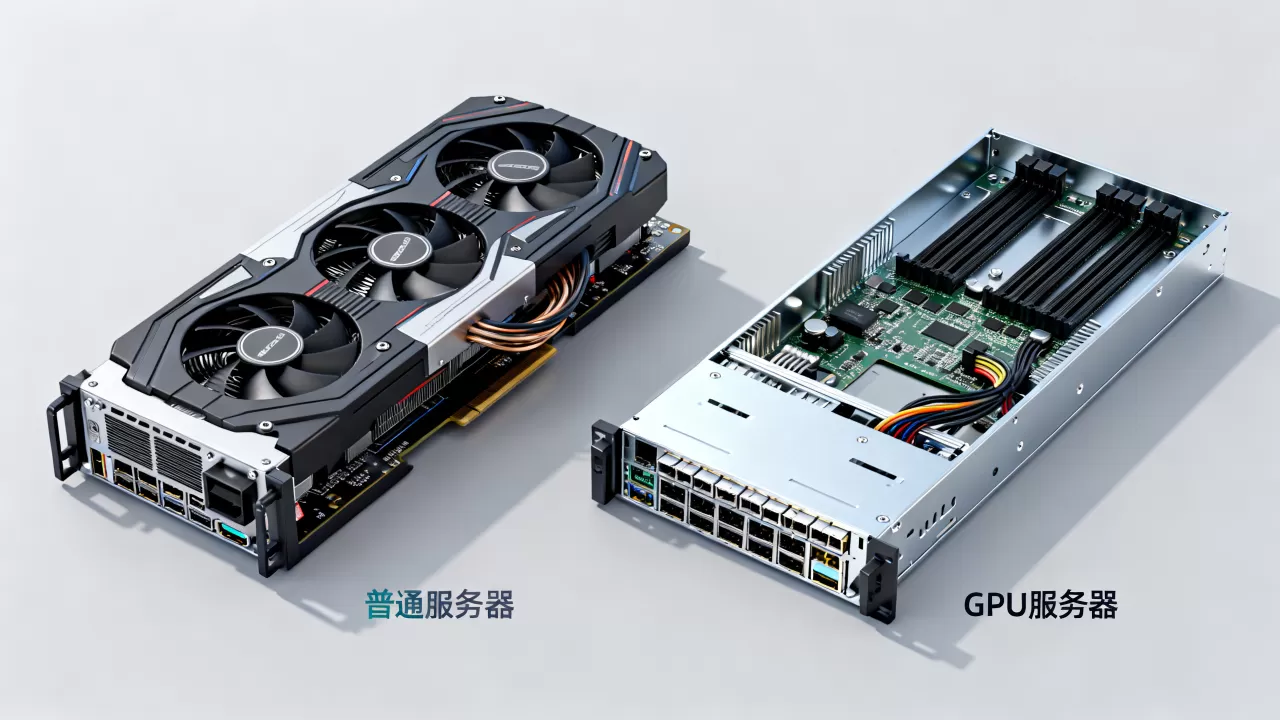
所以如果你的业务是网站、商城、ERP、数据库、文件存储、轻量爬虫,普通服务器完全够用,上GPU就是纯浪费。
什么场景该上GPU,什么场景普通服务器就够
判断标准很简单:看你的计算是不是可以拆成大量并行的矩阵运算。
该上GPU的场景:
- 深度学习模型训练与微调
- 大模型推理服务、私有化部署
- 视频转码、批量图像处理
- 三维渲染、仿真计算
- 生信分析、分子动力学等科学计算
普通服务器就够的场景:
- 企业官网、小程序后端
- MySQL、Redis、PostgreSQL等数据库
- 对象存储、备份归档
- 常规业务系统、办公OA
- 低并发的API网关
如果你的任务是"跑得快一点",先看是不是代码没优化、索引没建好。先榨干CPU侧的性能,再考虑上GPU,这是省钱的基本顺序。
佛山本地租用的地域因素,会影响你的账单吗
佛山紧邻广州,本地机房多分布在南海、禅城、顺德一带,与广州、深圳的网络互联质量好,地域对费用的影响主要体现在三点:
- 电费与政策:佛山制造业基础厚,部分园区对高载能机房有配套政策,但这部分红利未必直接传导到租户
- 网络时延:做本地业务或对接广深客户,佛山节点时延表现不错,节省了跨地域带宽成本
- 运维响应:本地机房支持上门,出故障时处理更快,间接降低停机损失
做佛山AI训练服务器租赁选型时,建议先确认机房到你的数据源和用户群的实测时延,别只看价格。
实操:三步估出你该花多少钱
第一步,量化你的算力需求
登录一台测试机,跑一下:
nvidia-smi
看显存占用和GPU利用率,如果训练时显存接近打满,说明卡不够,要么加卡要么换大显存型号。
再看模型规模:
python -c "import torch; print(torch.cuda.is_available())"
确认CUDA环境可用后,用你的真实批次大小跑一轮,记录每步耗时。
第二步,算清总拥有成本
不要只比月租,把这几项列进表格:
- 月租费用
- 数据迁移和存储费用
- 带宽超量费用
- 环境搭建的人力时间
- 业务停机风险
第三步,做对比测试
同一份代码,分别在GPU服务器和普通服务器上跑一遍,据统计,在典型深度学习负载下,GPU相对CPU的加速比可能达到几十倍,但在简单脚本或小数据量任务上,差距会缩小到可以忽略。差距小的任务,就用普通服务器。
佛山GPU服务器租用和普通服务器的费用差,本质是资产结构和能耗结构的差,不是简单的"贵"和"便宜",先看负载是不是真的并行计算密集,再决定掏哪份钱,这一步判断错了,后面省下的都是小数。
佛山GPU服务器租用费用对比常见问答
问:佛山GPU服务器租用价格比普通服务器高多少,有没有大概范围?
答:没有统一倍数,1卡入门推理机型与高配普通服务器的月租可能只差两三倍,而8卡训练机型与普通服务器能差十几倍甚至更多,差距主要取决于显卡型号、卡数、是否含运维,以及机房对高功耗机型的电力和散热计费方式,建议按"显卡折旧+电力散热+机柜占用+带宽+运维"五项分别询价。
问:只做模型推理不做训练,还需要租GPU服务器吗?
答:要看并发量和响应时间要求,低频、小模型、可接受秒级响应的场景,用CPU加量化优化也能跑,但如果要求毫秒级响应、并发请求多、模型参数量大,GPU推理服务器的单位请求成本反而更低,可以先在本地用CPU跑一轮压测,记录P99延迟,再决定是否上卡。
问:佛山本地机房的GPU服务器和广州机房相比,租用费用有区别吗?
答:同配置下两地报价通常接近,差异更多来自机房的电力配额、散热方案和带宽资源,而非城市本身,佛山部分机房在高功耗机型的配电和承重上做了专门改造,这部分会反映在单价里,选型时更该关注的是机房的实测网络时延、是否有现货机型、故障响应时效,以及合同里对电力超额的计费条款。