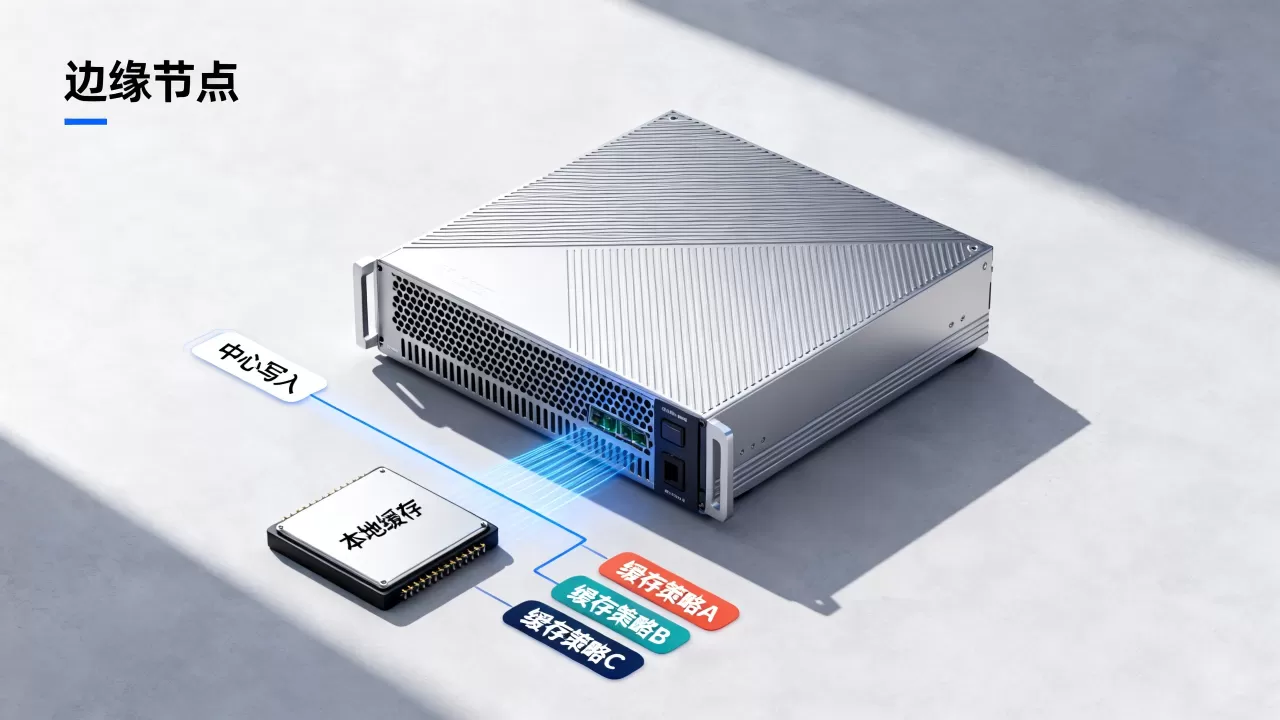
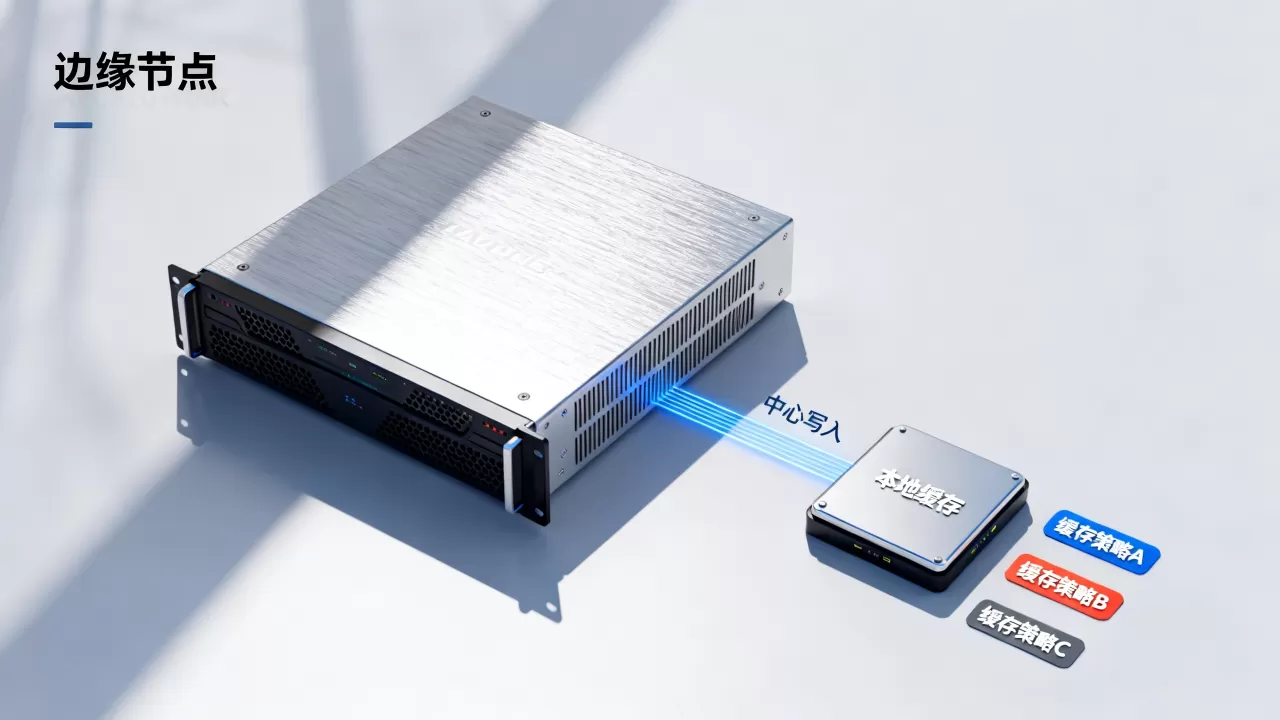
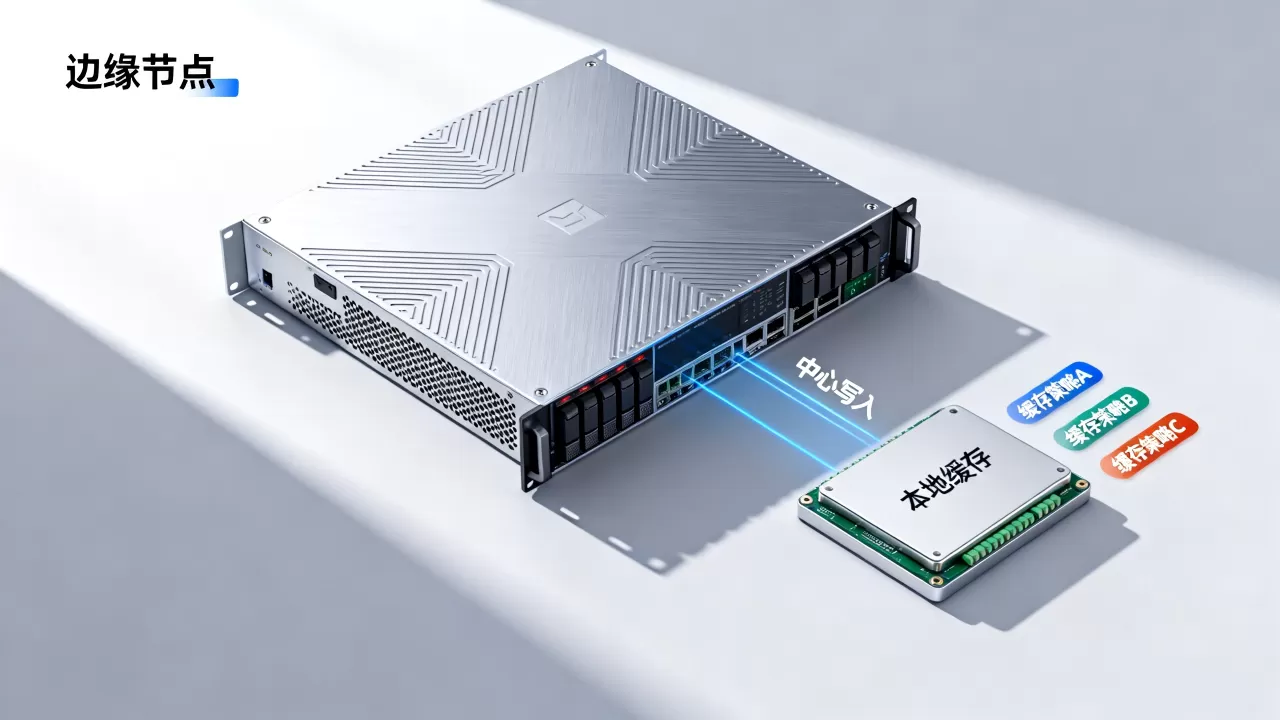
边缘节点用本地缓存缓解中心写入瓶颈,核心做法是在边缘设备或边缘网关部署本地缓存层,把高频写入先合并到内存或磁盘,再以批量、异步方式回传中心数据库,从而显著降低中心端的并发写入压力。
边缘节点本地缓存怎么缓解写入瓶颈
很多做物联网、CDN或边缘AI的团队都会遇到同一个问题:中心数据库写入线程经常被打满,监控面板上磁盘IO和连接数长期高位运行,边缘设备每秒钟上报几十次状态,单台压力不大,但当成千上万个边缘节点同时写入时,中心端就会变成瓶颈。
中心写入瓶颈具体卡在哪
- 数据库连接数爆掉:每个边缘设备直接连中心库,连接池很快耗尽。
- 磁盘随机写放大:高频小数据写入会触发大量随机IO,机械盘和普通云盘都扛不住。
- 网络带宽占满:海量小包频繁传输,有效数据占比低,带宽成本被推高。
- 锁竞争加剧:中心端写入接口同时处理大量并发写,行锁和表锁等待时间变长。
本地缓存如何把写入压力“挡”在边缘
边缘节点本地缓存相当于在数据源头和中心数据库之间加了一层缓冲,边缘应用不再直接写中心,而是先把数据写入本地的内存或磁盘缓存,缓存层会做三件事:合并、去重、批量同步。
常见的配置是采用write-back写回策略,边缘节点收到写入请求后,先落到本地缓存,立即返回成功,后台定时任务按照固定间隔或缓存积压量触发批量上传,中心端每次只处理一批数据,而不是每秒处理几万次单条写入。
边缘计算本地缓存方案对比:内存、磁盘与混合缓存
行业共识认为,边缘侧缓存不是简单加一层存储,而是写入路径上的缓冲与整形,不同方案在写入速度、数据可靠性、成本和适用场景上有明显差异。
| 方案 | 写入速度 | 数据可靠性 | 部署成本 | 适用写入频率 |
|---|---|---|---|---|
| 内存缓存(Redis) | 高 | 较低,断电可能丢数据 | 中 | 高,如传感器状态上报 |
| 磁盘缓存(RocksDB/LevelDB) | 中 | 较高,落盘保存 | 低 | 中,如日志、元数据 |
| 混合缓存(内存+磁盘) | 高 | 高,异步刷盘 | 中高 | 高且要求不丢数据 |
| 消息队列缓冲(EMQX/MQTT) | 中高 | 中,依赖持久化配置 | 中 | 中高,如设备消息流 |
不同写入场景该选哪种缓存
- 工厂传感器高频小数据:优先选内存缓存,配合AOF或RDB持久化,保证断电后大部分数据可恢复。
- 视频监控元数据频繁写入:选磁盘缓存,写入量稳定,可靠性要求高,成本低。
- 边缘交易类业务:使用write-through写穿策略,本地缓存和中心同步确认,牺牲部分性能换一致性。
- 车联网位置轨迹数据:用混合缓存,内存扛峰值,磁盘兜底,批量上传时压缩后再回传。
成都边缘节点本地缓存部署多少钱
成都地区的边缘节点部署成本主要看三个因素:服务器或边缘网关规格、内存和磁盘容量、云专线带宽,如果使用云厂商的成都边缘计算实例,4核8G内存和8核16G内存的月价格差异会比较大,通常后者是前者的一倍以上。
开源方案本身不收费,比如Redis、KubeEdge、OpenYurt都可以直接部署,但云厂商提供的边缘托管服务会按实例规格和流量计费,如果自己买工控机放在成都机房,一次性硬件投入和托管电费就是主要成本,多数中小规模场景下,先用一台8G内存+256G固态盘的边缘服务器跑缓存,成本比升级中心数据库集群要低得多。
边缘节点写入压力大怎么办:本地缓存落地步骤
下面给出一个可以直接照做的落地流程,假设中心端是MySQL,边缘节点是Ubuntu系统,本地缓存用Redis。
第一步:安装并配置边缘缓存服务
在边缘节点执行:
sudo apt update
sudo apt install redis-server -y
修改配置文件/etc/redis/redis.conf:
maxmemory 2gb
maxmemory-policy allkeys-lru
appendonly yes
appendfsync everysec
重启服务:
sudo systemctl restart redis-server
第二步:改造边缘应用写入链路
把原来直接连接中心数据库的写入地址,改成边缘节点本地Redis地址,例如原代码里的数据库连接串改成:
redis://127.0.0.1:6379
边缘应用写完本地缓存后立即返回,不再等待中心确认。
第三步:部署批量同步任务
在边缘节点写一个定时脚本/opt/edge-sync/upload_batch.sh,把本地缓存里积压的数据批量上传到中心数据库,使用crontab配置:
/5 /opt/edge-sync/upload_batch.sh
脚本逻辑可以是:从Redis读取一批数据、压缩、通过HTTPS批量发送到中心API,然后删除已上传的缓存键。
批量同步策略怎么配才不丢数据
批量同步有几个关键参数需要根据业务调整:
batch_size:单次上传条数,一般设置在300到800条之间,太小起不到聚合作用,太大会增加超时风险。flush_interval:刷盘间隔,对实时性要求高的场景设成5秒到10秒,日志类场景可以设成30秒到60秒。retry_limit:失败重试次数,建议设成3到5次,超过重试上限的数据复制到失败目录,等网络恢复后再补传。compression:开启gzip或lz4压缩,边缘上传时能明显减少带宽占用。
用KubeEdge还是OpenYurt做边缘节点本地缓存
如果边缘节点跑在Kubernetes体系里,两个主流方案都支持本地缓存能力。
- KubeEdge:EdgeCore组件可以在边缘侧缓存设备数据,断网时继续接收写入,网络恢复后批量同步到云端。
- OpenYurt:节点自治能力较强,适合边缘节点数量多、分布广的场景,配合本地存储组件能实现写入缓冲。
多数情况下,单机部署用Redis足够,如果边缘节点本身已经接入K8s,再考虑KubeEdge或OpenYurt,避免堆叠太多组件。
边缘节点本地缓存实施中的常见误区
所有写入都往本地缓存塞
缓存不是垃圾桶,只把高频、可容忍短暂延迟的写入放到边缘缓存,核心交易数据还是走中心直接写,避免一致性问题。
只加内存不落盘
边缘节点断电是常态,只写内存不落盘,掉电就可能丢失大量数据,Redis必须开启AOF,或者采用内存+磁盘混合方案。
批量间隔设置过长
为了攒批而把flush_interval设成几分钟,会导致中心端数据长时间不更新,上层业务如果依赖准实时数据,会出问题,通常按数据容忍度倒推刷盘间隔。
忽略缓存驱逐和监控
边缘节点磁盘写满后会阻塞写入,需要配置Redis的maxmemory-policy,磁盘缓存要做容量滚动删除,同时监控本地缓存命中率、驱逐次数、批量同步延迟,避免缓存层本身成为新瓶颈。
中心数据库的写入压力,很多时候不是靠升级硬件能根本解决的,把写入缓冲放到边缘节点本地,用批量异步的方式替代高频直连,是当前边缘计算架构里成本较低、见效较快的做法,思路不复杂,关键是选对缓存介质、控制好批量同步参数、做好断网和断电保护。
边缘节点本地缓存相关问答
边缘节点本地缓存会拖慢数据实时性吗
取决于同步间隔,如果把flush_interval设成5秒到10秒,中心端数据延迟基本可以控制在秒级,对实时性要求高的场景,可以改用write-through模式,本地缓存写入同时同步到中心,性能提升有限,但数据一致性更好。
边缘节点缓存满了怎么办
设置缓存上限和淘汰策略,Redis可以用allkeys-lru淘汰最少使用的键,磁盘缓存按文件大小或时间滚动删除,写入链路里还要加保护逻辑,缓存占用超过阈值时暂停边缘写入或直接转为中心写入,避免内存溢出。
成都边缘节点本地缓存部署需要额外购买软件授权吗
Redis、KubeEdge、OpenYurt等主流方案都是开源软件,直接下载部署即可,不产生软件授权费用,云厂商提供的边缘计算托管服务按实例规格、存储容量和流量计费,成都地区的价格与其他一线城市相比差异较小。