丢包是根因,卡顿是表象,数据包在传输途中丢失后,接收端因缺数据而被迫等待,等待即卡顿。但要真正捋清这条传导链,得先拆开“丢包”是怎样一步步演变成用户感知到的“卡顿”的,中间还隔着缓冲、重传和抖动这三位“缓冲员”,搞清楚这条链路,你排障时就不会再眉毛胡子一把抓。
第一条传导链:TCP重传机制下的“等待型卡顿”
丢包本身不直接等于卡顿,让卡顿发生的是“重传等待”。
主流网络传输分为TCP和UDP两条路,网页、文件下载走TCP,它是个“较真先生”,丢了一个包绝不会善罢甘休,必须重传,我们可以把TCP的传输想象成寄挂号信:发件人寄出后必须收到回执,没收到就重发,这本身没问题,问题在于重传需要时间。
- 丢包发生后,发送端要等超时计时器耗尽才意识到“丢了”
- 然后发送端重新发送数据
- 接收端在等待重传期间,播放缓冲区里的数据只出不进
假设你正在看直播,播放器每秒消耗25帧画面,缓冲池里攒了2秒的余粮,此刻网络丢包率达到较高比例,TCP开始重传,重传往返耗时若超过缓冲余量,播放器手里的“余粮”被吃光,卡顿就出现了,这就是为什么丢包率只有1%-2%时用户没感觉,一旦超过缓冲深度,卡顿就断崖式爆发。
这里有个行业共识:TCP拥塞控制算法(如Cubic、BBR)在丢包后会主动降低发送速率,这相当于交通管制,路堵了,车流降速,即使后续路况恢复,提速也需要时间,这种“后遗症”型卡顿最隐蔽,你看着丢包率已经降下来了,但卡顿还在持续,因为传输速率尚在爬坡恢复期。
排障提示:遇到“丢包率已归零但画面仍卡”的情况,先查TCP发送窗口和拥塞窗口的恢复曲线,这往往是问题症结。
第二条传导链:UDP与实时音视频的“抖动型卡顿”
实时音视频不用TCP,多数走UDP,它不管丢不丢,只管发。 UDP像个莽汉,把数据包扔出去就完事,丢了不重传,那么UDP场景下,丢包又是怎么变成卡顿的?
关键在于网络的抖动叠加效应,数据包在网络中是“挤公交”模式,不按顺序上车,到达时间有早有晚,丢包会让原本就波动的网络雪上加霜某个包丢了,它前后包却按时到了,接收端一看,中间缺了一段,这段缺口的等待时间就是
网络抖动。
以音视频通话为例,接收端的Jitter Buffer(抖动缓冲)是用来熨平网络波动的海绵垫。
- 网络正常时,海绵垫吸走微小抖动,数据平整输出
- 丢包发生时,海绵垫无法自动生成缺失数据,必须等后面到达的数据块填补缺口
- 等不到,就直接跳过这段数据,于是画面冻结或声音断断续续
视频会议卡顿丢包怎么排查?业内用得最多的路径是三步走:先看WiFi信号强度与路由器丢包日志,再看云端媒体服务器的丢包统计,最后对比客户端本地抓包的丢包时间点是否与卡顿时间戳重合,三者时间轴吻合,基本就能锁定丢包源头。
对抗丢包的缓冲博弈
这里有一个设计上的“跷跷板”:
| 缓冲策略 | 对抗晚到丢包 | 副作用 |
|---|---|---|
| 加大Jitter Buffer | 能等更久,减少因晚到导致的卡顿 | 延迟增大,对话有“对讲机感” |
| 减小Jitter Buffer | 延迟低,对话自然 | 一旦丢包抖动,直接卡顿或声音破碎 |
丢包率并非孤立指标,它与延迟指标共同决定卡顿是否可感知,工程上常用“延迟×丢包率”来估算可体验质量,若二者乘积超过播放缓冲深度,卡顿是必然而非偶然。
第三条隐蔽链路:前向纠错(FEC)失效引发的连环卡顿
有些实时系统会启用FEC(前向纠错),发送端额外附赠冗余包,接收端即使丢了一部分数据,也能靠冗余包“拼图”还原,但这套机制有个临界点:
- 丢包率低于冗余度(比如冗余20%,实际丢包10%),卡顿率几乎为零
- 丢包率逼近冗余度(实际丢包18%),接收端刚能勉强修复
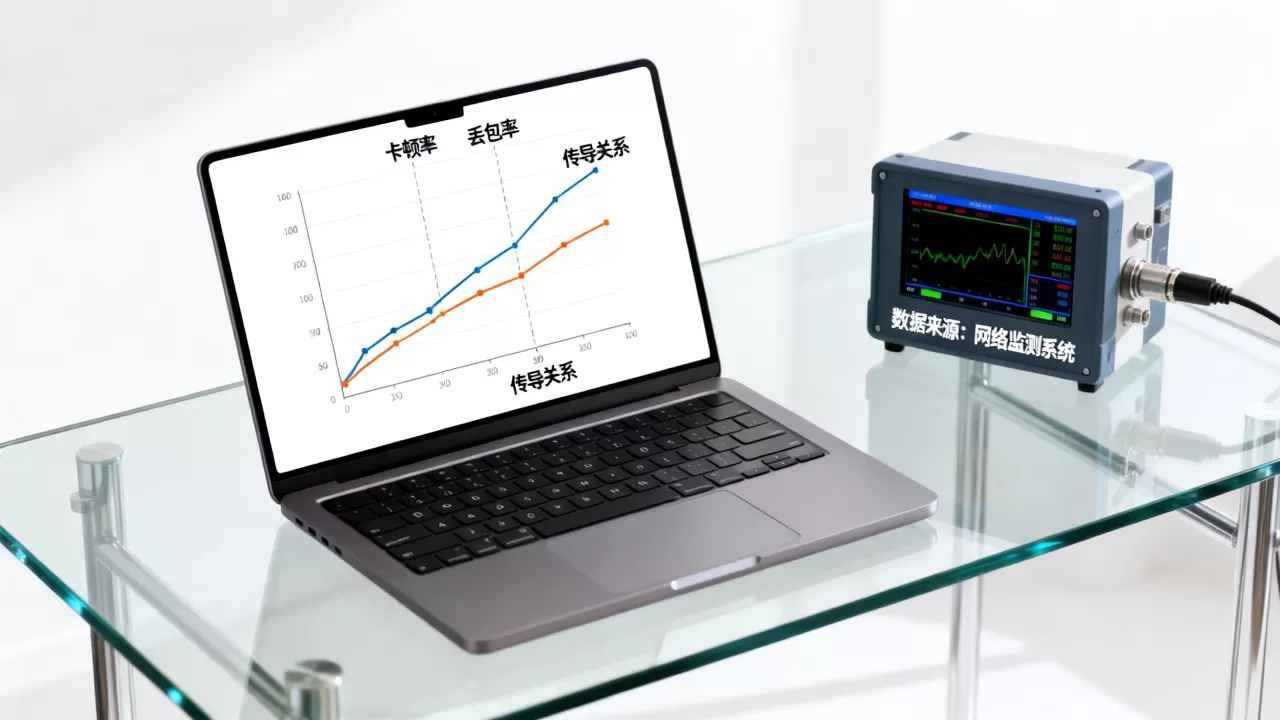
- 丢包率超过冗余度(实际丢包25%),FEC彻底失效,卡顿率的上升斜率会陡然变陡
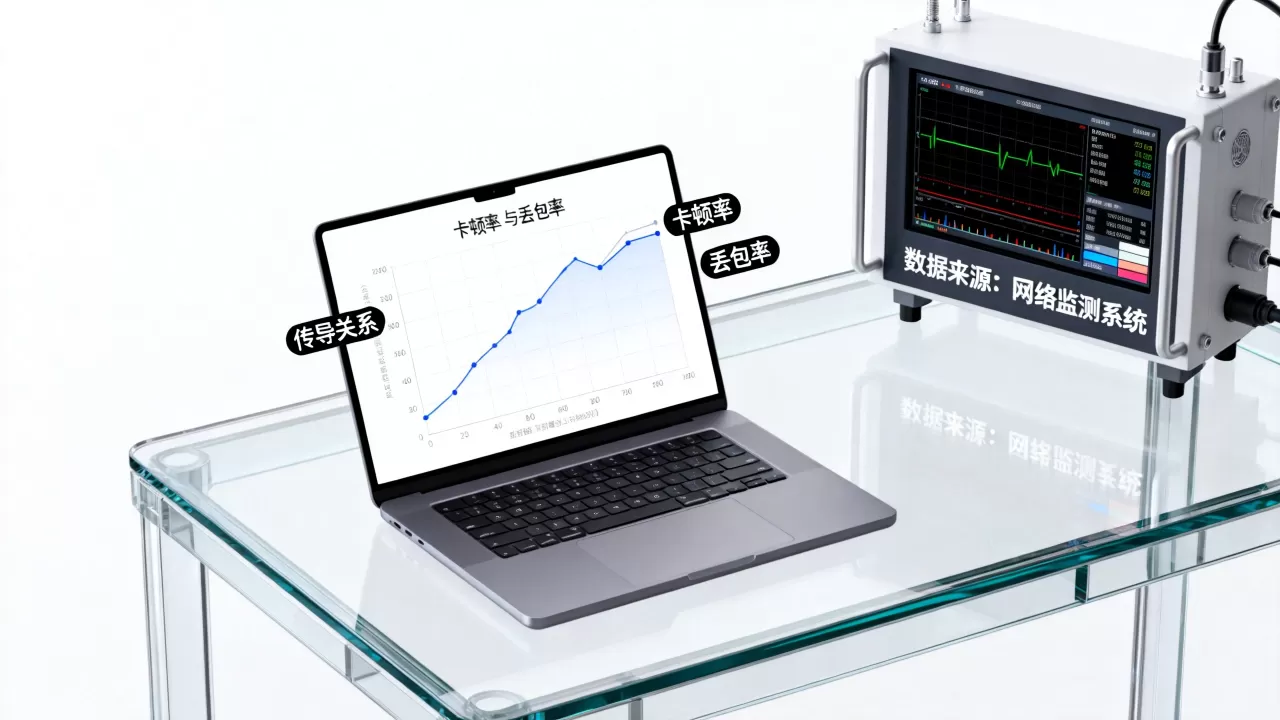
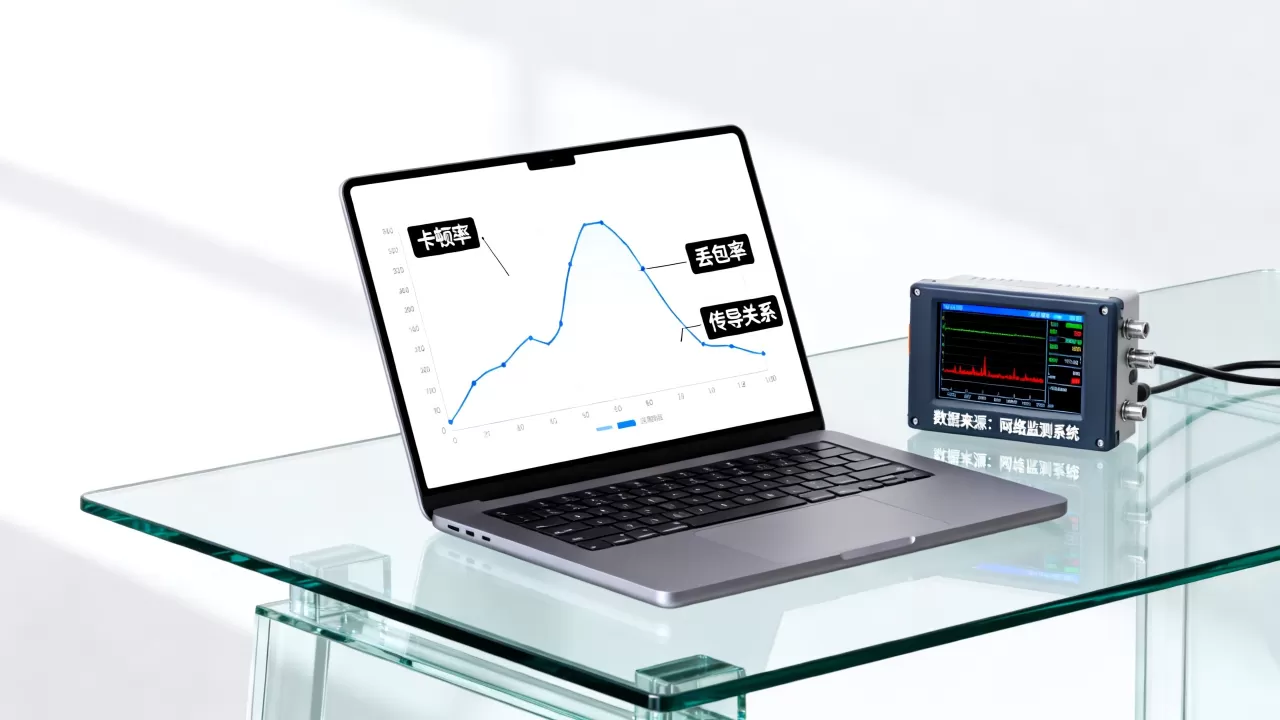
这不是线性的。卡顿率对丢包率的响应曲线呈指数级拐点,丢包率5%时卡顿率可能只有1%,但丢包率跳到10%时卡顿率可能暴涨到15%甚至更高,运维监控时若只盯着丢包率数值而无视拐点,往往会错过最佳干预时机。
视频会议中的“三大丢包入口”
| 丢包入口 | 典型场景 | 特征 |
|---|---|---|
| 无线空口丢包 | Wi-Fi干扰、蓝牙共存干扰 | 突发性强,持续时间短 |
| 家庭上行丢包 | 光猫老旧、PON口拥堵 | 持续存在,速率受限 |
| 骨干网丢包 | 跨运营商互联带宽不足 | 有规律,晚高峰加剧 |
直播延迟和丢包率区别在于:延迟影响的是对话体验,丢包影响的是画面完整性,但实际操作中,高延迟会加剧丢包的副作用延迟越高,发送端对网络状态的感知越滞后,调整码率的反应越慢,丢包造成的“空窗期”越长,这也是为什么跨地域视频会议容易卡成“PPT”,因为二者叠加了。
卡顿率与丢包率的实际排查操作路径
当用户反映“画面卡顿”时,正确的排查顺序是从业务层往物理层剥洋葱,按以下链路逐层验证:
- 第一步:打开客户端侧统计面板,核对丢包率数值与卡顿时间段是否对齐,若不对齐,大概率不是丢包引起,转向排查CPU解码能力或渲染性能
- 第二步:若对齐,区分是上行丢包还是下行丢包,上行丢包通常表现为对方看到你卡,下行丢包是你看到对方卡
- 第三步:Ping网关地址,对比内网丢包率,若内网丢包率接近0而公网丢包高,问题出在运营商链路,需联系ISP或考虑CDN节点切换
游戏场景里的特殊传导
游戏卡顿是网络延迟还是丢包?这两者的手感完全不同:
- 高延迟:操作有“粘滞感”,按下技能键后隔0.5秒才响应,但响应后动作流畅
- 丢包:操作有“跳跃感”,角色瞬移、技能无反馈、画面卡住后突然快进
游戏比视频更怕丢包,因为游戏协议中状态同步包一旦丢失,客户端无法预测后续状态,只能硬等服务器下一次全量状态帧,部分游戏采用延迟补偿算法来掩盖这一过程,但补偿能力有限,丢包率超过一定阈值后,任何算法都无力回天。
降低卡顿率的工程实践清单
按照投入产出比从高到低排列:
- 启用ARQ(自动重传请求)与FEC混合模式
:丢包率低时用ARQ,丢包率升高后自动切入FEC,用冗余换连续性
- 码率自适应:实时监测丢包率,丢包每上升一个台阶,主动降一档码率,宁可清晰度低一点,也不要卡顿
- 接入多路径传输:同一路视频流拆成两条路径传输,单条路径丢包率再高,另一条路径能兜底,目前主流云会议厂商的边缘节点调度策略正是在做这件事
- 部署边缘节点:让数据从距离用户最近的边缘节点接入骨干网,缩短物理传输距离能同时降低延迟和丢包概率
这些措施的本质是用容量换时间,用冗余换确定性。
卡顿率与丢包率常见问题解答
问:卡顿率与丢包率成正比吗?
答:不成正比,呈近似指数关系,丢包率低于网络缓冲区冗余量时,卡顿被完全吸收,卡顿率趋近于零;当丢包率突破缓冲冗余临界值,卡顿率会以数倍于丢包率的增幅爆发,因此在监控中应特别关注丢包率的突变拐点。
问:视频会议丢包率多少会卡顿?
答:没有绝对统一阈值,取决于视频编码方式、缓冲策略和接收端算力,使用前向纠错的会议系统通常可容忍较大比例的瞬时丢包,而依赖重传的系统在相同丢包率下更容易出现画面冻结,实践中建议以丢包率持续超过预设网络冗余度且持续5秒以上为卡顿预警线。
问:为什么丢包率不高却依然卡顿?
答:可能是丢包的分布形态呈突发性,比如1秒内连丢10个包比10秒内分散丢10个包对卡顿的影响大得多,路由器缓冲区膨胀也会造成延迟剧烈波动,即使最终没有丢包,到达顺序错乱加上缓冲区清空同样会触发卡顿,数据包到达间隔不均比丢包更隐蔽,也更考验网络评估模型的准确性。
网络质量优化的本质,就是在丢包与卡顿之间那层薄薄的缓冲区间里做权衡。降低卡顿率不必追求零丢包,而是让缓冲策略、编码冗余与当前丢包率匹配,使丢包的影响在到达用户屏幕之前就已被消化。 把这条传导链看透了,排障的思路自然会从“哪里卡查哪里”升级为“从丢包源头到播放末端的全链路治理”。