医学影像三维重建对图形算力的消耗,远不止渲染那一瞬间的显卡占用,真正的隐性成本藏在数据预处理、动态交互和重复计算中,其中大部分算力被浪费在了看不见的地方。
现代影像科医生面对的不再是单纯的一张张CT断层图,而是一个可以旋转、切割、测量的三维数字模型,一个看似流畅的骨骼重建操作,背后是工作站每秒数十亿次的浮点运算,当医生移动鼠标让模型转动一个角度,系统需要重新计算深度缓冲、光照映射和遮挡关系,这些动态过程对算力的消耗是持续性的,而非一次性爆发。
隐性消耗藏在哪里:算力并未消失,只是用在了别处
数据加载与格式转换:被忽略的“第一道关卡”
医院里每天产生的原始影像数据,动辄数百GB甚至上TB级别,DICOM格式的原始文件包含了大量元数据信息,直接送入GPU渲染几乎不可能,系统必须先将DICOM数据解码为像素矩阵,再重建为体素场,这个过程中内存带宽和CPU占用率会飙升。
行业共识认为,一套标准的三维重建流程中,数据预处理阶段消耗的时间占比高达40%左右(据医疗信息化行业公开资料),可惜大多数情况下,医院采购硬件时只盯着显卡型号,却忽视了内存通道带宽和硬盘读取速度,结果就是显卡性能再强,也被慢吞吞的数据传输拖了后腿,这就是典型的隐性算力瓶颈。
动态交互的连发计算:GPU在你看不见时满负荷运转
医生操作三维模型时,每一个微小的视角变化都会触发一次完整的重投影计算,以MIP(最大密度投影)为例,算法需要沿视线方向遍历所有体素并找出最大值,一次计算量就能轻松达到数百万次遍历,当你旋转模型时,表面看GPU负载率只有60%,实际上它在持续调用着色器单元执行像素级运算,显存带宽被大量占用,而这种状态会持续数小时。
部分医学影像三维重建慢是什么原因?极大概率不是渲染慢,而是交互响应链路太长,从鼠标输入、CPU计算变换矩阵、更新显存数据、GPU重绘到屏幕输出,任何一环出现延迟都会让医生感觉“卡顿”,但任务管理器里看起来一切正常。
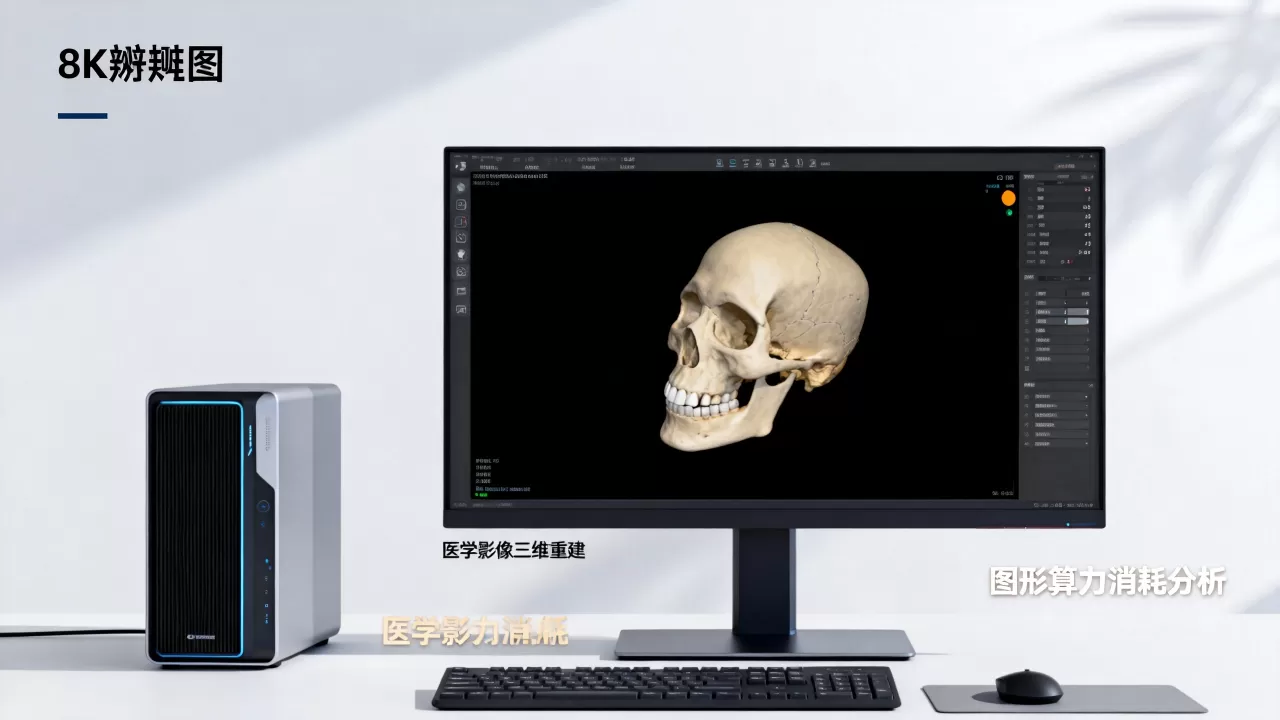
分割与标注的重复迭代:算力的“隐形黑洞”
三维分割是重建流程中计算量最大的环节,却最容易被误认为“只是点几下鼠标”,实际上一套精准的器官分割,需要算法运行数十轮阈值迭代和形态学操作,每次操作都要重新读取体素数据、生成蒙版、更新显示效果,对于肝脏这样的大器官分割,单次计算就可能消耗数GB显存带宽。
哪些工作习惯会让显卡“白干活”:退化场景实拍
默认开启实时滤波:让GPU持续空转
影像工作站默认开启的平滑滤波、边缘增强等功能,会触发GPU执行额外的卷积计算,每次卷积核计算都需要遍历周围邻域的体素数据,计算量按核尺寸呈指数增长,如果医生不主动关闭这些效果,GPU就会持续执行大量无效计算,造成明显拖慢。
医学影像三维重建工作站配置再高,也难逃这类无效消耗的拖累,比较实际的验证办法是:在操作软件中临时关闭“实时体绘制优化”和“自动降噪”选项,对比操作流畅度,差异会非常明显。
体素精度设定过高:追求用不上的“超清”
很多技师习惯把重建分辨率设为最高档,实际上对于常规诊断而言,512×512×512的体素矩阵已经足够,把精度提升到1024³,意味着数据量膨胀为原来的8倍,内存占用、显存传输量、计算量全部呈立方级增长,但对诊断准确率几乎没有任何提升,这种无意义的高精度需求,正是三维重建对图形算力隐性消耗的重要来源之一。
三维重建的真实算力分配:一张表看懂钱花哪了
为了理解算力去向,援引医疗影像工作站性能评测中的典型数据分布(据行业技术白皮书):
| 计算阶段 | 占用算力比例 | 主要硬件压力点 |
|---|---|---|
| DICOM解码与数据导入 | 15% | CPU、内存带宽 |
| 体素化与梯度计算 | 25% | CPU、系统内存 |
| 实时体绘制/面绘制 | 30% | GPU、显存带宽 |
| 交互响应与变换计算 | 15% | CPU、GPU协同 |
| 分割算法迭代 | 15% | GPU通用计算单元 |
可见,真正用于屏幕渲染显示的GPU直出计算只占到三成左右,剩下七成算力消耗在准备、处理和支持环节,很多人最初考虑医学影像三维重建工作站价格时,只把预算砸在高端专业显卡上,忽略了CPU核心数、内存频率和硬盘阵列的均衡搭配,结果工作站整机价格不低,但实际使用体验并不理想。
硬件选择的避坑思路:这几种配置更合理
别迷信顶级显卡,显存容量更关键
三维重建的核心瓶颈通常在于显存容量而非计算核心数,体素数据、顶点缓冲、纹理缓存全都占据显存空间,当数据量超过显存容量时,系统会触发显存溢出,转而调用系统内存充当临时缓冲,性能直接急剧下滑,适合三维重建工作的显卡,核心频率和CUDA核心数只是基础参考,至少12GB起步的显存容量才是硬性门槛。
内存通道比内存容量更值得关注
在数据预处理阶段,工作站表现高度依赖内存读取速度,四通道内存架构比双通道在体素读取场景下有相对明显优势,这两者的价格差在整机预算中占比极低,但对流畅度影响很大,业内人士普遍认为,与其多花资金提升显卡档次,不如优先保证内存通道数量。
存储介质决定你的启动速度和操作体验
三维重建项目加载或保存动辄数个GB的工程文件,传统SATA固态硬盘的传输带宽会成为明显短板,NVMe协议的企业级固态硬盘,顺序读写速度能达到传统SATA固态的数倍,直接缩短打开和保存三维模型的时间,部分医院影像科围绕PACS系统三维重建应用进行升级时,最先更换的硬件就是存储设备,效果立竿见影。
医学影像三维重建为什么卡:常见瓶颈归纳
- 体素分辨率设置过高:超过实际诊断需求,白白增加几倍计算量
- 实时渲染算法效率低:部分软件使用光线投射算法但未启用空域跳跃优化
- 缓存机制失效:每次操作都重新计算而非调用已有缓存结果
- 多任务并行冲突:后台PACS系统传输数据与三维渲染争抢磁盘带宽
- 驱动版本滞后:专业软件对显卡驱动有特定版本要求,升级不及时会掉帧
未来的优化方向:把消耗放在刀刃上
AI辅助分割和光线追踪硬件加速正在改变算力消耗格局,借助深度学习模型,原本需要数十次迭代的器官分割可以压缩到一次推理完成,大幅削减重复计算,新一代专业显卡内置的光线追踪核心,也能让体绘制中的光照计算效率提升相对明显。
对医院而言,选型评估时不应只看单一指标的标称值,而是要围绕具体临床场景做全流程测算,一套成熟的三维重建方案,需要让数据读取、预处理、分割重建、动态渲染各阶段的算力投入与临床需求精准匹配。
三维重建工作站采购与配置常见疑问解答
医学影像三维重建工作站价格区间大概在什么范围?
基础入门级配置通常在3-5万元,能满足常规CT和MRI数据的三维浏览需求,中高端配置在8-15万元区间,用于复杂手术规划、多模态影像融合等场景,价格差距主要取决于显卡显存容量、CPU核心数和内存通道数量,并不完全代表临床适用性,最终还是要回到使用场景来评估匹配度。
医院现有PACS系统可以直接做三维重建吗?
部分PACS系统内置了基础三维浏览模块,但功能较为基础,通常只支持简单的MPR、VR显示,无法完成精细分割和定量分析,独立的三维重建工作站搭配专业软件才是目前的主流做法,通过院内局域网从PACS调取影像数据,在本地完成高精度重建和处理,这套流程在多数三甲医院已经非常成熟。
三维重建对显卡的要求和玩游戏比有什么不同?
游戏渲染追求的是实时光照和精美画面,更看重GPU计算核心数量和频率,三维重建则更依赖显存容量、精度稳定性以及专业软件驱动的兼容性,消费级游戏显卡在长时间高负载运行时容易降频,影响操作稳定性,而专业级显卡具备ECC显存纠错能力和更严格的散热设计,更适合医学影像场景下连续数小时的持续运算,选择专业卡是在当前医疗信息化建设中的主流做法,这一点与其他工业视觉应用领域保持了一致。