三维渲染节点持续运行的稳定与否,温度管理是决定性因素,核心思路一句话:把进风温度压在25°C以下、把GPU核心温度控制在83°C以内,并让降频策略可预期。
三维渲染节点温度过高怎么办:先搞清持续运行的三个热源逻辑
渲染节点与普通工作站的散热逻辑有本质区别,普通工作站跑满GPU十分钟可能就渲染完了,而三维渲染节点往往要连续满载跑几十个小时甚至一周。持续运行意味着热量不是脉冲式累积,而是稳态累积,如果散热系统的排热能力刚好等于产热能力,温度曲线就会缓慢爬升,直到触碰到降频墙。
多数情况下,节点温度失控不是风扇坏了,而是热量在机柜内部形成了热回流。行业共识认为,机柜内冷热通道隔离不到位,比风扇故障更致命,渲染农场常见的部署方式是两台节点背对背放在开放机架里,前面前脸进风,后面尾部排风,如果机柜间距小于1米,后排节点排出的热风直接被打进前排节点的进风口,温度会以每半小时1-2°C的速度爬升,最终稳定在一个危险的高位。
识别温度曲线的三种形态
持续运行中的温度走势暴露真实瓶颈,通过远程管理卡连续观察48小时,温度曲线通常呈现三种形态:
- 水平直线型(优良):满载后30分钟内达到平衡温度,波动范围在±3°C以内,说明散热系统的排热能力与GPU的发热功率匹配度好。
- 锯齿爬坡型(隐患):温度每6-8小时出现一次阶梯式上升,然后缓慢回落,这通常指向散热鳍片积灰,或者环境温度随白天夜晚波动过大。
- 持续上升型(危险):温度从满载开始就没有停止过上升,直到撞上降频墙。这种情况必须立即停机检查热管接触面,多数情况下是硅脂干裂或者均热板失效。
GPU渲染温度多少正常:不同负载场景下的安全阈值
明确温度阈值之前要区分两种温度:核心温度(Tjunction)和显存温度,很多运维人员只盯着核心温度,忽视了显存结温,实际上在多帧连渲场景中,显存Tjmax往往比核心更早逼近极限,尤其在使用大场景文件时。
核心温度的安全区间划分
按照NVIDIA官方公开的硬件规格和行业运行惯例,温度阈值可以划分为以下区间:
| 温度区间 | 运行状态 | 建议动作 |
|---|---|---|
| 60°C以下 | 低负载或待机 | 正常 |
| 60-75°C | 满载渲染的健康区间 | 无需干预 |
| 75-83°C | 满载运行的警戒区间 | 检查机柜进风温度 |
| 83-90°C | 降频临界区 | 优先降低环境温度 |
| 90°C以上 | 严重过热 | 立即停机排查 |
显存温度为何更值得关注
业内专家指出,显存结温超过95°C时,ECC纠错频率会明显上升,这意味着渲染画面虽然不一定会崩溃,但计算效率会打折扣,个别帧可能出现不明原因的噪点,对于追求渲染效率的团队来说,显存温度比核心温度更值得监控。
实际运维中,核心温度75°C、显存温度已经88°C的情况相当常见,两者之间的差值超过15°C时,就要警惕散热垫老化问题,散热垫的导热系数会随时间衰减,这是影响显存温度的最大隐形杀手。
三维渲染服务器散热方案对比:风冷、水冷与机柜级改造的取舍
不少团队在散热方案选择上陷入误区直接把渲染节点丢进机房就不管了,实际上针对持续运行的渲染节点,散热方案的选择应该遵循“先环境、后设备、再改造”的顺序。
环境级改造:成本最低的效果提升
在设备不变的情况下,环境级改造能解决80%的高温问题,具体步骤如下:
- 封闭冷通道:在机柜前方安装盲板,隔离冷热区,防止后排热风短路回流,这几乎是性价比最高的改造。
- 调整机房空调送风温度:将空调出风温度从默认的18°C调整为20-22°C,湿度控制在40%-60%之间,过低的送风温度会导致冷凝水析出,反而损坏硬件。
- 检查地板下送风压力:高架地板送风机房,静压不足是常见问题,用手背贴近地板通风口,如果感觉不到明显气流,说明送风压力不够,需要检查风机转速或通风口开孔率。
设备级调整:风冷系统的优化空间
对于大量使用风冷的渲染节点,简单的设备级调整就能收到明显效果:
- 优先使用涡轮风扇版GPU型号,这类显卡将热风直接排出机箱后部,不会在机箱内部形成热涡流。
- 机箱内部的风道需要形成直线,从前进后出,如果机箱前部装了多个硬盘占满风道位置,GPU的进风量会显著下降。
- 定期清理PCIe挡板附近积灰,这是最容易堵住出风口的区域。
水冷方案的真实现状
水冷在渲染农场的普及率并不高,虽然水冷能有效降低GPU核心温度,但持续运行场景下它带来的风险大于收益。水泵故障是水冷系统的最大隐患,一个水泵停转会瞬间让节点温度在几分钟内突破90°C,风冷即使风扇故障,GPU也会先降频保护,留给运维人员反应时间更长。
如果坚持采用水冷方案,务必配置漏水检测线,并设定水泵转速监控告警阈值低于正常值的20%。
渲染农场降温方案怎么选:根据节点数量和机房条件决定
不同规模的渲染任务对温度管理的需求差异很大,团队在选择降温方案时,最核心的决策因素是电力成本与停机成本的平衡。
小规模集群(10-20节点)
这个规模的渲染节点通常放在公司内部机房或甚至办公室角落,温度管理的关键在于
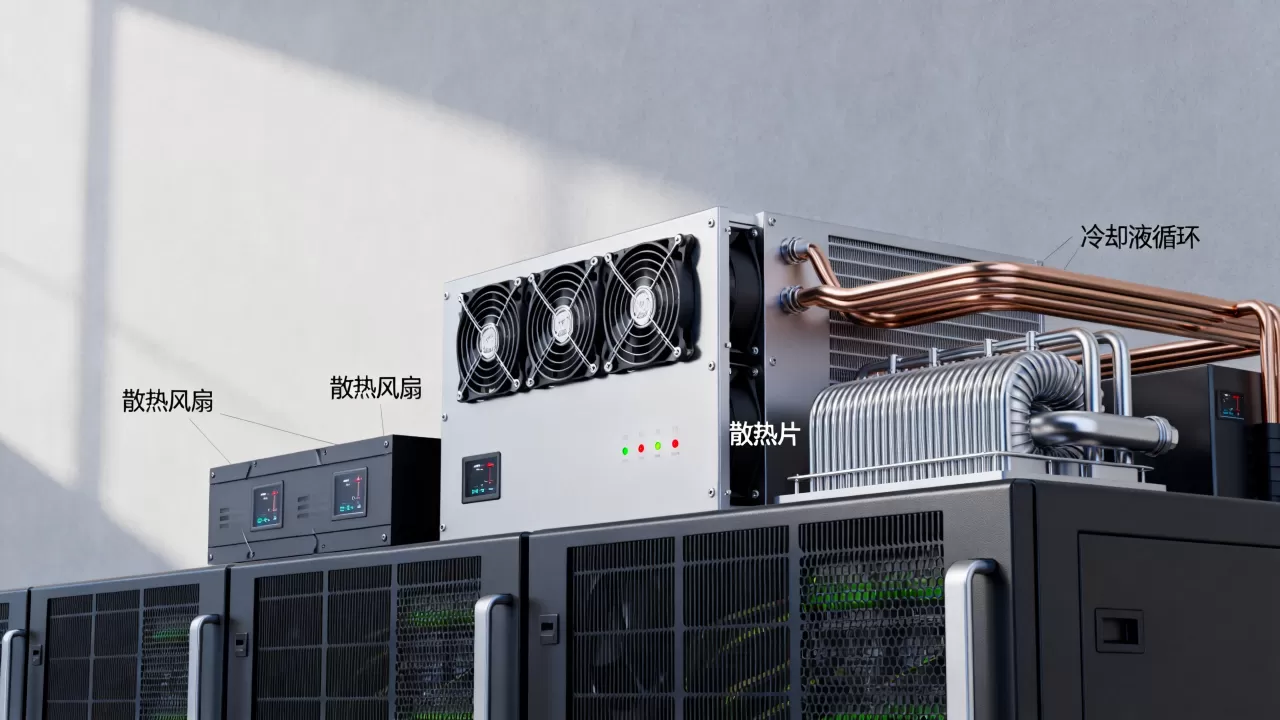
避免与办公空调共用出风口,办公空调的恒温逻辑是为人的舒适度设计的,白天制冷夜间停机,渲染节点全天满载运行,夜间空调停机后温度会快速攀升。
- 建议配置独立的分体式空调,并设置温度联动开关,当机柜温度超过28°C时,空调自动启动制冷。
- 办公室环境需要特别注意灰尘问题,地毯纤维和人体皮屑会迅速堵塞散热鳍片,建议在机柜进风口加装防尘棉,每两周更换一次。
中大规模渲染农场(50节点以上)
大型渲染农场通常托管在专业IDC机房,这时需要考虑的是机柜功率密度与空调制冷量的匹配问题,一个标准42U机柜满载GPU服务器时,功率密度接近15-20kW/机柜,远超传统IDC机房单柜8kW的设计标准。
- 选择经过高功率密度改造的机房,确认制冷方式是否为房间级制冷加冷热通道封闭。
- 部署位置应尽量均匀分布在机柜内,避免所有高功耗节点集中在同一排,造成局部热点。
- 按季度检查空调滤网是必备动作,空调滤网被灰尘堵塞后,制冷量下降幅度可能高达40%。
持续运行场景下的温度监控自动化
长期运行的渲染节点必须建立自动化的温度监控体系,人工巡检的频次和精度都不足以应对温度的突变情况,常用的监控工具有:
基础监控命令与工具链
- nvidia-smi dmon:实时查看GPU温度、功耗、风扇转速和利用率,输出格式适合脚本解析。
- ipmitool sdr list:读取主板传感器数据,包括CPU温度、主板温度和进风口温度。
- Prometheus + node_exporter + nvidia_gpu_exporter:开源的监控组合方案,支持温度数据的持久化存储和告警。
- 每隔5分钟采集一次温度数据,低于这个频率难以捕捉温度爬升的早期信号。
告警阈值与自动化响应策略
合理的告警配置应该分三级,每一级对应不同的响应动作:
- 一级告警(85°C):发送告警通知,并触发机房门禁处声光报警,提醒现场运维人员检查空调运行状态。
- 二级告警(88°C):自动将对应节点上的渲染任务暂停并迁移到空闲节点,同时强制降低GPU功耗上限至80%,可通过
nvidia-smi -pl命令设置功耗目标值。 - 三级告警(92°C):自动调用远程管理卡执行节点强制关机,防止硬件损坏。
常见问题排查实操:按优先级逐层检查
遇到渲染节点温度异常升高,按照以下步骤逐层排查可以快速定位问题,节省大量时间:
- 查看实时风速和风扇转速
nvidia-smi -q -d FAN确认风扇实际转速与设定值是否一致,转速为0说明风扇控制策略异常或风扇损坏。 - 检查进风口温度使用温度计测量机柜前门进风温度,如果进风温度已超过26°C,问题大概率出在机房空调而非节点本身。
- 检查散热鳍片积灰情况用手电筒照射显卡尾部散热鳍片,如果透光率明显降低,说明积灰严重需要清理。
- 检查硅脂状态拆卸散热器检查GPU核心与散热器底座的接触痕迹,如果硅脂干裂呈粉状,需要重新涂抹,建议选择导热系数在6-8 W/mK之间的硅脂。
- 确认风扇朝向部分工包显卡风扇有正转和反转版本,装反后风扇有转速但风量几乎为零,这个细节验证起来最容易被忽略。
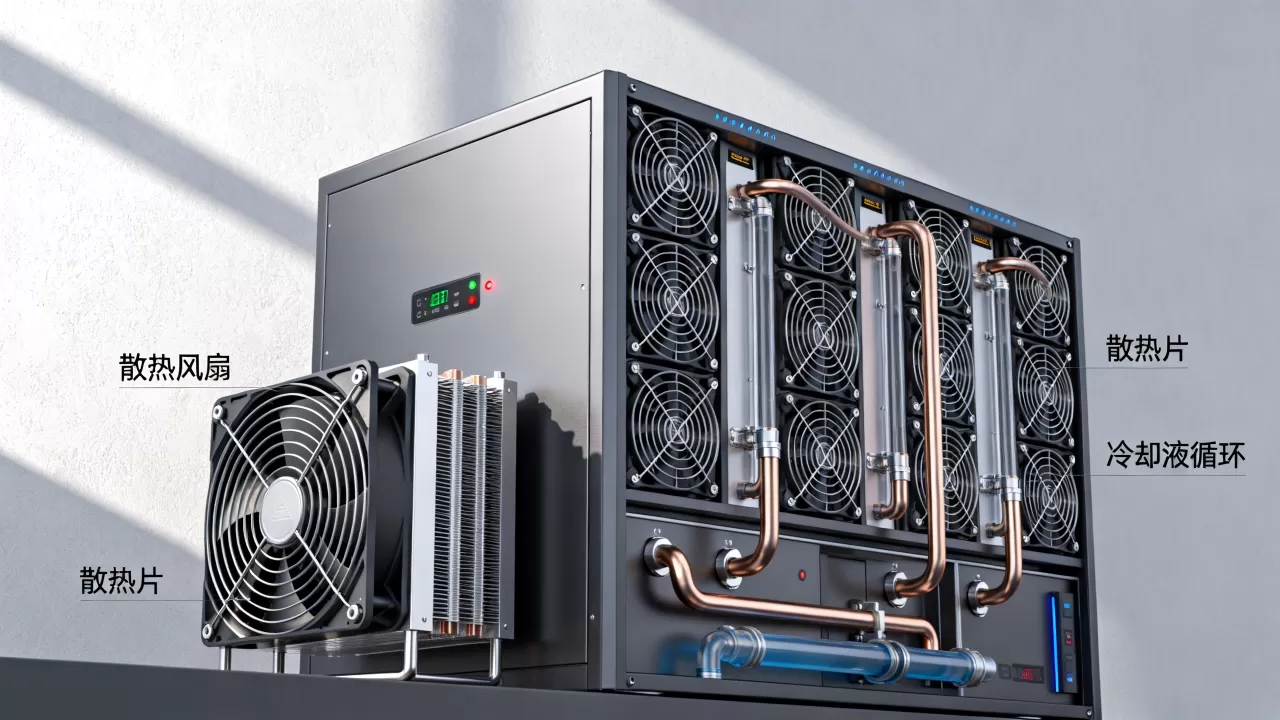
长期运行的温度漂移与季节性维护节奏
渲染节点的温度表现会随时间推移逐步劣化,这是一种正常的物理现象。运行半年的节点比新部署时温度高5-8°C属于正常的性能衰减范围,建立季节性维护节奏能有效延长设备寿命:
- 每季度:清理一次进风口防尘网,检查风扇轴承是否有异响。
- 每半年:彻底清理显卡散热鳍片,重新涂抹硅脂。
- 每年:检查散热垫是否需要更换,观察显存温度对比同类新设备的温差是否超过10°C。
三维渲染节点温度管理相关问答
渲染节点温度过高会导致渲染结果出错吗?
会,但不一定以程序崩溃的形式体现,温度过高触发降频后,渲染速度明显变慢,但画面本身通常不会产生错误,真正危险的是显存ECC纠错在高温环境下频繁生效,极个别情况下会产生细微的花屏或噪点,对于动画序列帧,这种瑕疵一旦渲染完成很难发现,返工成本极高。
水冷渲染节点与风冷渲染节点在持续运行中哪个更可靠?
从长期持续运行可靠性角度看,风冷更稳定,风冷系统结构简单,单点故障影响面小,GPU自带降频保护来兜底,水冷效率高但依赖水泵持续运转,水泵寿命、水管渗漏和冷却液蒸发都是潜在风险,多数渲染农场在7×24小时运行场景下更青睐风冷加高风压机箱的组合方案。
室内开放式机架放置渲染节点时风扇朝向如何设计?
开放式机架没有机柜门的导流作用,应遵循统一朝向原则,所有节点从正面进风,背面排风,保持同一排机架的风向一致,避免相邻节点采用背对背放置,否则排出的热风会直接进入另一排节点的进风口,如果空间有限必须背对背放置,中间需要留出至少60厘米的间隔,或加装隔风板引导热气流向上排出。
持续运行的温度管理本质上是对热量产生、传导、排出全链路的管控,核心观点再强调一次:控制进风温度在25°C以下,保持显存温度不超过90°C,把降频之前逐级告警和自动化响应的机制跑通,三维渲染节点的长期稳定运行就是可预期、可管理的结果。