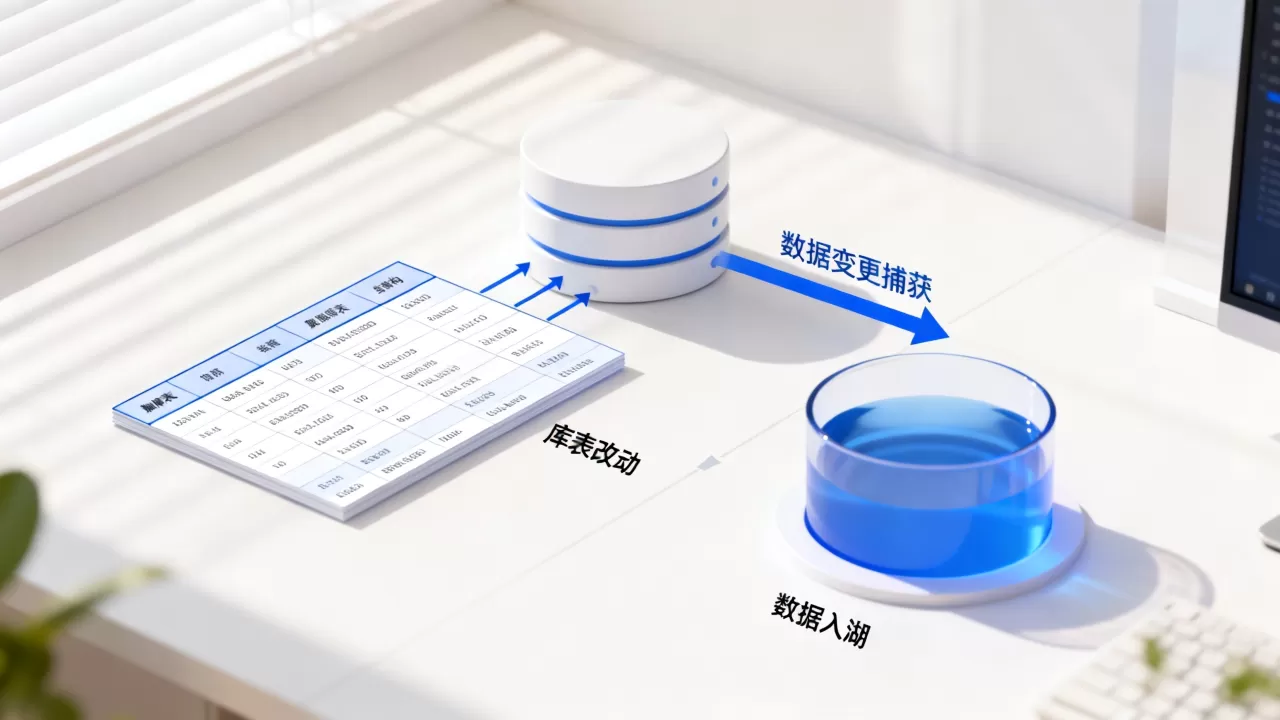
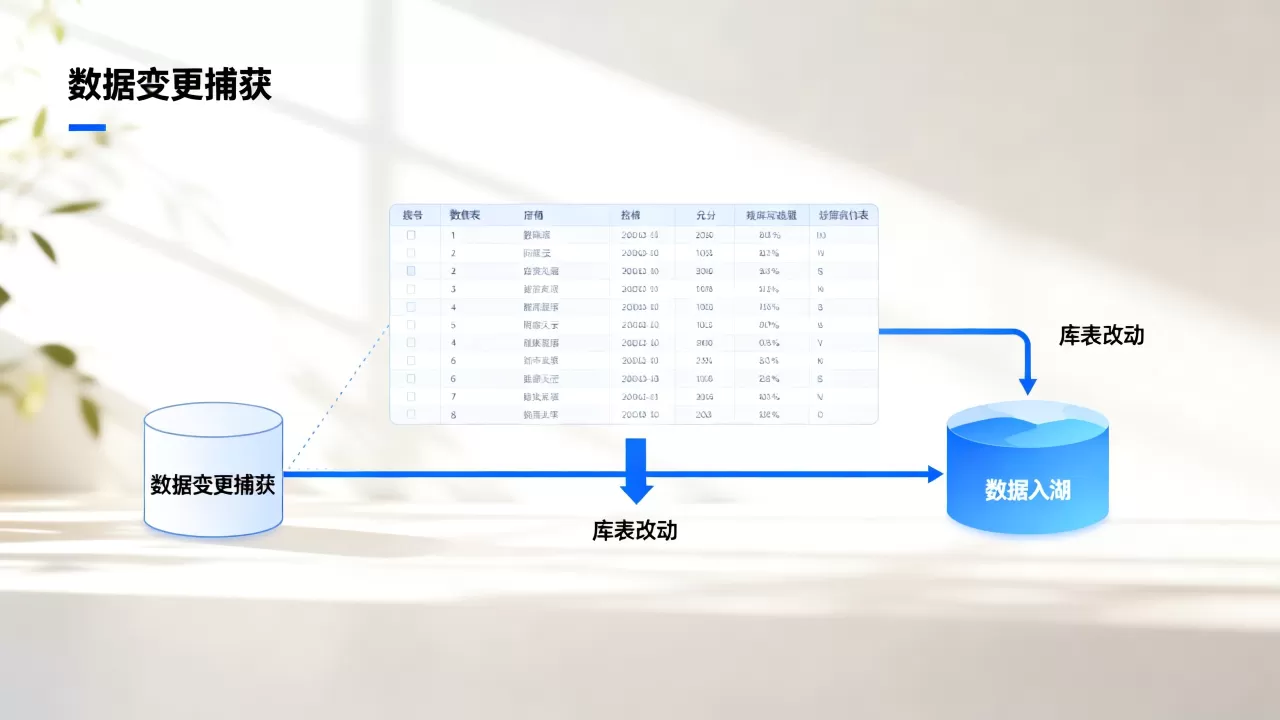
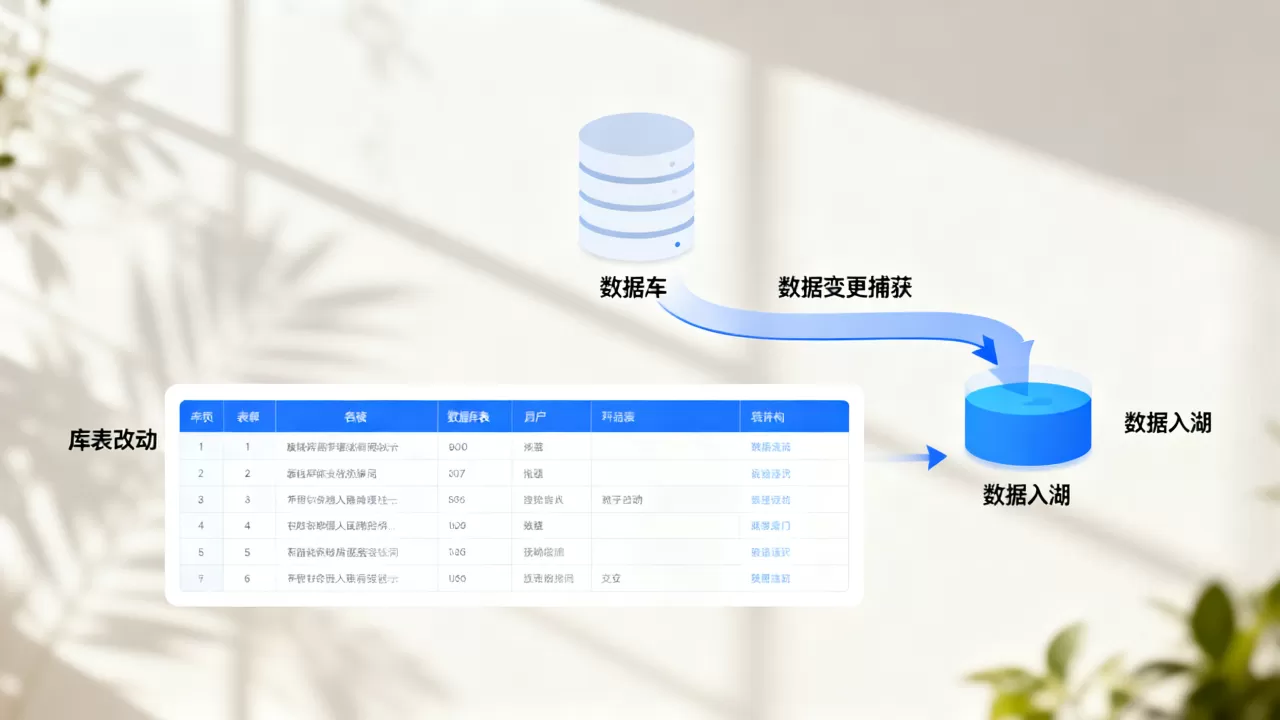
数据集成可用变更捕获把库表改动实时同步入湖,核心做法是用CDC组件监听数据库日志,把insert、update、delete解析成流式事件,再经Flink等引擎写入Iceberg、Hudi湖表,实现库表改动秒级或分钟级进入数据湖。
为什么变更捕获是实时入湖的刚需
传统数据集成大多走批量抽取,每天凌晨用Sqoop或DataX把业务表全量拉到Hive,这个模式有几个硬伤。
- 延迟高,白天产生的订单,第二天才能分析。
- 源库压力大,全量扫描会占用大量IO,影响在线业务。
- 重复搬运,未变化的数据每天都要拉一遍。
变更捕获换了一条路,它只读取数据库日志,MySQL的binlog、PostgreSQL的WAL、Oracle的Redo Log,本身记录了每一次增删改,CDC组件把自己伪装成数据库的从库,持续消费这些日志,源库不需要执行全表扫描,只把日志流推出来,这样既降低源库压力,又能做到低延迟。
一个常见场景是北京某电商团队做实时大屏,订单表在MySQL里频繁写入,团队需要把这些订单变更实时同步到数据湖,供Flink SQL做聚合,批量抽取做不到,CDC可以。
数据库实时同步入湖方案:变更捕获到底怎么落地
要把库表改动实时同步入湖,整条链路可以拆成四段。
- 源端:MySQL、PostgreSQL、Oracle、SQL Server等。
- 捕获层:Debezium、Flink CDC、Canal、Maxwell。
- 传输层:Kafka、Pulsar,或者直接由Flink消费。
- 入湖层:Iceberg、Hudi、Delta Lake,落在HDFS或对象存储。
多数生产方案不会让CDC组件直接写湖,中间会放一层Kafka,原因是Kafka能削峰、能回放、能解耦,CDC把变更事件写进Kafka,Flink或Spark再消费Kafka写入湖表,这样即使下游入湖任务挂了,变更事件也不会丢。
具体落地时,MySQL要先开启binlog。
[mysqld]
log-bin=mysql-bin
binlog_format=ROW
binlog_row_image=FULL
server-id=1
binlog_format必须设为ROW,STATEMENT模式只记SQL语句,无法准确还原每行变更,CDC需要ROW模式下的行前像和后像。
Flink CDC任务可以用SQL方式定义,下面是一个MySQL订单表同步到Iceberg的简化写法。
CREATE TABLE orders_source (
  id BIGINT,
  user_id BIGINT,
  amount DECIMAL(10,2),
  status STRING,
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'mysql-cdc',
  'hostname' = 'db.example.com',
  'port' = '3306',
  'username' = 'cdc_user',
  'password' = 'cdc_pass',
  'database-name' = 'trade',
  'table-name' = 'orders'
);
CREATE TABLE orders_lake (
  id BIGINT,
  user_id BIGINT,
  amount DECIMAL(10,2),
  status STRING,
  PRIMARY KEY (id) NOT ENFORCED
) WITH (
  'connector' = 'iceberg',
  'catalog-type' = 'hadoop',
  'warehouse' = 'hdfs://namenode:8020/warehouse'
);
INSERT INTO orders_lake SELECT  FROM orders_source;
这个任务跑起来后,MySQL里orders表每发生一次insert、update、delete,数据湖里的Iceberg表就会同步变化,Flink CDC会自动把update拆成delete加insert,把delete转成墓碑消息交给下游。
Flink CDC和Debezium哪个好:CDC组件选型对比
很多人在选型时都会问:Flink CDC和Debezium哪个好,这个问题没有绝对答案,要看团队技术栈和场景。
Debezium是独立的CDC引擎,它支持MySQL、PostgreSQL、MongoDB、SQL Server等,通常部署在Kafka Connect上,Debezium把变更事件写入Kafka,下游再用消费者处理,它生态成熟,社区活跃,适合已经重度使用Kafka Connect的团队。
Flink CDC是Flink社区推出的CDC连接器,它底层复用了Debezium的解析逻辑,但把捕获和计算合在一起,Flink CDC不用额外部署Kafka Connect,直接由Flink任务读取数据库日志,然后在同一个作业里做清洗、关联、入湖。
| 对比项 | Flink CDC | Debezium |
|---|---|---|
| 架构 | Flink作业内嵌 | Kafka Connect独立部署 |
| 依赖Kafka |
可不需要 |
通常需要 |
| 计算能力 | 强,SQL直接处理 | 弱,需下游系统处理 |
| 运维复杂度 | 较低 | 中等 |
| 多表整库同步 | 支持 | 需配置多个连接器 |
| 生态整合 | 与Flink生态天然集成 | 与Kafka生态天然集成 |
如果团队已经有Flink集群,主要做数据入湖,Flink CDC更省事,如果团队已有Kafka Connect体系,希望CDC事件能被多个下游复用,Debezium更合适,业内专家指出,Flink CDC正在成为实时入湖场景的主流选择,因为它缩短了捕获到计算的链路。
数据集成工具价格与自建成本怎么算
数据集成工具价格差异很大,开源方案本身不收费,但需要自己部署和维护,商业工具按链路数量、数据流量或订阅周期收费。
- 开源自建:Flink CDC、Debezium、Kafka、Iceberg全部开源,服务器、存储、人力是主要成本。
- 云上托管:简米云DTS、华为云DRS、酷番云DTS等,按同步链路和数据量计费,省运维但长期成本不低。
- 商业集成平台:Informatica、Talend等,功能全,授权费用高,适合预算充足的大型企业。
自建方案在北京、上海这类技术人才密集的城市比较常见,一个三人小组能维护数十条同步链路,商业工具更适合运维团队薄弱、希望开箱即用的企业,预算评估时,不能只看工具价格,还要算源库性能损耗、数据延迟带来的业务损失、故障恢复时间。
实时同步入湖实操步骤与调优
把库表改动实时同步入湖,除了上面MySQL到Iceberg的例子,还有几个实操要点。
- 全量加增量,首次同步先做全量快照,再跟进binlog增量,Flink CDC和Debezium都支持。
- 无主键表,CDC对无主键表的update处理较麻烦,生产环境建议给目标湖表建主键。
- DDL同步,MySQL加字段通常不会自动同步到湖表,需要维护Schema变更流程。
- 大事务,单个大事务可能产生海量变更消息,导致下游积压,可以选择拆分大事务或加大Kafka分区。
- 时区,数据库连接要显式指定时区,避免时间字段偏移。
- 监控,重点观察binlog偏移量、Kafka消费延迟、湖表写入成功率。
Flink CDC任务提交后,可以通过Flink Web UI查看source端延迟,延迟突然拉高,通常与源库大批量更新或网络抖动有关,调优时优先增加并行度,再检查Iceberg的写入策略,Iceberg默认按文件提交,频繁小文件会影响查询性能,可以设置定期合并。
数据集成可用变更捕获把库表改动实时同步入湖,不是简单地换一个同步工具,它改变的是数据供给方式,业务库的每一次增删改,都能在秒级或分钟级出现在数据湖里,选型时抓准两点:源库类型和团队技术栈,能用Flink CDC就不必引入Kafka Connect增加一层运维,能把链路跑顺,实时数仓和湖仓一体才有落地基础。
Q&A
数据集成可用变更捕获把库表改动实时同步入湖需要哪些组件?
最小配置源端只需要一个支持CDC的数据库,比如MySQL或PostgreSQL,中间用Flink CDC读取日志并写入Iceberg,若要解耦和缓冲,可以加一层Kafka,目标湖存储在HDFS、S3或OSS上,自建方案通常由数据库、CDC引擎、流处理平台、湖表格式和存储五部分组成。
Flink CDC和Debezium哪个更适合MySQL实时同步入湖?
如果下游已经有Flink SQL计算任务,Flink CDC更直接,它省去Kafka Connect部署,并且能在同一个作业里完成清洗和入湖,如果团队本身有Kafka集群,且变更事件需要被多个下游系统复用,Debezium更合适,两者对MySQL的支持都比较成熟。
数据集成工具价格一般是多少?
开源自建方案的工具成本为零,主要支出是服务器、存储和人力,云上托管工具按同步链路数量和数据流量计费,长期使用比一次性买断的授权模式更灵活,商业集成平台通常按项目或订阅报价,适合大型企业,最终成本取决于链路数量、变更速率和运维团队规模。